
OUI-1 로컬에서 돌리는 법
vLLM≥0.24 FP8로 thesysdev/OUI-1을 올리면 가중치 25.8 GiB이고, OpenUI 블로그 기준 RTX 5090 소비자 GPU 경로가 열린다. openui-lang 화면을 로컬에서 쓰려면 서빙·시스템 프롬프트 CLI·파서·렌더러를 한 세트로 맞춰야 한다.

핵심 요약 (TL;DR)
이 글은 받아서 자기 GPU에서 켜는 안내다. Thesys의 thesysdev/OUI-1은 Google diffusiongemma-26B-A4B-it를 LoRA로 파인튜닝한 뒤 병합한 체크포인트다. 총 26B / 활성 4B. openui-lang으로 UI 화면을 쓴다. Generative UI Benchmark 71.7%(132/184). 베이스 DiffusionGemma는 13.0%. 라이선스는 Gemma Terms of Use(Gemma 파생). 출시·벤치 해설은 TWMS 뉴스 글에 있고, 여기는 설치·서빙만 따라간다.
공식 카드가 권장하는 서버는 vLLM ≥ 0.24 + FP8이다. FP8 가중치는 25.8 GiB를 먹고, 나머지는 KV가 채운다. OpenUI 블로그는 소비자 GPU RTX 5090(FP8)에서 돌릴 수 있다고 적는다. Transformers ≥ 5.11 경로는 bf16 피크가 약 52 GiB라 A100 80GB·H100급이다. 일반 채팅 모델이 아니다. 출력은 openui-lang 파서로 검증한다.
용어를 한 번만 푼다. 디퓨전 언어 모델은 한 토큰씩이 아니라 256토큰짜리 캔버스를 노이즈에서 한꺼번에 다듬어 쓴다. openui-lang은 OpenUI의 선언형 UI 언어다. FP8은 8비트 부동소수점 양자화다. Ampere(A100)에는 네이티브 FP8이 없어 vLLM이 Marlin으로 가중치만 FP8로 올린다(메모리 절약은 되고, 연산 가속은 기대하지 말라는 카드 문구).
배경 및 맥락
OUI-1은 2026-09-08 OpenUI 블로그와 HF 카드로 공개됐다. 컨텍스트는 서빙 기준 16,384. 방식은 LoRA 파인튜닝 후 병합, bf16 safetensors. 샘플러는 체크포인트 것(엔트로피 바운드 0.1, 48 디노이징 스텝)을 쓴다. temperature·seed는 무시된다.
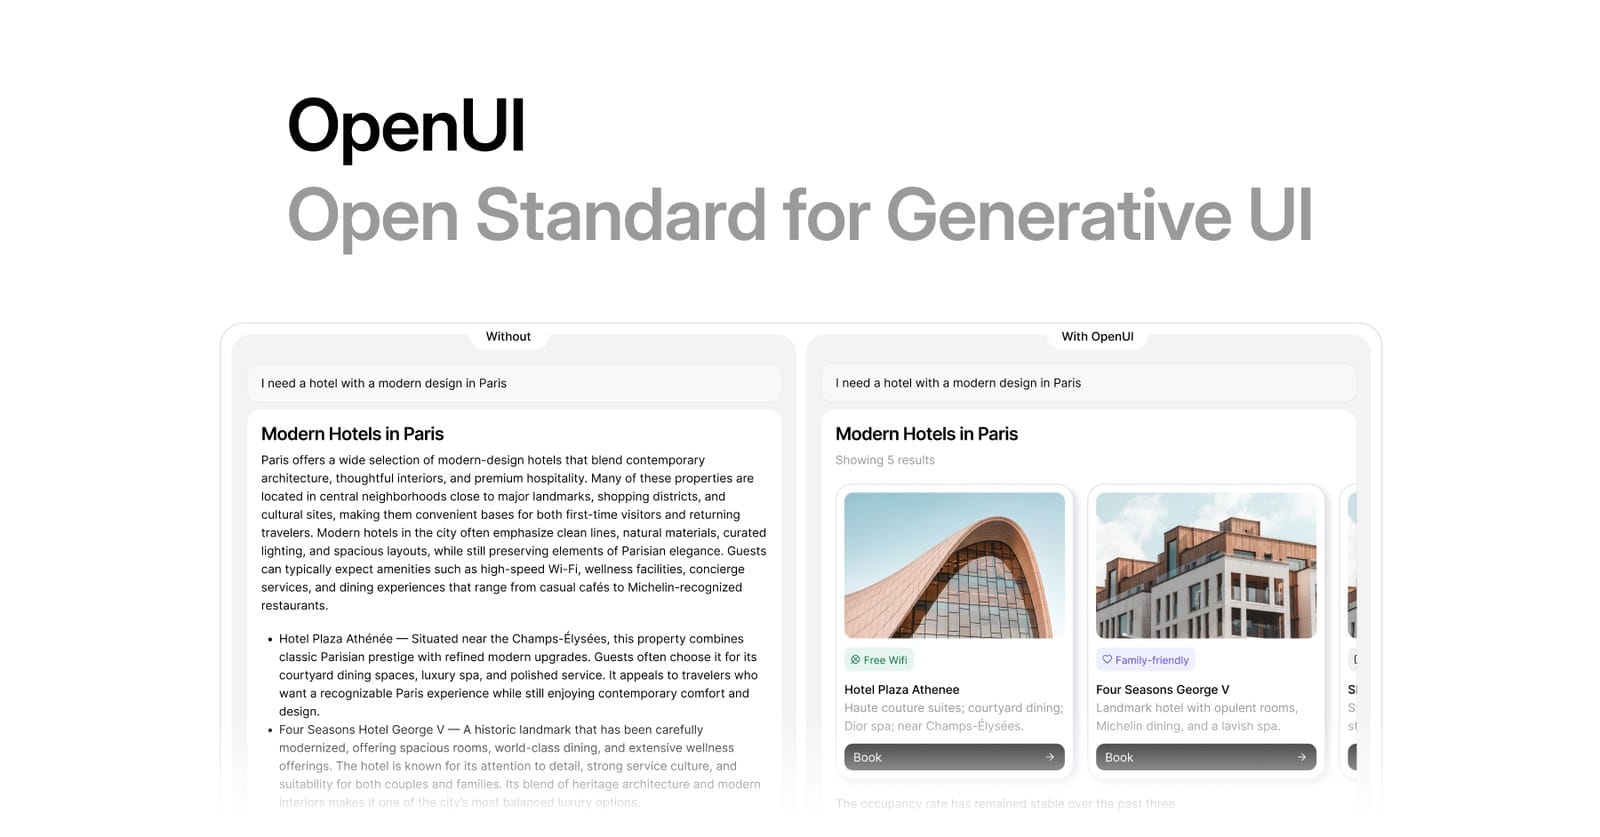
코드·렌더러·CLI는 thesysdev/openui에 있다. 시스템 프롬프트는 컴포넌트 라이브러리 시그니처에서 만들고, 응답은 React/Vue/Svelte 렌더러로 그린다. 이 글은 검색 의도(OUI-1 로컬)에 맞춰 vLLM 권장 경로 → OpenUI 프롬프트·렌더 → Transformers 대안 → 도구 호출 순으로만 적는다.
이걸로 할 수 있는 일
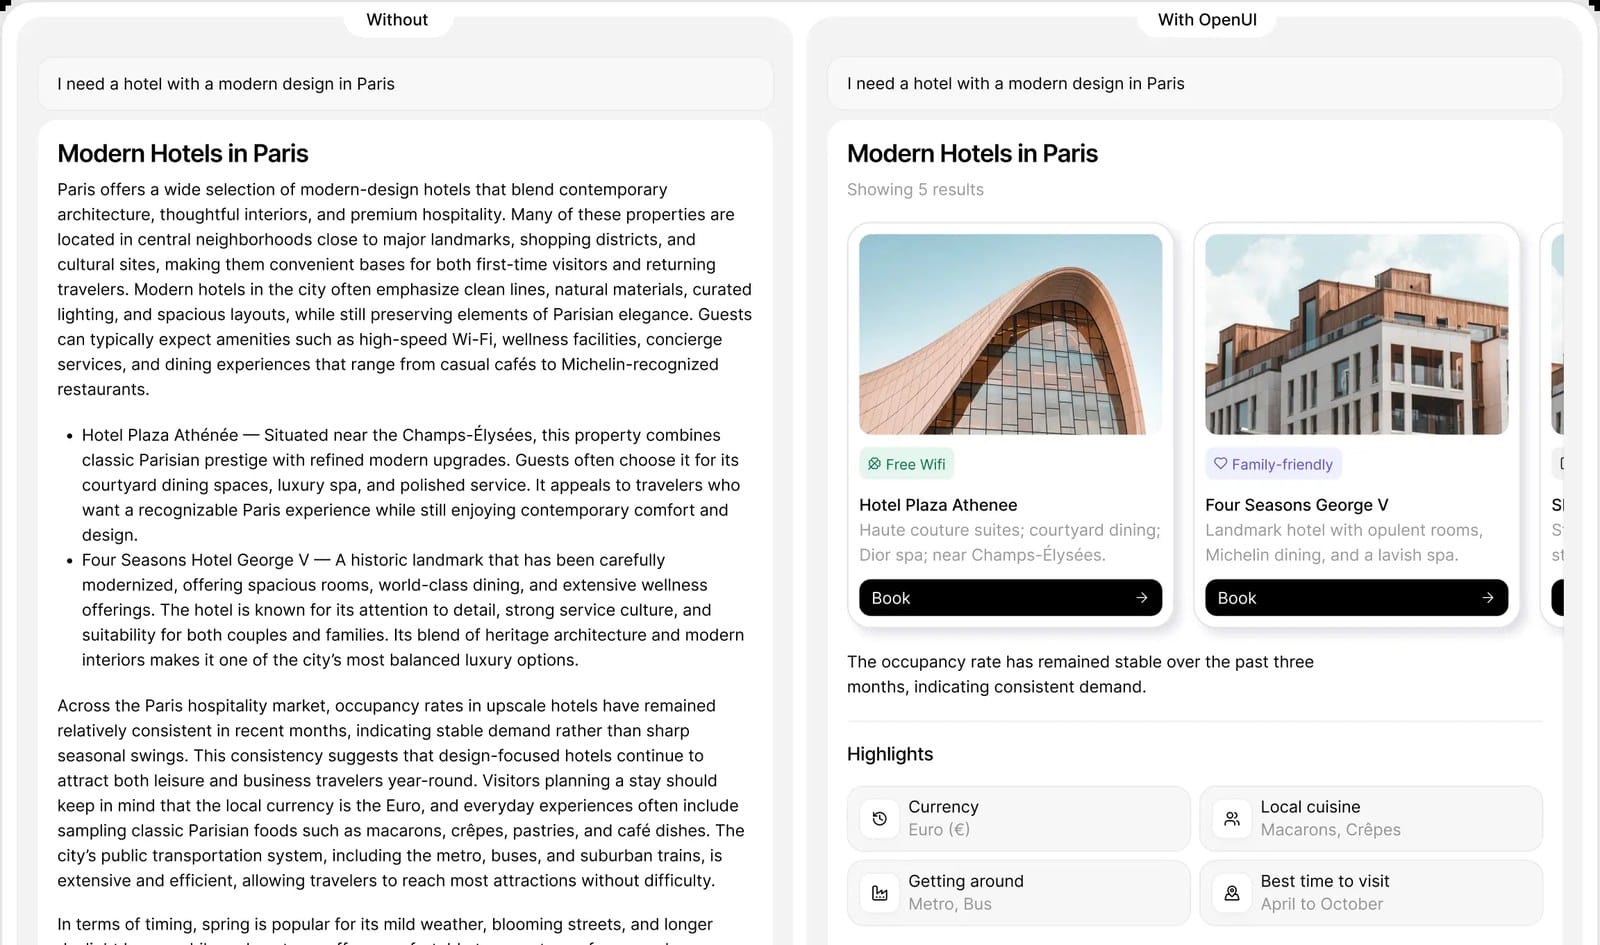
컴포넌트 라이브러리 시그니처를 시스템 프롬프트에 넣고, 평문 브리프를 주면 openui-lang 화면 코드가 나온다. 한 줄에 컴포넌트 하나, 루트에 배선된다. 지연이 중요한 OpenUI 앱·에이전트 UI를 로컬에서 만들 때 쓴다. 일반 Q&A 챗봇 대용은 아니다.
스트리밍은 stream=True로 켜면 256토큰 캔버스 단위로 도착한다. 벤치마크는 max_tokens 8192. 밴드 안 화면은 4096으로도 커버된다고 카드가 적는다. A100 80GB·vLLM 0.24 FP8·요청 1개·48스텝 기준 가벼운 화면 약 1초, 촘촘한 화면 3–6초(프롬프트 포함).
필요한 것
아래 표는 HF 카드·OpenUI 블로그에서 확인한 값만 넣었다. 없는 칸은 “문서에 없음”이다. VRAM GiB는 카드가 명시한 25.8(FP8 가중치)와 Transformers bf16 피크 ~52만 쓴다.
| 항목 | 공식 문서/저장소 | 비고 |
|---|---|---|
| 모델 ID | thesysdev/OUI-1 | Gemma ToU · DiffusionGemma 26B-A4B-it 파인튜닝 · 활성 4B |
| 컨텍스트 | 16,384 | 카드 “as served” |
| 벤치 | 71.7% (132/184) | 베이스 DiffusionGemma 13.0% |
| vLLM | vllm>=0.24 | 권장. FP8 가중치 25.8 GiB + KV |
| 소비자 GPU | RTX 5090 @ FP8 | OpenUI 블로그 문구 |
| Ampere(A100) | weight-only FP8 (Marlin) | 메모리 절약 O / 연산 가속 X |
| Transformers | transformers>=5.11 | DiffusionGemmaForBlockDiffusion 직접 import · bf16 ~52 GiB |
| 프롬프트 CLI | npx @openuidev/cli generate | 라이브러리.ts → system-prompt.txt |
| 렌더·검증 | @openuidev/react-lang · lang-core | Vue/Svelte 렌더러도 있음 |
| 도구 호출 | --tool-call-parser gemma4 | tool_choice는 auto 유지 |
단계: vLLM (권장)
카드 How to use의 권장 한 줄이다.
pip install "vllm>=0.24"
vllm serve thesysdev/OUI-1 --trust-remote-code --max-model-len 16384 --quantization fp8 \
  --served-model-name OUI-1 --max-num-seqs 4 \
  --enable-auto-tool-choice --tool-call-parser gemma4
샘플러·48스텝·캔버스 길이는 체크포인트 config.json / generation_config.json에서 온다. 벤치 숫자는 이 커맨드(vLLM 0.24, FP8, 48스텝)로 잰 것이다. GPU를 나눠 쓰면 --gpu-memory-utilization을 낮춘다. 가중치 25.8 GiB 위에 KV가 붙는다.
디노이징 스텝을 바꾸려면:
--diffusion-config '{"canvas_length":256,"max_denoising_steps":32}'
카드 기준 32와 48은 벤치 점수가 같고, 16은 레퍼런스 그래프를 깨뜨린다. --hf-overrides의 diffusion_max_denoising_steps 같은 키는 읽히지 않는다.
OpenAI 호환 호출 예(카드 그대로, 시스템 프롬프트 파일 가정):
from openai import OpenAI

client = OpenAI(base_url="http://localhost:8000/v1", api_key="local")
system = open("system-prompt.txt").read()
brief = """Status page for the platform team. Build a single screen for this. It must show:
1. current uptime percentage for the API this month
2. a short note on the most recent incident and when it was resolved
Cover every numbered item."""
r = client.chat.completions.create(
    model="OUI-1",
    messages=[{"role": "system", "content": system}, {"role": "user", "content": brief}],
    max_tokens=4096,
    stream=False,
)
print(r.choices[0].message.content)
temperature와 seed는 무시된다. 같은 요청도 문장이 달라질 수 있다. stream=True면 256토큰 캔버스 단위로 온다.
단계: OpenUI 프롬프트·렌더
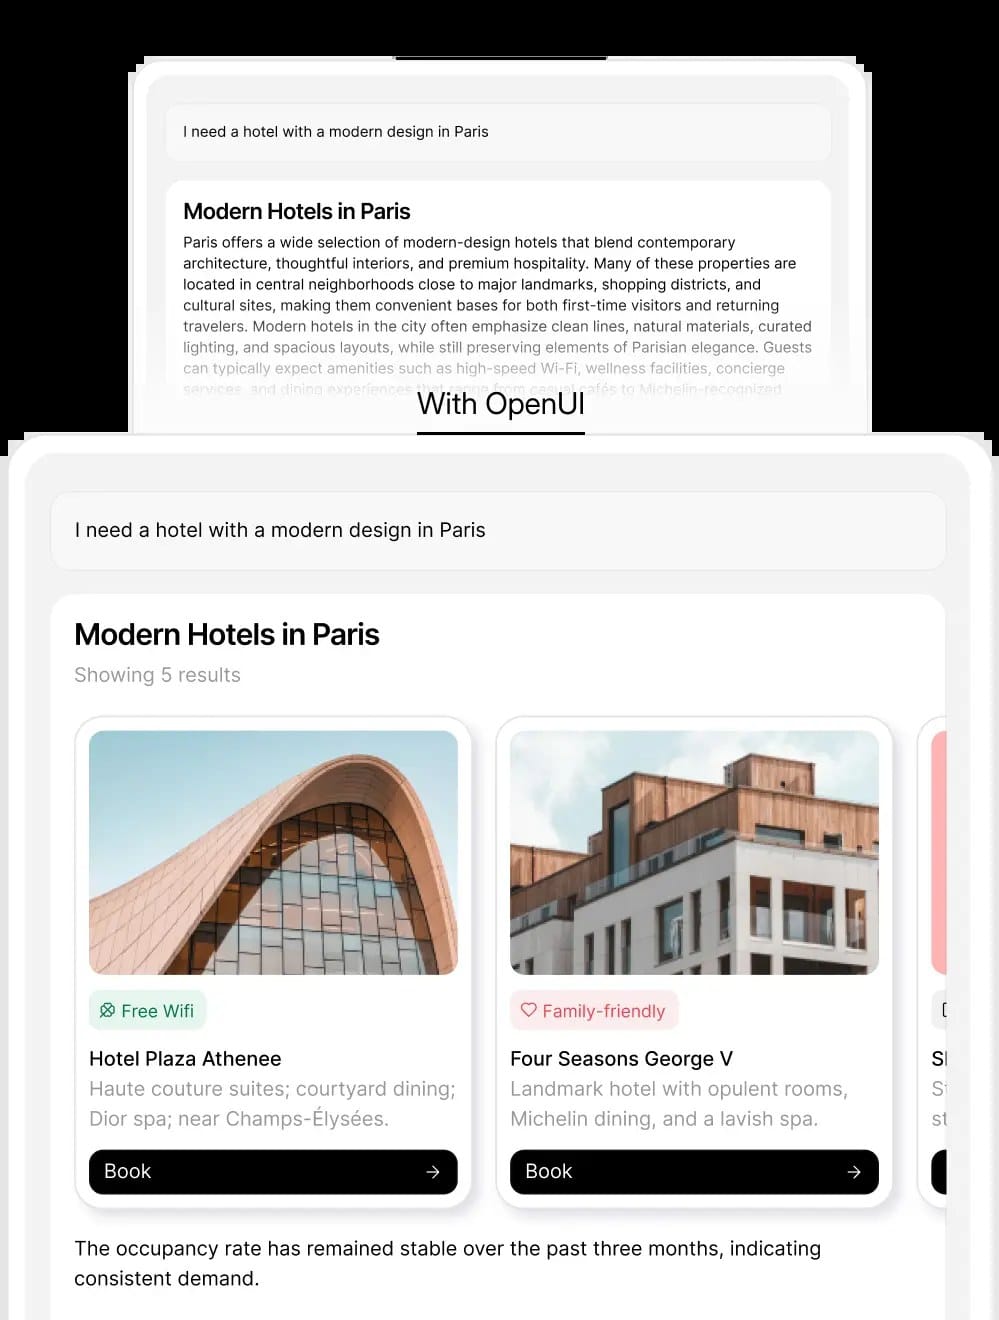
모델은 시스템 프롬프트에 들어 있는 컴포넌트 시그니처를 읽고 openui-lang 프로그램을 낸다. 내 라이브러리용 시스템 프롬프트는 CLI로 만든다.
npx @openuidev/cli generate <library.ts> --out system-prompt.txt
벤치 레퍼런스 프롬프트만 먼저 써 보려면 generative-ui-bench의 protocols/openui/prompt.ts를 쓴다. 렌더는 @openuidev/react-lang(Vue·Svelte도 있음). 검증은 @openuidev/lang-core. 파서가 통과한 뒤에만 UI로 올린다. 카드 Intended use도 “validate with the openui-lang parser”를 못 박는다.
단계: Transformers (대안)
Transformers 5.11 이상. AutoModelForCausalLM은 이 아키텍처를 못 찾는다. 클래스를 직접 가져온다. bf16 피크는 약 52 GiB(A100 80GB 또는 H100). generate는 256토큰 캔버스를 이어 붙이고 EOS에서 멈춘다. max_new_tokens를 256보다 크게 두지 않으면 첫 캔버스에서 잘린다.
import torch
from transformers import AutoProcessor
from transformers.models.diffusion_gemma.modeling_diffusion_gemma import DiffusionGemmaForBlockDiffusion

model_id = "thesysdev/OUI-1"
processor = AutoProcessor.from_pretrained(model_id)
model = DiffusionGemmaForBlockDiffusion.from_pretrained(
    model_id, dtype=torch.bfloat16, device_map="cuda"
)

messages = [
    {"role": "system", "content": open("system-prompt.txt").read()},
    {"role": "user", "content": brief},
]
ids = processor.apply_chat_template(
    messages, tokenize=True, add_generation_prompt=True, return_tensors="pt"
).to("cuda")
gc = model.generation_config
gc.max_new_tokens = 256 * 32
out = model.generate(input_ids=ids, generation_config=gc)
print(processor.decode(out.sequences[0, ids.shape[1]:], skip_special_tokens=True))
소비자 5090 FP8 경로가 목표면 vLLM을 먼저 쓴다. Transformers는 큰 카드·디버깅용 대안이다.
단계: 도구 호출 (선택)
Gemma 4 네이티브 도구 형식을 유지한다. 서빙에 --tool-call-parser gemma4를 켠 뒤, 요청에 tools를 넣고 시스템 프롬프트에 “날씨·주가처럼 도구가 필요한 질문은 먼저 도구만 호출하고 그 턴에는 화면을 쓰지 말 것” 같은 규칙을 붙인다. 카드 테스트(날씨·주가)에서는 관련 9/9는 올바른 도구·인자, 무관한 3번은 미호출, 반환 숫자를 그대로 썼다고 적혀 있다.
tool_choice는 기본 auto로 둔다. required·이름 지정은 받아들여도 무시된다(디퓨전용 structured outputs 미지원). required일 때 finish_reason만 tool_calls이고 tool_calls는 비어 있을 수 있으니, finish_reason만 보고 분기하지 말라고 카드가 경고한다.
막히는 지점 / 왜 막히나
| 증상 | 원인(문서) | 대응 |
|---|---|---|
| OOM / 메모리 부족 | FP8 25.8 GiB + KV, 또는 Transformers ~52 GiB | vLLM에서 --gpu-memory-utilization 하향 · Transformers면 더 큰 GPU |
| A100에서 “느린데 FP8인데?” | Ampere는 weight-only FP8(Marlin) | 메모리 절약만 기대. 연산 가속은 문서상 없음 |
| 화면이 한 캔버스에서 끊김 | max_new_tokens ≤ 256 | 256보다 크게(카드 예: 256×32) |
| 벤치 점수 급락 | 디노이징 16스텝 | 32 또는 48. 16은 깨짐 |
| temperature/seed가 안 먹음 | 체크포인트 샘플러 고정 | 정상. 무시된다고 카드에 명시 |
| AutoModelForCausalLM 실패 | 아키텍처 미등록 | DiffusionGemmaForBlockDiffusion 직접 import |
| tool_choice=required가 빈 tool_calls | 디퓨전 structured outputs 없음 | auto 유지 · finish_reason만 보지 말 것 |
| 채팅처럼 쓰니 깨진 코드 | 일반 채팅 모델 아님 | openui-lang 파서 검증 후 렌더 |
실사용자 반응
이 칸은 지어내지 않는다. 공개 채널에서 바로 옮길 만한 설치 후기 묶음은 이 글을 쓰는 시점에 아직 얇다. 확인 가능한 사실은 HF 카드의 day-0 서빙 문구(vLLM/Transformers/도구 호출), OpenUI 블로그의 RTX 5090 FP8 문구, Generative UI Benchmark 71.7%, 그리고 TWMS 뉴스 글이 링크한 1차 자료다. 별점·“쉽다/어렵다” 여론은 만들지 않는다.
의미와 시사점
로컬 가이드 검색어가 같아도 본체가 다르다. MiniCPM5-2B는 수 GB대 노트북 경로가 본체고, OUI-1은 FP8 25.8 GiB + vLLM 0.24와 openui-lang 하네스가 본체다. 디퓨전 캔버스·고정 샘플러·파서 검증까지 묶여서, “모델만 받으면 끝”이 아니라 프롬프트 CLI → 서빙 → 파서 → 렌더러 네 칸이 한 세트다. 소비자 5090 경로가 열렸다는 점과, Ampere에서는 메모리만 아끼고 속도는 기대하지 말라는 점이 같이 적혀 있다.
마치며
OUI-1을 로컬에서 돌리는 법은 공식 카드가 이미 짧게 적어 두었다. 서버면 pip install "vllm>=0.24" 후 FP8 서빙 한 줄. 시스템 프롬프트는 npx @openuidev/cli generate. 화면은 @openuidev/react-lang으로 그리고 lang-core로 검증한다. 큰 카드·디버깅이면 Transformers 직접 import. VRAM은 문서에 있는 25.8과 ~52만 믿고, 없는 칸은 추정하지 않는다. 오늘은 그 명령만 복사하면 된다.
출처
- Hugging Face — thesysdev/OUI-1
- OpenUI Blog — Introducing OUI-1 (2026-09-08)
- GitHub — thesysdev/openui
- TWMS — 화면을 로컬에서 쓴다: Thesys가 OUI-1을 연 이유
이 글은 AI가 작성하여 자동 발행된 콘텐츠입니다.