
CLM 로컬에서 돌리는 법
Contrastive Language Models(CLM, Contrastive-LM/CLM)를 로컬에서 vLLM Qwen3-8B pooling과 clm-serve로 띄워 typed 결정 API를 쓰는 검색 가이드다. 공식 README·PyPI 0.1.0 기준으로 설치·포트·2048 한도·클라이언트 예제까지 정리했다.

CLM(Contrastive Language Models, Contrastive-LM/CLM)은 상태(state)와 행동(action)을 대조 학습으로 묶은 System One 의사결정 모델이다. 이 저장소는 CLM-8B를 타입 안전한 결정 API 뒤에 올려 준다. 인코더는 vLLM pooling으로 Qwen/Qwen3-8B를 띄우고, clm-serve가 기본 포트 :8700에서 API·플레이그라운드를 연다. 코드·가중치 모두 Apache-2.0. PyPI 패키지 contrastive-lm 최신은 작성 시점 0.1.0. GitHub 스타는 API 기준 약 2,736.
이 글은 검색어 “CLM 로컬에서 돌리는 법”에 맞춰, 설치 → vLLM 인코더 → clm-serve → Python 클라이언트로 typed 질문·랭킹까지 공식 README 순서만 따라간다.
핵심 요약 (TL;DR)
- 무엇인가: 상태·행동을 임베딩으로 맞춰 빠르게 고르는 System One. typed 질문(
Noul/Choice/Score)과 후보 랭킹을 로컬 API로 제공. - 설치:
pip install contrastive-lm(Python ≥3.10). 의존성에 torch·vLLM·FastAPI가 포함된다. - 실행 2단: ①
vllm serve Qwen/Qwen3-8B ... --port 8090(pooling) ②clm-serve(기본:8700, UI는/). - 첫 실행: 참조 헤드 약 75 MB를 자동 다운로드. 플레이그라운드에서 state·질문을 바로 시험.
- 주의: state가 2048 토큰을 넘으면 잘린다. 늘리려면 vLLM
--max-model-len과clm-serve --max-tokens를 같이 올린다. 정확한 VRAM GB는 README에 고정 숫자로 없다.
배경
에이전트가 매 순간 “지금 무엇을 할지”를 고를 때, 긴 CoT를 매번 돌리면 지연이 커진다. CLM은 그 빠른 한 방을 담당하는 System One으로 설계됐다. 상태 인코더와 행동 인코더를 InfoNCE 대조 손실로 학습해, 배포 시에는 임베딩 정렬(닷 프로덕트)로 후보를 점수 매긴다.
README 기준 학습 레시피는 대략 이렇다. 사전학습 ~60M Nemotron Q&A, 미드트레이닝 ~30M 합성 hard negative, 포스트트레이닝 ~1M 에이전트 궤적. 백본은 동결된 LLM(참조 헤드는 Qwen3-8B + last-token pooling)에 약 20M 파라미터 projection head를 얹는다. 공개 참조 헤드는 Hugging Face Contrastive-LM/CLM-v0.1-8B(clm-latest, README 모델 목록 기준 릴리스일 2026-09-19).
할 수 있는 일
- 로컬에서 typed 의사결정 API를 띄운다. yes/no 확률(
Noul), 닫힌 선택(Choice), 순서 척도(Score). - 자유 형식 후보(도구 이름, best-of-N 답, 다음 수)를
Engine.rank/POST /v1/rank로 순위 매긴다. - 브라우저 플레이그라운드(
http://localhost:8700/)에서 JSON·curl·Python 예제를 같이 본다. - 자체 헤드를
--ckpt/--ckpt-dir로 핫 리로드해 서빙한다. 파인튜닝은docs/FINETUNING.md. - 에이전트 루프에서 자주 재사용되는 행동 임베딩은
--action-cache벡터 캐시로 재사용한다(기본은 디바이스의 일부 비율).
필요한 것
숫자는 공식 README·pyproject·serve 스크립트에 적힌 값만 옮긴다. 없는 값은 “문서에 없음”으로 둔다.
| 항목 | 내용 |
|---|---|
| OS / Python | Python ≥3.10. vLLM은 일반적으로 Linux + NVIDIA GPU 환경(requirements.txt 주석). |
| 패키지 | pip install contrastive-lm → PyPI 0.1.0. 의존: numpy, requests, torch≥2.1, fastapi, uvicorn, vllm≥0.6, pyarrow 등. |
| 인코더 | Qwen/Qwen3-8B를 vLLM --runner pooling으로 서빙. 기본 포트 8090, served name qwen3-8b, --max-model-len 2048. |
| CLM 서버 | clm-serve 기본 포트 8700. 임베딩 URL 기본 http://127.0.0.1:8090/v1/embeddings. |
| 헤드 | 첫 실행 시 참조 헤드 약 75 MB 다운로드(~/.cache/clm/). HF: Contrastive-LM/CLM-v0.1-8B. |
| VRAM | README에 Qwen3-8B pooling 최소 GB는 명시되지 않음. 예제 캡션은 “one RTX 4090”, 지연 표는 H100/4090 측정. 공식 serve_qwen3_8b.sh 기본 UTIL=0.35. |
| 선택 | CLM_API_KEY로 Bearer 인증. 원격이면 ssh -L 8700:localhost:8700 .... API만 쓰려면 clm-serve --no-ui. |
단계
1) 패키지 설치
pip install contrastive-lm
# 클론해서 최신을 쓰려면
# pip install -e .
또는 저장소 루트에서 python3 -m venv .venv && source .venv/bin/activate && pip install -r requirements.txt.
2) vLLM으로 인코더 띄우기
vllm serve Qwen/Qwen3-8B \
  --served-model-name qwen3-8b \
  --runner pooling \
  --max-model-len 2048 \
  --port 8090 &
저장소의 serve_qwen3_8b.sh는 여기에 --enforce-eager, --enable-prefix-caching, --gpu-memory-utilization(기본 0.35), --max-num-seqs 32를 더한다. 학습 때와 같은 last-token pooling·prefix cache를 맞추려는 목적이다.
3) clm-serve 실행
clm-serve
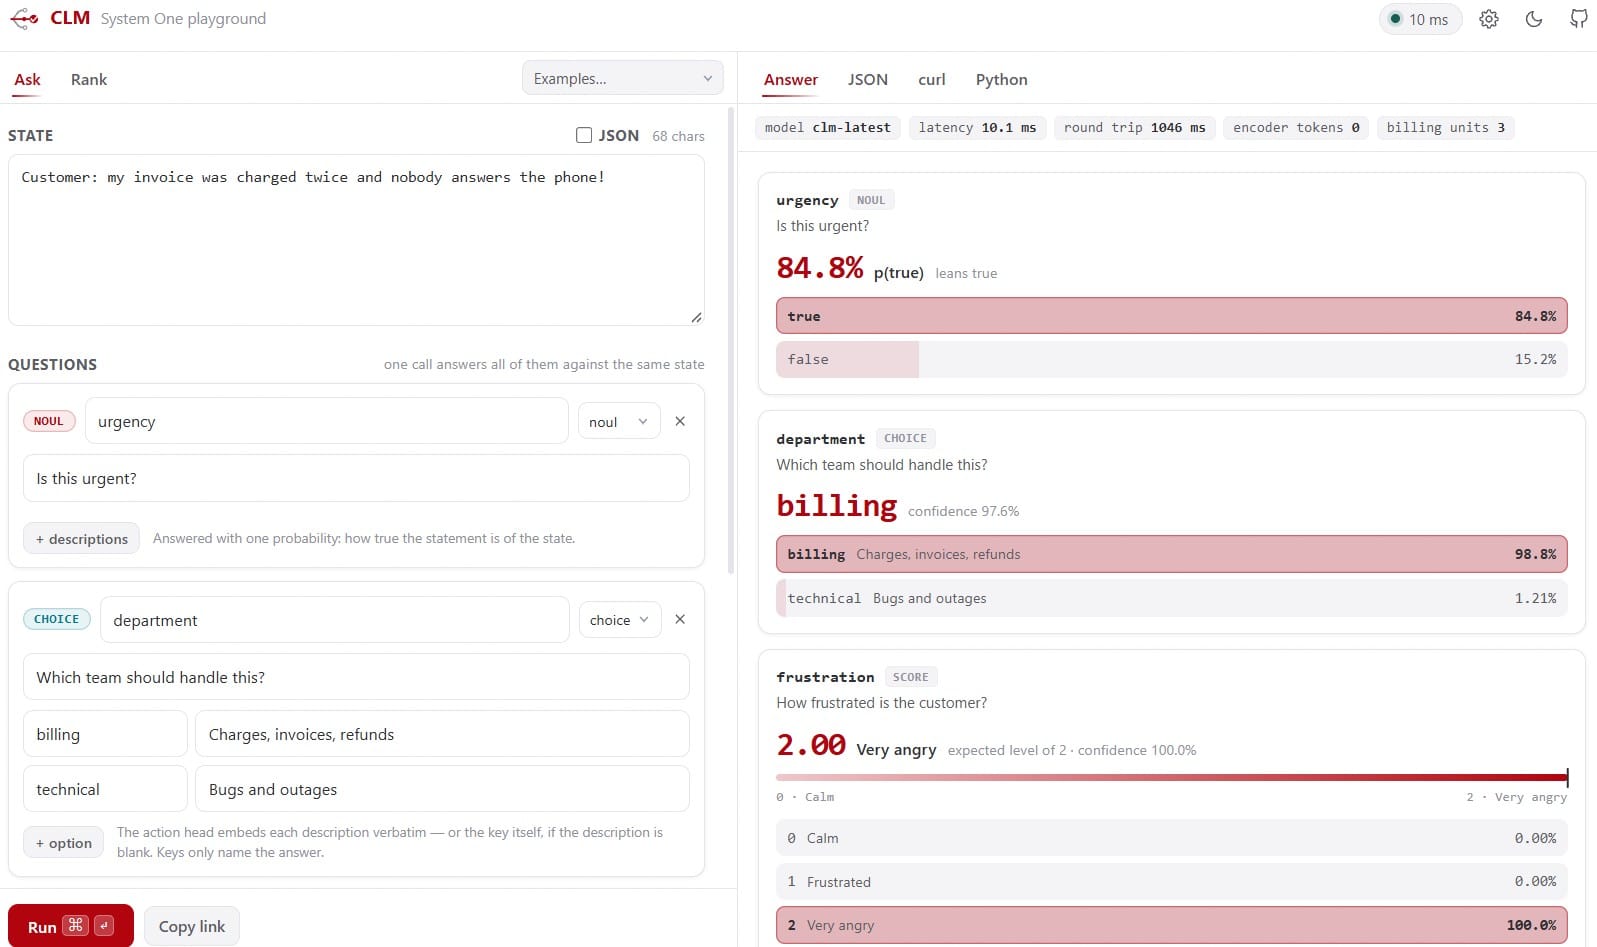
기본으로 :8700을 열고, 첫 실행에 75 MB 참조 헤드를 받는다. 브라우저에서 http://localhost:8700/ 플레이그라운드. 헬스·모델 목록은 GET /health, GET /v1/models.
자주 쓰는 옵션 예:
clm-serve --port 8700 \
  --emb-url http://127.0.0.1:8090/v1/embeddings \
  --emb-model qwen3-8b \
  --max-tokens 2048
# 긴 state: vLLM --max-model-len 8192 와 함께
# clm-serve --max-tokens 8192
4) typed 질문 (Python)
from clm import CLMClient, Choice, Noul, Score

client = CLMClient()  # CLM_BASE_URL 기본 http://127.0.0.1:8700
r = client.system_one(
    state="Customer: my invoice was charged twice and nobody answers the phone!",
    questions={
        "urgency": Noul(instructions="Is this urgent?"),
        "department": Choice(
            instructions="Which team should handle this?",
            criteria={
                "billing": "Charges, invoices, refunds",
                "technical": "Bugs and outages",
            },
        ),
        "frustration": Score(
            instructions="How frustrated is the customer?",
            criteria=["Calm", "Frustrated", "Very angry"],
        ),
    },
)
print(r.answers["urgency"].noul)
print(r.answers["department"].choice, r.answers["department"].probabilities)
print(r.answers["frustration"].score)
print(r.usage.input_tokens, r.latency_ms)
HTTP로는 POST /v1/systemone. 질문 타입 요약:
| 타입 | 필수 | 답 |
|---|---|---|
noul | instructions (선택: true/false criteria) | {"noul": p_true} |
choice | instructions + criteria: {옵션: 설명} | choice, confidence, probabilities |
score | instructions + 순서 있는 criteria (≥2) | score(기대 인덱스), legend, 확률 |
5) 후보 랭킹
from clm import Engine

engine = Engine(emb_url="http://127.0.0.1:8090/v1/embeddings")
engine.rank(
    "What causes tides on Earth?",
    [
        "The Moon's gravitational pull.",
        "Photosynthesis in plants.",
        "Because the Earth is round.",
    ],
)
# [{'rank': 1, 'candidate': "...", 'prob': 0.997}, ...]
서버 없이 in-process로도 같은 헤드를 쓸 수 있고, HTTP는 POST /v1/rank.
막히는 지점
| 증상 | 원인 / 대응 (README 기준) |
|---|---|
502 embedder unreachable | vLLM(:8090)이 안 떠 있거나 --emb-url이 틀림. pooling runner·모델명 qwen3-8b 확인. |
| 긴 state가 잘림 | 기본 2048. vllm serve --max-model-len과 clm-serve --max-tokens를 동시에 상향(예: 8192). GPU 메모리 더 필요. |
401 | CLM_API_KEY가 켜져 있으면 Bearer 필요. 플레이그라운드에도 키 입력란이 있다. |
422 | 요청 형식·알 수 없는 model. GET /v1/models의 clm-latest/clm-raw 확인. |
| 첫 호출이 느림 | 옵션 텍스트 임베딩 콜드 캐시. README 예시는 콜드 106토큰 → 이후 캐시 히트. |
| VRAM OOM | 공식 최소 GB는 없음. serve_qwen3_8b.sh의 UTIL을 낮추거나 max-model-len을 줄인다. 캐시는 --action-cache 0으로 끌 수 있다. |
| 브라우저 CORS | 기본 CORS off. 타 오리진에서 쓰려면 clm-serve --cors(키를 헤더로 보내는 SPA는 주의). |
실사용자 반응
외부 커뮤니티 인용을 지어내지 않는다. 아래는 공식 README에 적힌 주장·수치만 옮긴다.
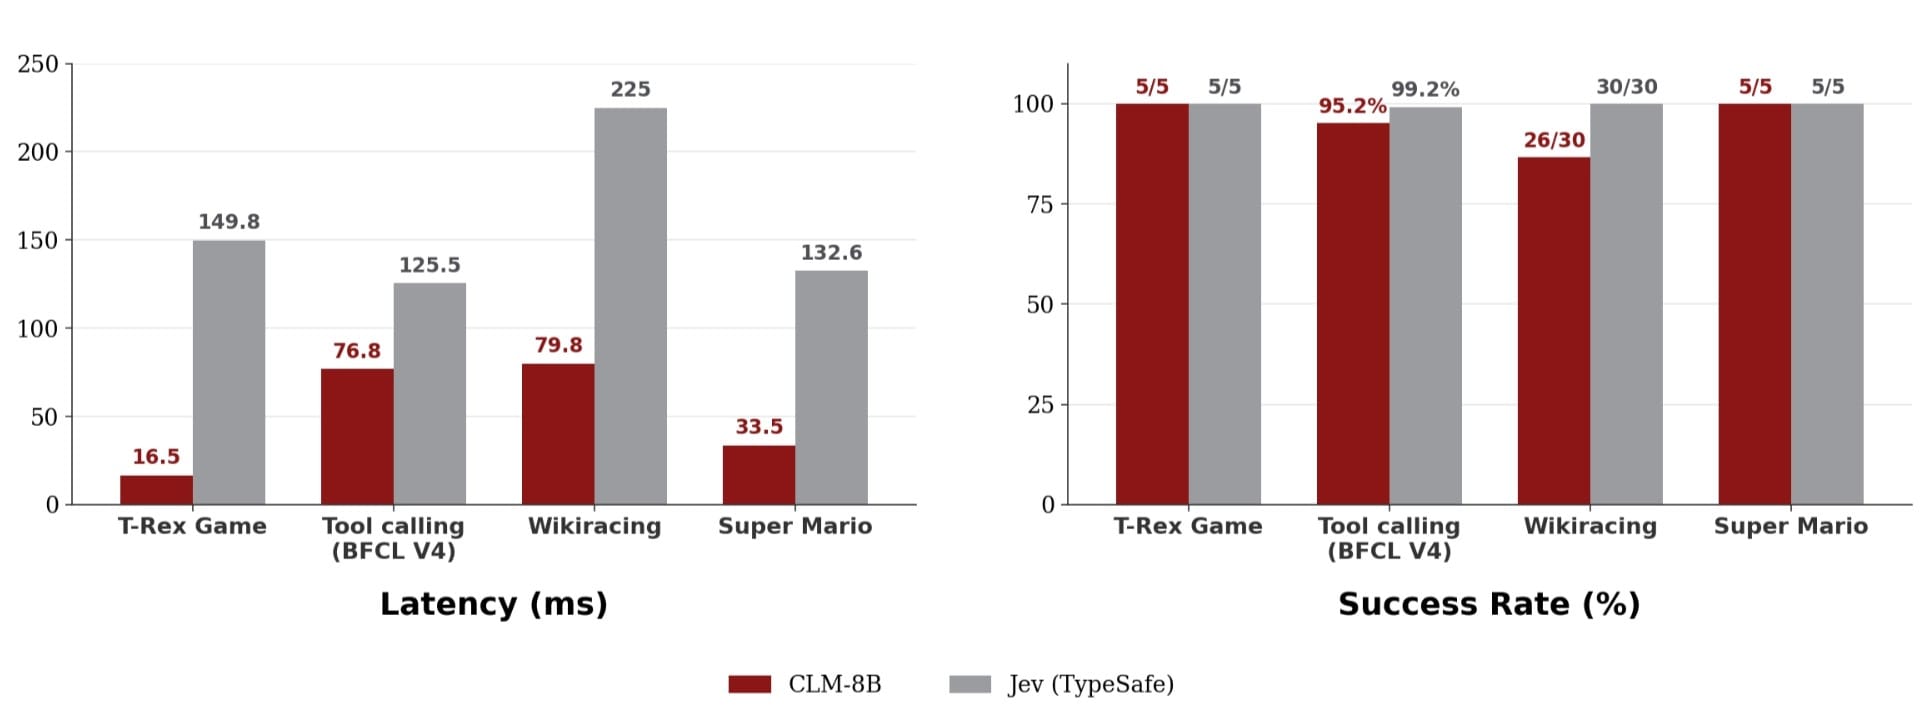
- 제로샷으로 computer-use·게이밍·툴콜에서 Jev와 비슷한 성능을 내면서 지연은 최대 약 9× 낮다고 README가 적는다. 후보가 많거나(WikiRacing) 행동이 상태에 걸쳐 재사용될 때(T-Rex) 이득이 크다.
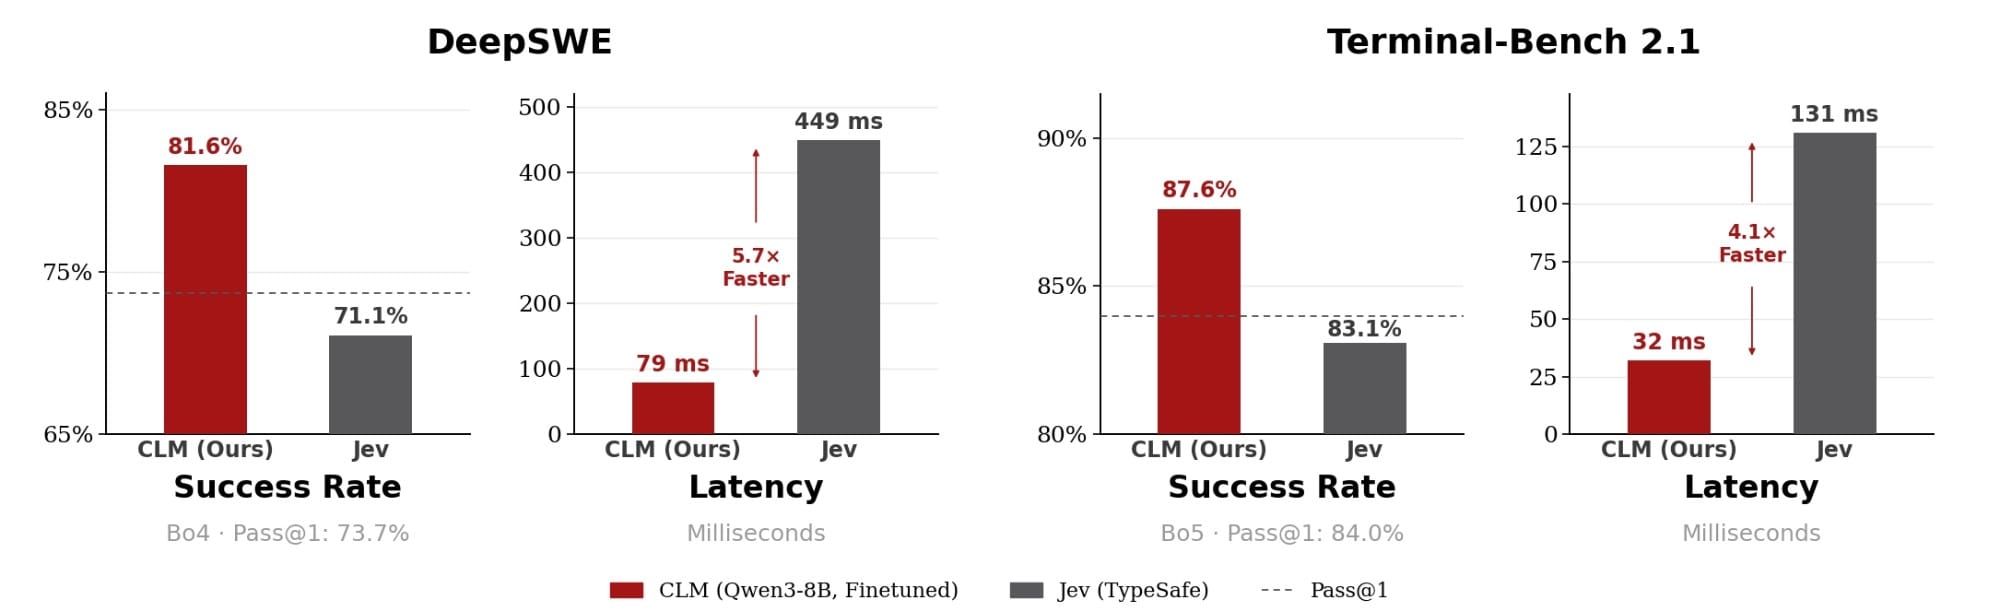
- 에이전트 검증기로 쓸 때, 가벼운 파인튜닝 후 held-out 기준 Terminal-Bench 2.1 87.6%, DeepSWE 81.6%를 주장하며 Jev 대비 4.1–5.7× 빠르다고 한다(DeepSWE 38과제, Terminal-Bench 30과제, H100 지연).
- 벡터 캐시 측정(RTX 4090, 서버 p50): 재방문 state는 대략 1.7→0.6 ms 수준으로 줄어든다고 README 표가 보여 준다(고정 행동 집합 기준).
의미와 시사점
로컬 에이전트 스택에서 “생성 모델이 한 번에 다 고른다” 대신, 빠른 검증·라우팅 레이어를 분리하는 흐름이 커지고 있다. CLM은 그 레이어를 typed API와 랭킹 primitive로 패키징한 예에 가깝다. vLLM pooling + 작은 projection head 조합은, 이미 vLLM을 돌리는 팀에 진입 장벽을 낮춘다.
다만 System One이므로 긴 추론·도구 실행 자체는 다른 하네스(오케스트레이터, 코딩 에이전트)가 맡는다. README도 “커뮤니티가 자기 에이전트·벤치에 꽂아 보라”고 초대한다. 벤치 숫자는 저자 held-out·파인튜닝 조건을 그대로 읽고, 자기 도메인에서는 헤드 파인튜닝(train/finetune.py)이 전제에 가깝다.
마치며
로컬에서 할 일은 단순하다. pip install contrastive-lm → Qwen3-8B pooling(:8090) → clm-serve(:8700) → 플레이그라운드나 CLMClient.system_one / Engine.rank. 2048 한도와 VRAM은 문서에 없는 숫자를 짐작하지 말고, 두 서버의 max token을 같이 조절하며 맞추면 된다. 블로그·모델·API 상세는 아래 소스를 본다.
소스
- GitHub: Contrastive-LM/CLM
- README (raw)
- 공식 블로그 (Notion)
- Hugging Face: Contrastive-LM · CLM-v0.1-8B
- PyPI: contrastive-lm 0.1.0
이 글은 AI가 작성하여 자동 발행된 콘텐츠입니다.