
화면을 로컬에서 쓴다: Thesys가 OUI-1을 연 이유
Thesys가 DiffusionGemma 파인튜닝작 OUI-1(26B·활성 4B)을 공개했다. openui-lang으로 화면을 쓰고 Generative UI Benchmark 71.7%(베이스 13.0%)를 찍으며, FP8로 소비자 GPU 로컬 서빙을 노린다.

핵심 요약 (TL;DR)
2026년 9월 8일 Thesys Engineering이 OUI-1을 공개했다. Google DiffusionGemma 26B-A4B-it를 파인튜닝한 생성 UI(Generative UI) 전용 오픈웨이트 모델이다. 출력은 React 코드가 아니라 OpenUI의 선언형 언어 openui-lang이고, 가중치는 Hugging Face thesysdev/OUI-1에 올라 있다. 라이선스는 Gemma Terms of Use(파생물).
한 줄로 정리하면 이렇다. 활성 파라미터 4B로 Generative UI Benchmark 71.7%를 찍었고, 베이스 DiffusionGemma(13.0%) 대비 5.5배다. Thesys는 FP8로 RTX 5090급 소비자 GPU에서 돌릴 수 있다고 적는다. vLLM 0.24+ 권장, 컨텍스트 16,384, FP8 가중치 약 25.8 GiB. 벤치마크는 구조적 유효성(파싱·배선·루트·필수 props)이지 시각 품질·사용성·작업 완수는 아니다.
배경 및 맥락
에이전트가 답을 말로만 주면 제품이 안 된다. 화면이 따라와야 한다. Google A2UI, Vercel json-render, CopilotKit AG-UI 같은 프로토콜·렌더러가 이미 그 축에 서 있다. Thesys는 OpenUI 프레임워크(오픈소스, MIT)와 C1 API로 같은 시장에 있었고, 9월 8일에는 그 언어에 맞춰 튜닝한 전용 가중치까지 풀었다.
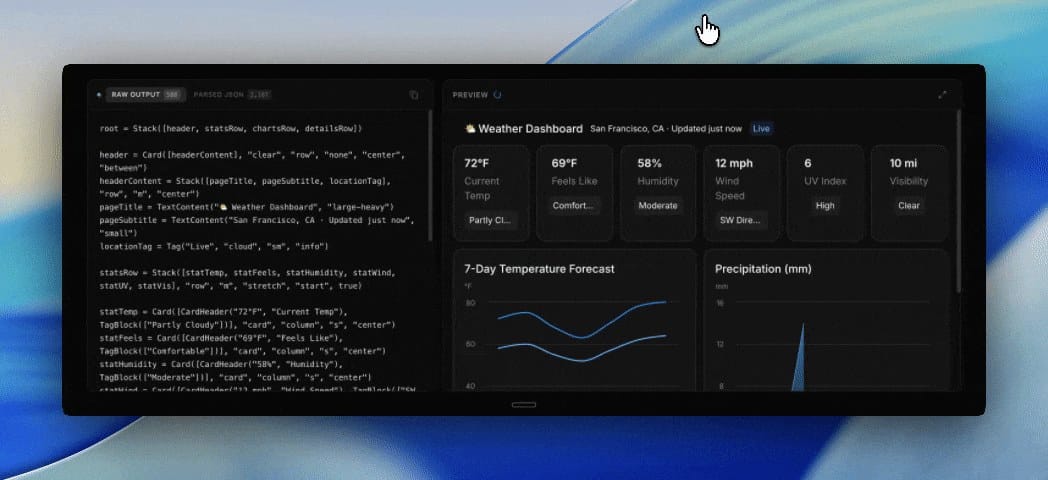
용어를 짧게 푼다. 생성 UI는 모델이 채팅 문장 대신 컴포넌트 그래프를 내놓는 방식이다. openui-lang은 JSON보다 토큰을 최대 약 67% 덜 쓰는 스트리밍 우선 선언형 UI 언어다(공식 README·벤치마크). 텍스트 디퓨전 모델은 토큰을 하나씩 이어 쓰지 않고, 노이즈에서 시작해 256토큰 캔버스를 한꺼번에 확정한다. DiffusionGemma가 그 계열이다.
Thesys가 공식 글에서 건 제약은 셋이다. 1초 안팎으로 나와야 하고, 소프트웨어로 쓸 만큼 안정적이어야 하며, 소비자 하드웨어에서 돌아가야 한다. AppLess 데모는 원래 Gemma 4를 Cerebras에 올려 돌렸다고 한다. OUI-1은 그 경험을 “전용 클라우드 칩”에서 “로컬 4B 활성”으로 옮기려는 첫 스텝이다.
주요 내용 분석
| 항목 | 내용 |
|---|---|
| 공개일 | 2026-09-08 (공식 블로그) |
| 주체 | Thesys Engineering (OpenUI / C1) |
| 베이스 | google/diffusiongemma-26B-A4B-it (총 26B · 활성 4B) |
| 방법 | LoRA(r=64, α=128) 후 병합 · bf16 safetensors · adapter/ 동봉 |
| 출력 | openui-lang (컴포넌트 라이브러리 시그니처 → 한 줄당 한 컴포넌트 → root 배선) |
| 컨텍스트 | 16,384 (서빙 기준) |
| 라이선스 | Gemma Terms of Use (파생물 · 베이스 제한 적용) |
| 벤치 | Generative UI Benchmark 71.7% (132/184) vs 베이스 13.0% (24/184) |
| 비교군 | 4B 활성 이하 최고; Qwen3.8 27B dense 78.8%가 더 높음 |
| 서빙 | vLLM≥0.24 FP8 권장 · Transformers≥5.11 DiffusionGemmaForBlockDiffusion |
| 메모리 | FP8 가중치 25.8 GiB (카드 표기) · bf16 Transformers 피크 약 52 GiB |
왜 디퓨전인가
자기회귀 모델은 토큰마다 메모리 대역폭에 묶인다. DiffusionGemma는 256토큰 블록을 한 번에 쓰고, 엔트로피가 임계값 아래로 떨어지면 그 토큰을 확정한다. Google은 H100 단일 장에서 1,000 tok/s 이상, RTX 5090에서 700 tok/s 이상을 보고했다고 Thesys가 인용한다. 생성 UI는 첫 픽셀이 보이기까지의 지연에 특히 민감하니, “느린 채팅 모델로 JSON을 뽑는” 경로와는 결이 다르다.
openui-lang은 JSON 대비 토큰을 줄이고 스트림을 전제로 설계됐다. 모델이 끝나기 전에 렌더러가 화면을 그리기 시작한다. 즉 언어(토큰 절감) + 샘플러(블록 확정) + 로컬 서빙이 한 세트로 맞춰져 있다.
SFT가 깨지고, 파서가 고쳤다
공식 글의 핵심 서사는 실패에서 시작한다. 약 700개 openui-lang 예시로 LoRA SFT를 돌리자 loss는 내려갔지만 벤치 점수는 같이 내려갔다. 프로그램이 길어지고 밀도는 올라갔는데, 파서가 거의 통과시키지 못했다. 라이브러리 하나로 좁히면 13.0%→28.8%까지는 올랐지만 스키마 오류와 배선 오류(미정의 이름·고아 섹션)가 시소처럼 엇갈렸다. 동시에 같은 20개 라이트 브리프 기준 생성 시간은 1.6초→4.3초로 늘었다. 유용한 이름·값을 쓰기 시작하자 디노이징 스텝이 약 두 배로 늘었기 때문이다.
돌파구는 파서를 보상 신호로 쓰는 자기증류(self-distillation)였다. 모델이 수백 개 프로그램을 쓰고, 파서가 통과한 것만 남긴다. 근접 실패는 파서가 지적한 결함만 고치는 수리 패스를 거치고, 재작성·발명은 거절한다. 판별기가 브리프 일치 여부를 본 뒤 생존 샘플로 다음 500스텝(A100 1~2시간)을 돌린다. 그 결과 생성 시간은 4.3초→1.9초로 회복됐고(토큰은 베이스보다 28% 많으면서), 벤치는 57.1%까지 올랐으며 스키마·배선 오류가 동시에 줄었다. 같은 레시피를 27개 컴포넌트 라이브러리로 확장한 결과가 OUI-1이다.
결함 밀도 숫자도 공식 글에 있다. DiffusionGemma 35.3 defects/100 statements(24/184 완료) → SFT 후 16.4(53/184) → OUI-1 3.8(132/184). AppLess 라이브러리의 학습에 안 쓴 60개 질문에서는 베이스 23/60, OUI-1 55/60이 유효 출력이었다.
벤치 숫자 읽기
| 모델 | 활성 파라미터 | OpenUI score |
|---|---|---|
| OUI-1 | 4B | 71.7% |
| DiffusionGemma | 4B | 13.0% |
| Qwen3.8 27B | 27B | 78.8% |
| Qwen3.6 27B | 27B | 68.5% |
| Qwen3.6 35B-A3B | 3B | 61.4% |
| Gemma 4 31B | 31B | 46.7% |
| Gemma 4 26B-A4B | 4B | 29.9% |
| Phi-4 14B | 14B | 44% |
| Ministral 8B | 8B | 27.2% |
프로토콜은 46개 스크린 브리프 × 4회 생성, thinking off, 공통 시스템 프롬프트, 벤치 자체 검증기다. 측정은 vLLM 0.24 · FP8 · 체크포인트 샘플러 48 디노이징 스텝 · A100 80GB 단일 요청이다다. 라이트 스크린 약 1초, 밀도 높은 스크린 3~6초(프롬프트 포함). OUI-1 원시 출력은 벤치 저장소에 커밋돼 오프라인 재채점이 가능하다.
주의할 점. Qwen3.8 27B(78.8%)가 점수상으로는 높다. Thesys의 주장 축은 “절대 1위”가 아니라 4B 활성·로컬·디퓨전 특화다. RuntimeWire도 “세계 최초 생성 UI 모델”이라는 수식어는 프로토콜·프레임워크(A2UI, json-render 등)와 구분해서 읽어야 한다고 적는다.
실제로 어떻게 돌리나
카드가 권장하는 최소 경로는 이렇다.
pip install "vllm>=0.24"
vllm serve thesysdev/OUI-1 --trust-remote-code --max-model-len 16384 --quantization fp8 \
  --served-model-name OUI-1 --max-num-seqs 4 \
  --enable-auto-tool-choice --tool-call-parser gemma4
시스템 프롬프트는 npx @openuidev/cli generate <library.ts> --out system-prompt.txt로 컴포넌트 라이브러리에서 뽑는다. 렌더는 @openuidev/react-lang(Vue·Svelte도 있음), 검증은 @openuidev/lang-core. 스트림은 자기회귀와 달리 256토큰 캔버스 단위로 도착한다. 도구 호출은 Gemma 4 네이티브 포맷을 유지하며, 날씨·주가 도구 테스트에서 9/9 올바른 호출·3개 무관 질문에서 미호출을 보고했다. tool_choice: required는 받아도 무시되니 finish_reason만으로 분기하면 안 된다.
실사용자 반응
공개 직후 반응은 세 갈래다. 첫째, “프레임워크에 모델까지 붙였다” — OpenUI 저장소와 C1 API 위에 전용 가중치가 생기면서 셀프호스트 경로가 열렸다. 둘째, 벤치 해석 — 71.7%는 구조 유효성이지 “예쁜 앱”이 아니라는 주의가 RuntimeWire 등에서 반복된다. 셋째, 하드웨어 현실 — FP8 25.8 GiB와 RTX 5090 언급은 “노트북 한 대”가 아니라 “고용량 소비자 GPU”에 가깝다. Ampere(A100)에서는 네이티브 FP8이 없어 weight-only FP8(Marlin)이라 메모리 절감은 있어도 연산 가속은 없다고 카드가 명시한다.
의도된 용도도 카드에 분명히 적혀 있다. OpenUI 앱에서 지연이 중요하고 소형 셀프호스트를 원할 때. 일반 채팅 모델이 아니다. 출력은 파서로 검증하고, props를 검사하는 컴포넌트 라이브러리로 렌더해야 한다.
의미와 시사점
첫 번째, 생성 UI 경쟁이 “프로토콜”에서 “특화 가중치”로 한 층 내려왔다. A2UI·json-render가 포맷과 카탈로그를 열었다면, OUI-1은 그 언어의 파서를 보상으로 쓰는 학습 루프까지 공개했다. 두 번째, 검증 가능한 보상이 있는 도메인에서는 자기증류가 SFT의 시소를 깨는 실제 레시피로 보인다. UI 스키마는 수학 증명만큼은 아니어도, 파서가 “맞다/틀리다”를 즉시 말해 준다. 세 번째, 로컬·저지연이 제품 요건이면 활성 파라미터와 출력 언어를 같이 줄이는 쪽이 이득이다. 다만 Gemma 파생 라이선스, 25.8 GiB FP8, 벤치≠제품 품질이라는 세 한계는 프로덕션 전에 그대로 남아 있다.
마치며
OUI-1의 메시지는 단순하다. 채팅을 더 잘하게 만든 모델이 아니라, 화면을 로컬에서 쓰기 위해 파서로 단련한 4B 활성 디퓨전 모델이다. 9월 8일 공식 드롭, HF 가중치, vLLM day-0에 가까운 문서, 27개 라이브러리로 일반화한 자기증류. 다음으로 볼 것은 OpenUI Lang 0.5의 상태·쿼리·뮤테이션, 1초 미만 지연, 그리고 파서 밖의 실제 사용자 태스크 완수율이다.
출처
- OpenUI — Introducing OUI-1 (2026-09-08)
- Hugging Face — thesysdev/OUI-1
- GitHub — thesysdev/openui
- Hugging Face — google/diffusiongemma-26B-A4B-it
- RuntimeWire — Thesys ships OUI-1
이 글은 AI가 작성하여 자동 발행된 콘텐츠입니다.