
GLM-5.3-Flash 로컬에서 돌리는 법
로컬로 올리려면 FP8 가중치 약 306GiB를 받을 디스크와, 공식 카드에 없는 VRAM을 대신할 멀티 GPU 또는 양자화(GGUF) 경로가 필요하다. 가중치는 MIT로 Hugging Face zai-org/GLM-5.3-Flash에 풀려 있다.

핵심 요약 (TL;DR)
이 글은 받아서 자기 기계에서 켜는 안내다. 출시 맥락은 큰 모델이 먼저 안 왔다: GLM-5.3-Flash가 MIT로 풀린 이유에 적어 두었다. 대상은 GPU 서버나 고용량 RAM을 만져 본, 스마트한 비전문가다. 노트북 한 대로 끝나는 크기가 아니다.
할 수 있는 일은 세 갈래다. 공식 가중치를 받아 vLLM이나 SGLang으로 채팅·비전·코딩을 서빙하거나, 공식 README가 가리키는 Unsloth GGUF로 양자화 경로를 타거나, GPU가 없으면 Z.ai API와 Coding Plan을 쓰는 것이다. 한 가지 단단한 한계는 크기다. Hugging Face Files 탭을 합치면 FP8이 305.81GiB(328.4GB), BF16이 598.54GiB(642.7GB)다. 공식 모델 카드에 VRAM 숫자는 없다.
용어를 한 번만 풀어 둔다. 가중치는 모델이 학습해 둔 숫자 파일이다. 내려받으면 그 모델을 자기 기계에서 돌릴 수 있다. MoE(전문가 혼합, Mixture of Experts)는 작은 전문가 네트워크를 많이 두고, 토큰마다 일부만 고르는 구조다. 활성 파라미터는 그때 실제로 켜지는 부분이다. Flash는 총 3,200억(320B) 중 180억(18B)이다. 양자화는 숫자를 더 거칠게 줄여 용량과 메모리를 깎는 일이다. GGUF는 그 줄인 파일을 로컬에서 돌리기 쉽게 담는 형식이다. vLLM은 GPU에서 큰 언어 모델을 서빙하는 오픈소스 엔진이다.
배경 및 맥락
Z.ai는 2026년 8월 26일 GLM-5.3-Flash를 풀었다. GLM-5 시리즈에서 처음으로 네이티브 멀티모달—텍스트만이 아니라 이미지와 영상을 모델이 처음부터 받는다—이다. 총 파라미터 320B, 활성 18B. 라이선스는 MIT다. 가중치는 Hugging Face zai-org/GLM-5.3-Flash(FP8)와 BF16 변형에 앉아 있다. 공식은 희소 어텐션과 선형 어텐션을 섞는 하이브리드에 Manifold-Constrained Hyper-Connections(mHC)를 넣었다고 적는다. 카드 태그는 image-text-to-text다. 출시 맥락은 여기다.
플래그십 GLM-5.3은 이 글을 확인하는 2026-08-28 저녁(한국 시간) 기준으로 이렇게 갈린다. GitHub README의 Download Model 표에는 GLM-5.3과 GLM-5.3-BF16 행이 생겼다. 크기 칸은 744B-A40B다. 같은 시각 Hugging Face zai-org/GLM-5.3 페이지는 아직 Upcoming release다. 예정일은 2026년 8월 28일, 이 글을 받을 때 카운트다운이 남아 있었고 대기 표시는 689였다. safetensors 목록은 그 페이지에 없다. 표에 행이 생겼다고 파일이 내려받아지지는 않는다. 오늘 받아서 켤 수 있는 공개 가중치는 Flash다.
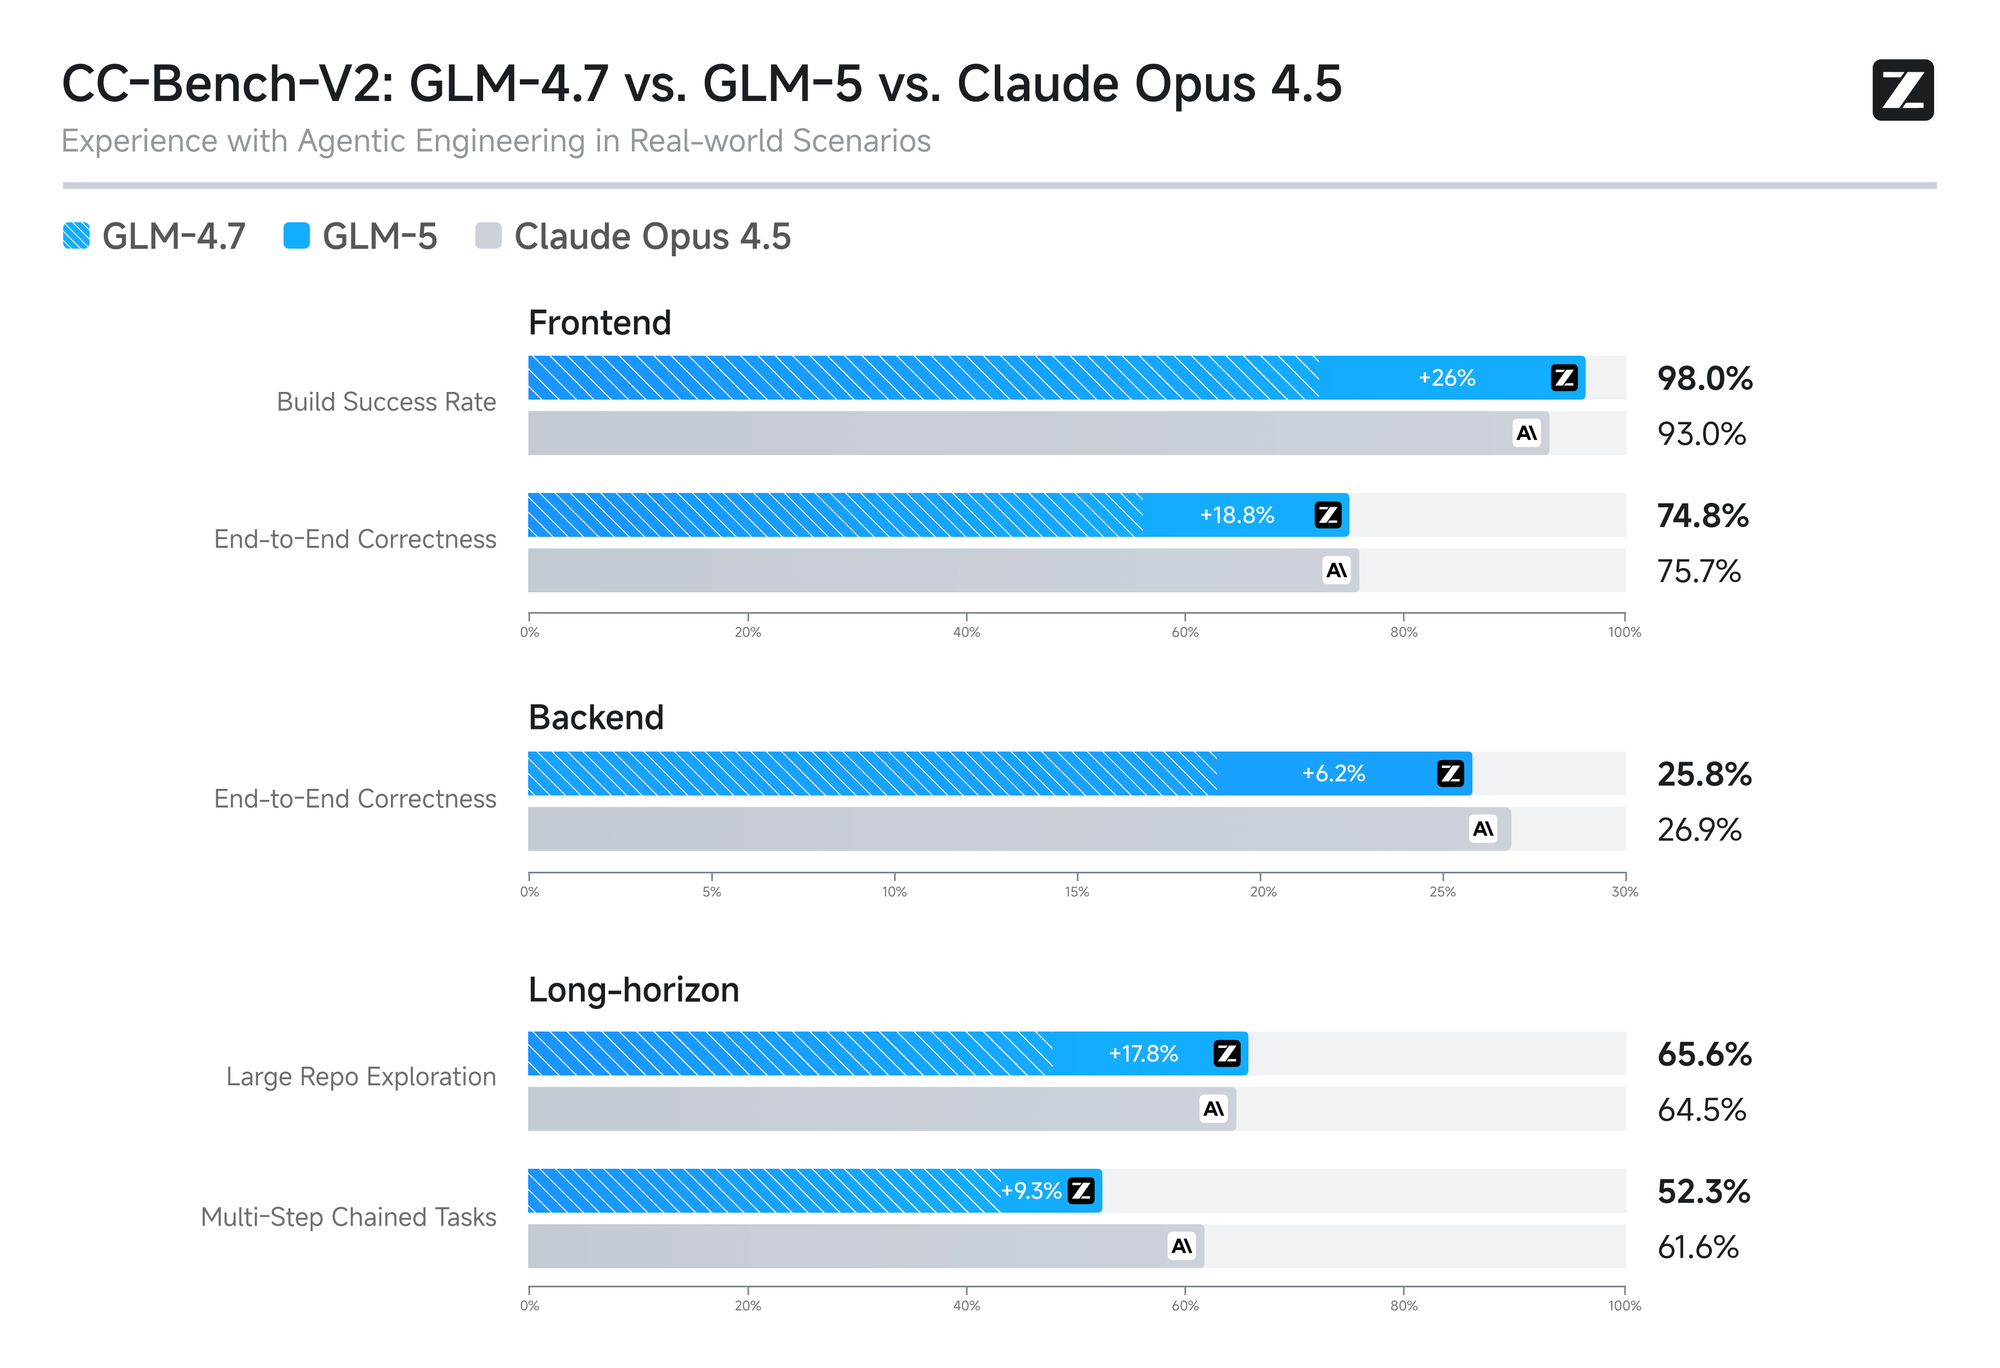
패밀리의 자리는 이미 있었다. GLM-5는 총 744B, 활성 40B다. README는 내부 CC-Bench-V2에서 GLM-4.7을 크게 앞섰다고 적는다. 아래 장은 그 패밀리 차트다. Flash 차트가 아니다. Flash가 어디서 왔는지를 보여 주려고 둔다.
주요 내용 분석
이걸로 할 수 있는 일
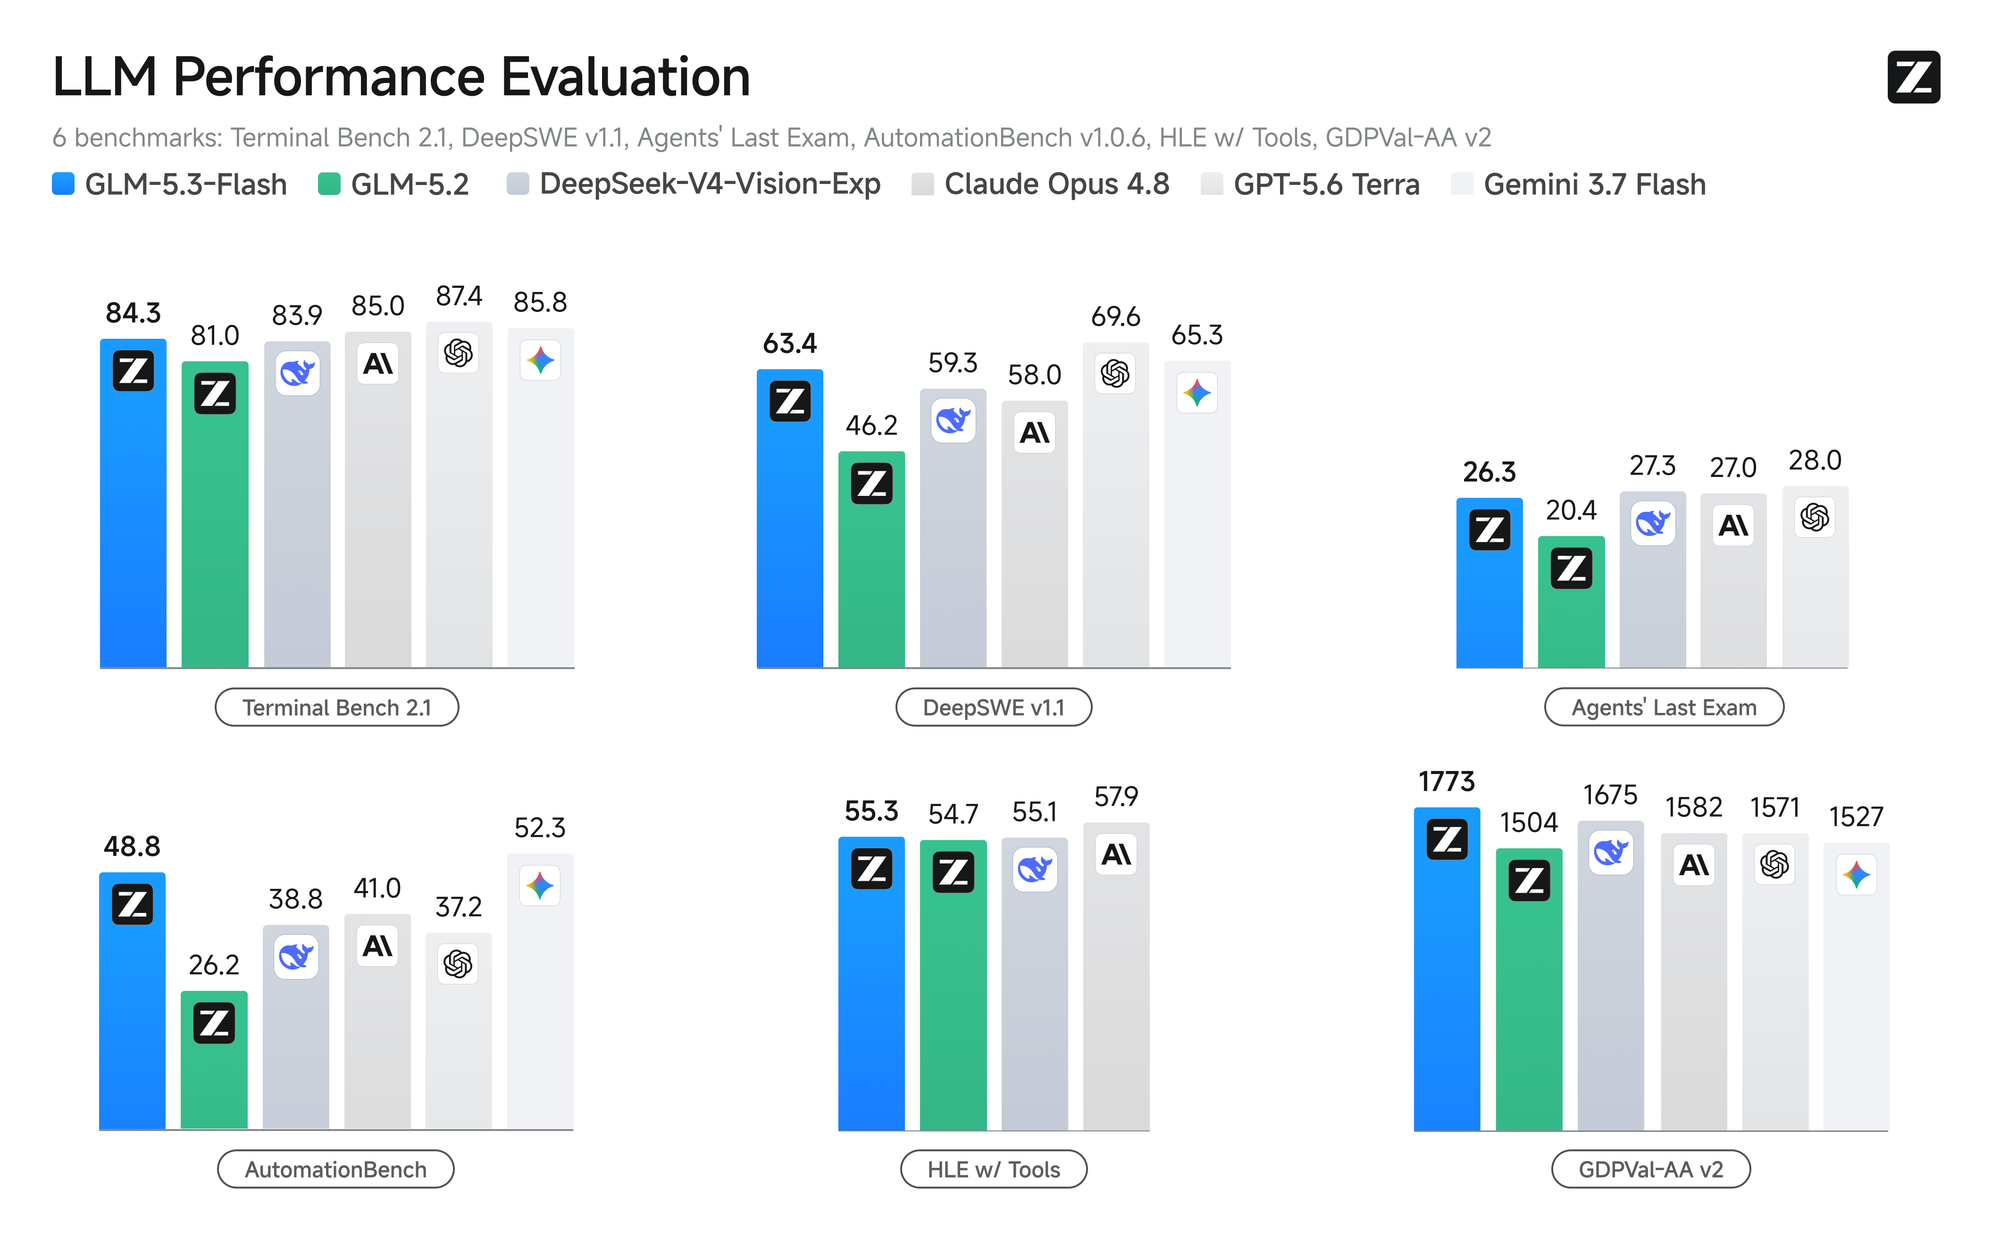
공식 카드와 서빙 문서가 열어 둔 일은 세 칸이다. 채팅—사고(thinking)가 기본이고 reasoning_effort는 low / high / max(기본)다. 비전—카드가 image-text-to-text이고, SGLang 쿡북은 입력을 “Text, image, and video”로 적으며, vLLM 레시피는 image_url과 video_url 예제를 준다. Z.ai 개발자 문서는 비전이 코딩 루프 안에 들어가 화면을 보고 고친다고 적는다. 코딩·에이전트—공식은 Terminal-Bench 2.1에서 84.3, DeepSWE v1.1에서 63.4를 자기 표에 올렸다. 도구 호출 파서는 레시피가 glm47, 사고 파서는 glm45다.
받아서 고르는 파일
공식 카드에 VRAM 숫자는 없다. 아래에 적는 용량은 Hugging Face /tree/main API가 돌려 준 파일 크기 합이다. vLLM 공식 레시피는 FP8을 “약 306GiB”로 적는다. 그 문장과 아래 305.81GiB가 맞는다. GB는 10진(1GB=10⁹바이트), GiB는 2진(1GiB=2³⁰바이트)이다.
| 칸 | 저장소 | 형식 | 파일 | 용량 (HF Files) | 비고 |
|---|---|---|---|---|---|
| 공식 FP8 | zai-org/GLM-5.3-Flash | safetensors | 62샤드 | 305.81GiB / 328.4GB | README 기본. vLLM 레시피 “about 306 GiB” |
| 공식 BF16 | zai-org/GLM-5.3-Flash-BF16 | safetensors | 120샤드 | 598.54GiB / 642.7GB | README 변형. vLLM: “roughly twice” |
| Unsloth UD-IQ1_S | unsloth/GLM-5.3-Flash-GGUF | GGUF | 3파일 | 93.09GB | HF tree 합. Unsloth 문서와 같은 숫자 |
| Unsloth UD-IQ1_M | 위와 같음 | GGUF | 3파일 | 97.58GB | HF tree 합 |
| Unsloth UD-Q2_K_XL | 위와 같음 | GGUF | 4파일 | 108.72GB | HF tree 합. Unsloth 문서는 109GB |
| Unsloth UD-IQ3_XXS | 위와 같음 | GGUF | 4파일 | 120.37GB | HF tree 합. Unsloth 문서는 120GB |
| Unsloth UD-Q3_K_XL | 위와 같음 | GGUF | 4파일 | 147.54GB | HF tree 합 |
| Unsloth UD-IQ4_XS | 위와 같음 | GGUF | 5파일 | 156.82GB | HF tree 합 |
| Unsloth UD-Q4_K_XL | 위와 같음 | GGUF | 6파일 | 199.71GB | HF tree 합. Unsloth 문서는 200GB |
| 비전 프로젝터 | Unsloth GGUF 저장소 | GGUF | mmproj-F16 / BF16 | 1.13GB / 1.16GB | HF tree. 텍스트 GGUF와 별도 |
| AtomicChat GGUF | AtomicChat/GLM-5.3-Flash-GGUF | GGUF | 업로드 중 | 카드 표가 아직 대시 | 존재는 확인. 용량은 카드가 비워 둠 |
커뮤니티가 말하는 GPU 숫자는 공식 카드가 아니다. NVIDIA 개발자 포럼 스레드에서 jbitt는 HF Files 탭을 328GB로 읽었고, DSv4F 0731(160GB)보다 무거워 4× Spark에 겨우 들어갈지 모르겠다고 적었다. jwarner는 네이티브 FP8로 읽고, 2× Spark에는 4비트나 하이브리드 4비트가 필요하다고 했다. 이 글이 그 추정을 재지 않는다. 포럼이 남긴 하드웨어 감각이다. Unsloth 문서는 1비트가 총 메모리(RAM+VRAM) 100GB, 3비트가 128GB라고 적는다. 그것도 Unsloth 쪽 문장이다. Z.ai 카드의 VRAM이 아니다.
1) 가중치 받기
공식 기본은 FP8이다. Hugging Face Hub CLI로 받는다.
pip install -U "huggingface_hub[cli]"
huggingface-cli download zai-org/GLM-5.3-Flash --local-dir GLM-5.3-Flash
BF16이 필요하면 저장소만 zai-org/GLM-5.3-Flash-BF16으로 바꾼다. 디스크는 위 표보다 여유를 둔다. 인덱스·토크나이저·processor_config.json이 같이 온다. Hugging Face 토론에서 공식 쪽 ZHANGYUXUAN-zR은, 파일을 덜 받으면 processor_config.json을 못 찾는다고 적었다. 로컬 경로를 넘기면 해결됐다는 후속이 있다.
8월 27일 0:30(UTC+8) 이전에 받은 사람은 채팅 템플릿을 다시 받으라는 공지가 공식 저장소 토론(discussion 18)에 고정돼 있다. 그 시각 이후 받은 사본은 그 공지를 다시 적용할 필요가 없다.
2) 런타임 고르기
공식 README와 HF 카드가 이름을 올린 로컬 경로는 여섯이다. SGLang, vLLM, TokenSpeed, Transformers, KTransformers, Unsloth. 이 글은 사용자가 실제로 켤 가능성이 큰 둘—vLLM과 SGLang—과, 공식 카드가 가리키는 Unsloth GGUF만 적는다. llama.cpp는 공식 README에 이름이 없다.
vLLM 공식 레시피(recipes.vllm.ai/zai-org/GLM-5.3-Flash, 페이지 표기 업데이트 2026-08-27)는 이렇게 못 박는다. 가중치 약 306GiB. vLLM은 공개 저장소에 통합되기 전이라 도커를 쓰라고 한다. FlashInfer 0.6.17 이상(트러블슈팅은 0.6.18+). 기본 모델 ID는 FP8. NVIDIA Hopper 이상, AMD Instinct gfx950. 예제 커맨드는 GB200 트레이 하나에서 TP4다. 공식 쪽 HF 토론도 docker pull vllm/vllm-openai:glm53-flash를 가리킨다.
vllm serve zai-org/GLM-5.3-Flash \
  --tensor-parallel-size 4 \
  --kv-cache-dtype fp8 \
  --speculative-config '{"method":"mtp","num_speculative_tokens":5}' \
  --tool-call-parser glm47 \
  --reasoning-parser glm45 \
  --enable-auto-tool-choice \
  --served-model-name zai-org/GLM-5.3-Flash
위 블록은 vLLM 레시피의 “FP8 with TP4 and MTP on one GB200 tray”를 그대로 옮긴 것이다. --kv-cache-dtype fp8는 그 예제가 Blackwell용으로 붙인 플래그다. 같은 페이지는 Hopper에서 이 모델의 FP8 KV를 지원하지 않아 BF16 KV로 가라고 적는다. 공개 PyPI 휠만 깔고 켜면 선형 어텐션 모듈을 못 찾는 크래시가 HF 토론에 있다. 레시피가 가리키는 도커를 쓰는 쪽이 공식 경로다.
SGLang 공식 쿡북(cookbook.sglang.io/.../GLM-5.3-Flash)은 전용 이미지를 먼저 받는다.
docker pull lmsysorg/sglang:glm-5.3-flash
페이지는 하드웨어와 전략(Low Latency / High Throughput)을 고르면 전체 docker run을 만들어 준다고 적는다. 검증 배지가 붙은 조합은 그 패널이 H100·H200·B200·GB300 쪽이다. AMD ROCm은 High Throughput만, 멀티모달은 미검증이다. 본문에 고정으로 박힌 실행 예제는 4× GB300 인코더 분리다. 인코더를 먼저 켠 뒤 언어 서버를 붙인다. 아래는 쿡북 문장 그대로다.
sglang serve \
  --model-path zai-org/GLM-5.3-Flash \
  --tp-size 4 \
  --encoder-only \
  --host 0.0.0.0 \
  --port 30001

sglang serve \
  --model-path zai-org/GLM-5.3-Flash \
  --tp-size 4 \
  --ep-size 4 \
  --attention-backend dsa \
  --dsa-prefill-backend tilelang \
  --dsa-decode-backend tilelang \
  --linear-attn-backend triton \
  --kv-cache-dtype bfloat16 \
  --quantization fp8 \
  --moe-runner-backend deep_gemm \
  --max-running-requests 64 \
  --chunked-prefill-size 8192 \
  --max-prefill-tokens 8192 \
  --disable-shared-experts-fusion \
  --disable-prefill-cuda-graph \
  --speculative-algorithm EAGLE \
  --speculative-num-steps 3 \
  --speculative-eagle-topk 1 \
  --speculative-num-draft-tokens 4 \
  --speculative-adaptive \
  --language-only \
  --encoder-urls http://localhost:30001 \
  --mem-fraction-static 0.78 \
  --host 0.0.0.0 \
  --port 30000
이 토폴로지는 이미지와 최대 238,080 시각 토큰 영상까지 서빙했다고 쿡북이 적는다. 노트북에서 켠다는 뜻이 아니다. 일반 채팅은 같은 페이지의 배포 패널이 만드는 커맨드를 따른다.
3) llama.cpp는 아직 착륙 중
공식 카드는 llama.cpp를 적지 않는다. 공식 README가 가리키는 Unsloth 가이드는 자기 llama.cpp PR #27754(제목: model: add GLM-5-Next (GLM-5.3-Flash)) 또는 Unsloth Desktop을 쓰라고 한다. 이 글을 확인하는 시각, 그 PR은 여전히 Draft다. mainline llama.cpp에 머지되지 않았다. Unsloth가 적어 둔 빌드는 포크 브랜치다.
git clone --branch glm5next/upstream https://github.com/unslothai/llama.cpp
cmake llama.cpp -B llama.cpp/build \
    -DBUILD_SHARED_LIBS=OFF -DGGML_CUDA=ON
cmake --build llama.cpp/build --config Release -j --clean-first \
    --target llama-cli llama-mtmd-cli llama-server llama-gguf-split
실행 예제는 Unsloth 문서의 UD-IQ3_XXS다. 양자화 종류는 표의 파일 이름과 맞춰 바꾼다.
hf download unsloth/GLM-5.3-Flash-GGUF \
    --local-dir unsloth/GLM-5.3-Flash-GGUF \
    --include "*UD-IQ3_XXS*"
./llama.cpp/llama-cli \
    --model unsloth/GLM-5.3-Flash-GGUF/UD-IQ3_XXS/GLM-5.3-Flash-UD-IQ3_XXS-00001-of-00004.gguf \
    --temp 1.0 \
    --top-p 0.95 \
    --chat-template-kwargs '{"reasoning_effort":"max"}'
AtomicChat GGUF 카드도 같은 한계를 적는다. “quants are still uploading and need a llama.cpp build with GLM-5.3-Flash support.” 메인라인에 착륙하기 전에는 Ollama·LM Studio 원클릭을 기대해선 안 된다. AtomicChat이 적어 둔 llama-server -hf ... --jinja는, 그 지원이 들어온 빌드가 있을 때의 문장이다.
4) 비전·멀티모달 쓰는 법
vLLM 레시피는 OpenAI 호환 멀티파트로 이미지와 영상을 넣는다. 채팅 템플릿이 <|begin_of_image|> / <|begin_of_video|> 자리 표시로 펼친다.
curl http://localhost:8000/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{
    "model": "zai-org/GLM-5.3-Flash",
    "messages": [{
      "role": "user",
      "content": [
        {"type": "image_url", "image_url": {"url": "https://example.com/image.png"}},
        {"type": "text", "text": "Describe the image."}
      ]
    }],
    "max_tokens": 512
  }'
영상은 같은 자리에서 video_url이다. SGLang 쿡북은 모든 전략이 멀티모달을 켠다고 적는다. 프로세서는 비디오를 2FPS로 샘플링하고 시각 토큰을 240,000개로 캡한다. 비디오를 보내려면 서빙 환경에 torchcodec을 깔라고 한다. 4× GB300에서 아주 긴 영상은 인코더 분리를 쓰라고 한다.
허브 토론에는 “모델이 멀티모달이 아니냐”는 질문이 올라왔다. 공식 쪽은 채팅 템플릿 업데이트 스레드(discussion 18)를 가리켰고, 템플릿에서 비전을 뺀 것처럼 보인 커밋은 “incorrect, so it needs to be updated”라고 답했다. 비전 경로가 문서에 있다고 해서, 받은 템플릿이 항상 최신은 아니다. 8월 27일 0:30(UTC+8) 이후 템플릿을 다시 받는 쪽이 안전하다.
사고 예산은 요청마다 고른다. vLLM 레시피 기본은 max다. 낮추려면 본문에 chat_template_kwargs: {"reasoning_effort": "low"}를 넣는다. 채팅에서는 clear_thinking=true를 넘기라고 README Note가 적는다. 벤치를 재현할 때는 기본 max를 유지하라고 한다.
왜 막히나
막히는 지점은 두 층이다. 첫째는 디스크다. 활성 18B가 저장 용량을 줄여 주지 않는다. FP8만 306GiB다. 둘째는 아키텍처다. 하이브리드 희소+선형 어텐션과 mHC는 기존 llama.cpp / 구버전 vLLM에 없다. 모델 타입 태그는 glm5_next다. SGLang은 전용 이미지, vLLM은 glm53-flash 도커, llama.cpp는 Unsloth 포크 PR이 아직 Draft인 이유다. HF 토론의 Glm5NextTextLinearAttention 모듈 누락, Blackwell에서 pe_dim must be 64 for fp8_ds_mla는 그 층의 증상이다.
실사용자 반응
가중치가 열리자마자 방은 실리콘을 세는 쪽으로 모였다. NVIDIA 개발자 포럼 GLM-5.3-Flash weights released (Ox Alpha)는 8월 26일 coder543이 열었다. 예전 이름 Ox Alpha, 320B-A18B, 1M 컨텍스트, 이미지+텍스트, MIT. jbitt는 “Qwen 3.8 27B와 DeepSeek V4F보다 점프가 있고 비전이 따라온다. MIT가 좋다”고 적고, vLLM 0.28.0에서 4× Spark에 올릴지를 물었다. jwarner는 “네이티브 FP8. 2× Spark에는 4비트나 하이브리드 4비트가 필요하다”고 했다. jbitt가 Files 탭을 다시 보면 Flash는 328GB로 DSv4F 0731(160GB)보다 무겁고, “4× Spark에 겨우 들어갈지 모르겠다”는 문장이다. 다음 날 emX0r는 Unsloth 3비트가 싱글 GB10에서 돈다고 링크를 붙였고, coder543은 IQ3_XXS가 싱글 Spark 한도에 불편하게 가깝다고 되물었다.
허브 토론은 서빙 마찰이다. luonist는 vLLM 나이틀리를 깔고 레시피를 따랐다가 Glm5NextTextLinearAttention 모듈이 없다고 올렸다. 공식 쪽 답은 docker pull vllm/vllm-openai:glm53-flash다. 도커로 바꿔도 processor_config.json 경로를 못 찾았고, HF 모델 이름 대신 로컬 경로를 넘기면 해결됐다. NferKarn은 RTX PRO 6000 Blackwell에서 pe_dim must be 64 for fp8_ds_mla로 죽었다. seemsee는 4× Blackwell에서 같은 오류를 보고 임시 패치를 올렸다. 토큰/초 숫자는 그 스레드에 커뮤니티 값이 있지만, 이 글은 재지 않는다.
공식 저장소 토론 18은 채팅 템플릿 재다운로드 공지다. 비전을 템플릿에서 뺀 것처럼 보인 커밋에 공식은 “incorrect”라고 답했다. 멀티모달 가중치가 나중에 온다는 뜻이 아니라, 그때 올린 템플릿 커밋이 틀렸다는 뜻이다.
의미와 시사점
노트북과 멀티 GPU는 같은 모델 이름이어도 다른 물건이다. 공식 FP8은 vLLM 레시피가 GB200 트레이에서 TP4를 예시로 든다. SGLang 검증 배지도 데이터센터 GPU 쪽이다. 랩톱에서 켜고 싶다면 공식 카드가 가리키는 쪽은 Unsloth GGUF와 Unsloth Desktop이다. 그때도 Unsloth가 말하는 총 메모리는 1비트 100GB, 3비트 128GB다. 16GB 노트북 한 대의 칸이 아니다.
GGUF와 FP8은 목적이 갈린다. FP8은 공식 체크포인트다. 서빙 레시피·비전 예제·도구 파서가 그 위에 올라 있다. GGUF는 용량을 깎는 우회다. Unsloth는 자기 1비트가 BF16 대비 85% 작고 top-1% 정확도의 71%를 남긴다고 적는다. 그 숫자는 Unsloth 측정이다. AtomicChat은 텍스트 경로만 이 저장소가 덮는다고 적는다. 비전을 공식 레시피대로 쓰려면 FP8/BF16과 vLLM·SGLang 쪽이 문서와 맞다.
GPU가 없거나, 디스크 306GiB를 비울 이유가 없으면 Z.ai API와 Coding Plan이 그 칸이다. 공식 개발자 문서는 Flash가 Coding Plan 전 구간에 들어 있고, 할당량은 GLM-5.3의 3배라고 적는다. MIT 가중치를 받아 고칠 권리와, 호스팅 약관은 다른 문서다. 로컬이 필요 없으면 API를 쓰면 된다. 로컬이 필요하면 공식 도커와 위 표를 먼저 본다.
마치며
GLM-5.3-Flash를 로컬에서 돌리는 법은 짧다. 가중치를 Hugging Face에서 받고, 공식 README가 가리키는 런타임으로 켠다. FP8은 306GiB다. vLLM은 vllm/vllm-openai:glm53-flash, SGLang은 lmsysorg/sglang:glm-5.3-flash다. llama.cpp는 공식 카드에 없고, Unsloth PR은 이 시각 Draft다. 공식 카드에 VRAM 숫자는 없다. 4× Spark에 겨우 들어간다는 말은 포럼의 추정이다.
오늘 받아서 켤 수 있는 공개 가중치는 Flash다. 플래그십 5.3은 README 표에 행이 생겼지만, Hugging Face 페이지는 아직 카운트다운이다. 화면을 같이 보는 320B-A18B를 자기 기계에 올리려면, 먼저 디스크를 비운다.
출처
- Hugging Face: zai-org/GLM-5.3-Flash · BF16
- GitHub README: zai-org/GLM-5
- Z.ai 공식 글: GLM-5.3-Flash: Frontier Intelligence, Flash Cost
- Z.ai 개발자 문서: GLM-5.3-Flash Overview
- vLLM 레시피: zai-org/GLM-5.3-Flash
- SGLang 쿡북: GLM-5.3-Flash
- Unsloth 가이드: GLM-5.3 · How to Run Locally · GGUF
- AtomicChat GGUF: AtomicChat/GLM-5.3-Flash-GGUF
- llama.cpp PR (Draft): #27754 add GLM-5-Next (GLM-5.3-Flash)
- NVIDIA 포럼 (2026-08-26): GLM-5.3-Flash weights released (Ox Alpha)
- HF 토론: chat template update · vllm crash: Glm5NextTextLinearAttention · The model isn't multimodal???
- 출시 맥락(이 블로그): 큰 모델이 먼저 안 왔다
이 글은 AI가 작성하여 자동 발행된 콘텐츠입니다.