
큰 모델이 먼저 안 왔다: GLM-5.3-Flash가 MIT로 풀린 이유
어제 Hugging Face에 앉은 건 플래그십 GLM-5.3이 아니라 Flash다. 320B 중 18B만 켜고 MIT로 가중치가 풀렸고, 플래그십 행은 아직 GitHub 다운로드 표에 없다.

핵심 요약 (TL;DR)
어제 내려받을 수 있게 된 건 플래그십 GLM-5.3이 아니다. Z.ai는 2026년 8월 26일 GLM-5.3-Flash를 풀었다. GLM-5 시리즈에서 처음으로 네이티브 멀티모달—텍스트만이 아니라 이미지와 영상을 모델이 처음부터 받는다—이다. 총 파라미터 3,200억(320B) 가운데 한 토큰에 켜지는 건 180억(18B)이다. 라이선스는 MIT다. 가중치는 Hugging Face zai-org/GLM-5.3-Flash와 BF16 변형에 앉아 있다.
할 수 있는 일부터 적는다. MIT 가중치를 받아, GPU가 충분하면 SGLang·vLLM·TokenSpeed·KTransformers로 로컬에 올린다. 텍스트와 비전을 한 모델에서 돌린다. 서빙 비용이 싼 이유는 3,200억을 매번 다 켜지 않기 때문이다. 공식 README는 GLM-5.2를 벤치와 실제 작업에서 이기고, 가격은 약 10분의 1이며, 코딩·에이전트 벤치에서는 Claude Opus 4.8에 근접한다고 적는다. 그 숫자는 랩이 재서 올린 것이다.
용어를 한 번만 풀어 둔다. 가중치는 모델이 학습해 둔 숫자 파일이다. 내려받으면 그 모델을 자기 기계에서 돌릴 수 있다. MoE(전문가 혼합, Mixture of Experts)는 작은 전문가 네트워크를 많이 두고, 토큰마다 일부만 고르는 구조다. 활성 파라미터는 그때 실제로 켜지는 부분이다. Flash는 320B 중 18B다. 멀티모달은 글만이 아니라 그림·영상을 같이 받는다는 뜻이다. 양자화는 숫자를 더 거칠게 줄여 용량과 메모리를 깎는 일이다. GGUF는 그 줄인 파일을 로컬에서 돌리기 쉽게 담는 형식이다.
배경 및 맥락
한 주 앞선 8월 14일, Z.ai는 GLM-5.3 API를 열었다. 공식 문장은 분명하다. GLM-5.2와 같은 베이스를 쓰고, 이득은 전부 사후학습에서 왔다. 코딩이 세졌고, 사이버 능력이 랩이 기대한 속도보다 빨리 커졌다. 그래서 가중치는 출시 당일이 아니라 “출시 후 2주, 안전 평가와 경화가 끝난 뒤”에 풀겠다고 했다. 그 창은 대략 8월 28일이다. 이 글을 확인하는 2026-08-27 오전(한국 시간) 기준, GitHub README의 Download Model 표에는 GLM-5.3-Flash, GLM-5.2, GLM-5.1, GLM-5만 있다. GLM-5.3 플래그십 가중치 행은 없다. Hugging Face에 zai-org/GLM-5.3 공개 저장소도 이 시각에 열려 있지 않다. 큰 모델이 먼저 온 날이 아니다.
그 빈칸을 Flash가 채웠다. 공식 블로그는 공개 전에 이 모델을 OpenCode와 OpenRouter에서 ox-alpha라는 익명으로 돌렸다고 적는다. 그 주 가장 많이 쓰인 모델이 됐고, 트래픽은 중국산 AI 칩에서 나갔다. 8월 26일 Z.ai가 이름을 붙였다. NVIDIA 개발자 포럼 글 제목도 그 순서다. “GLM-5.3-Flash weights released (Ox Alpha).”
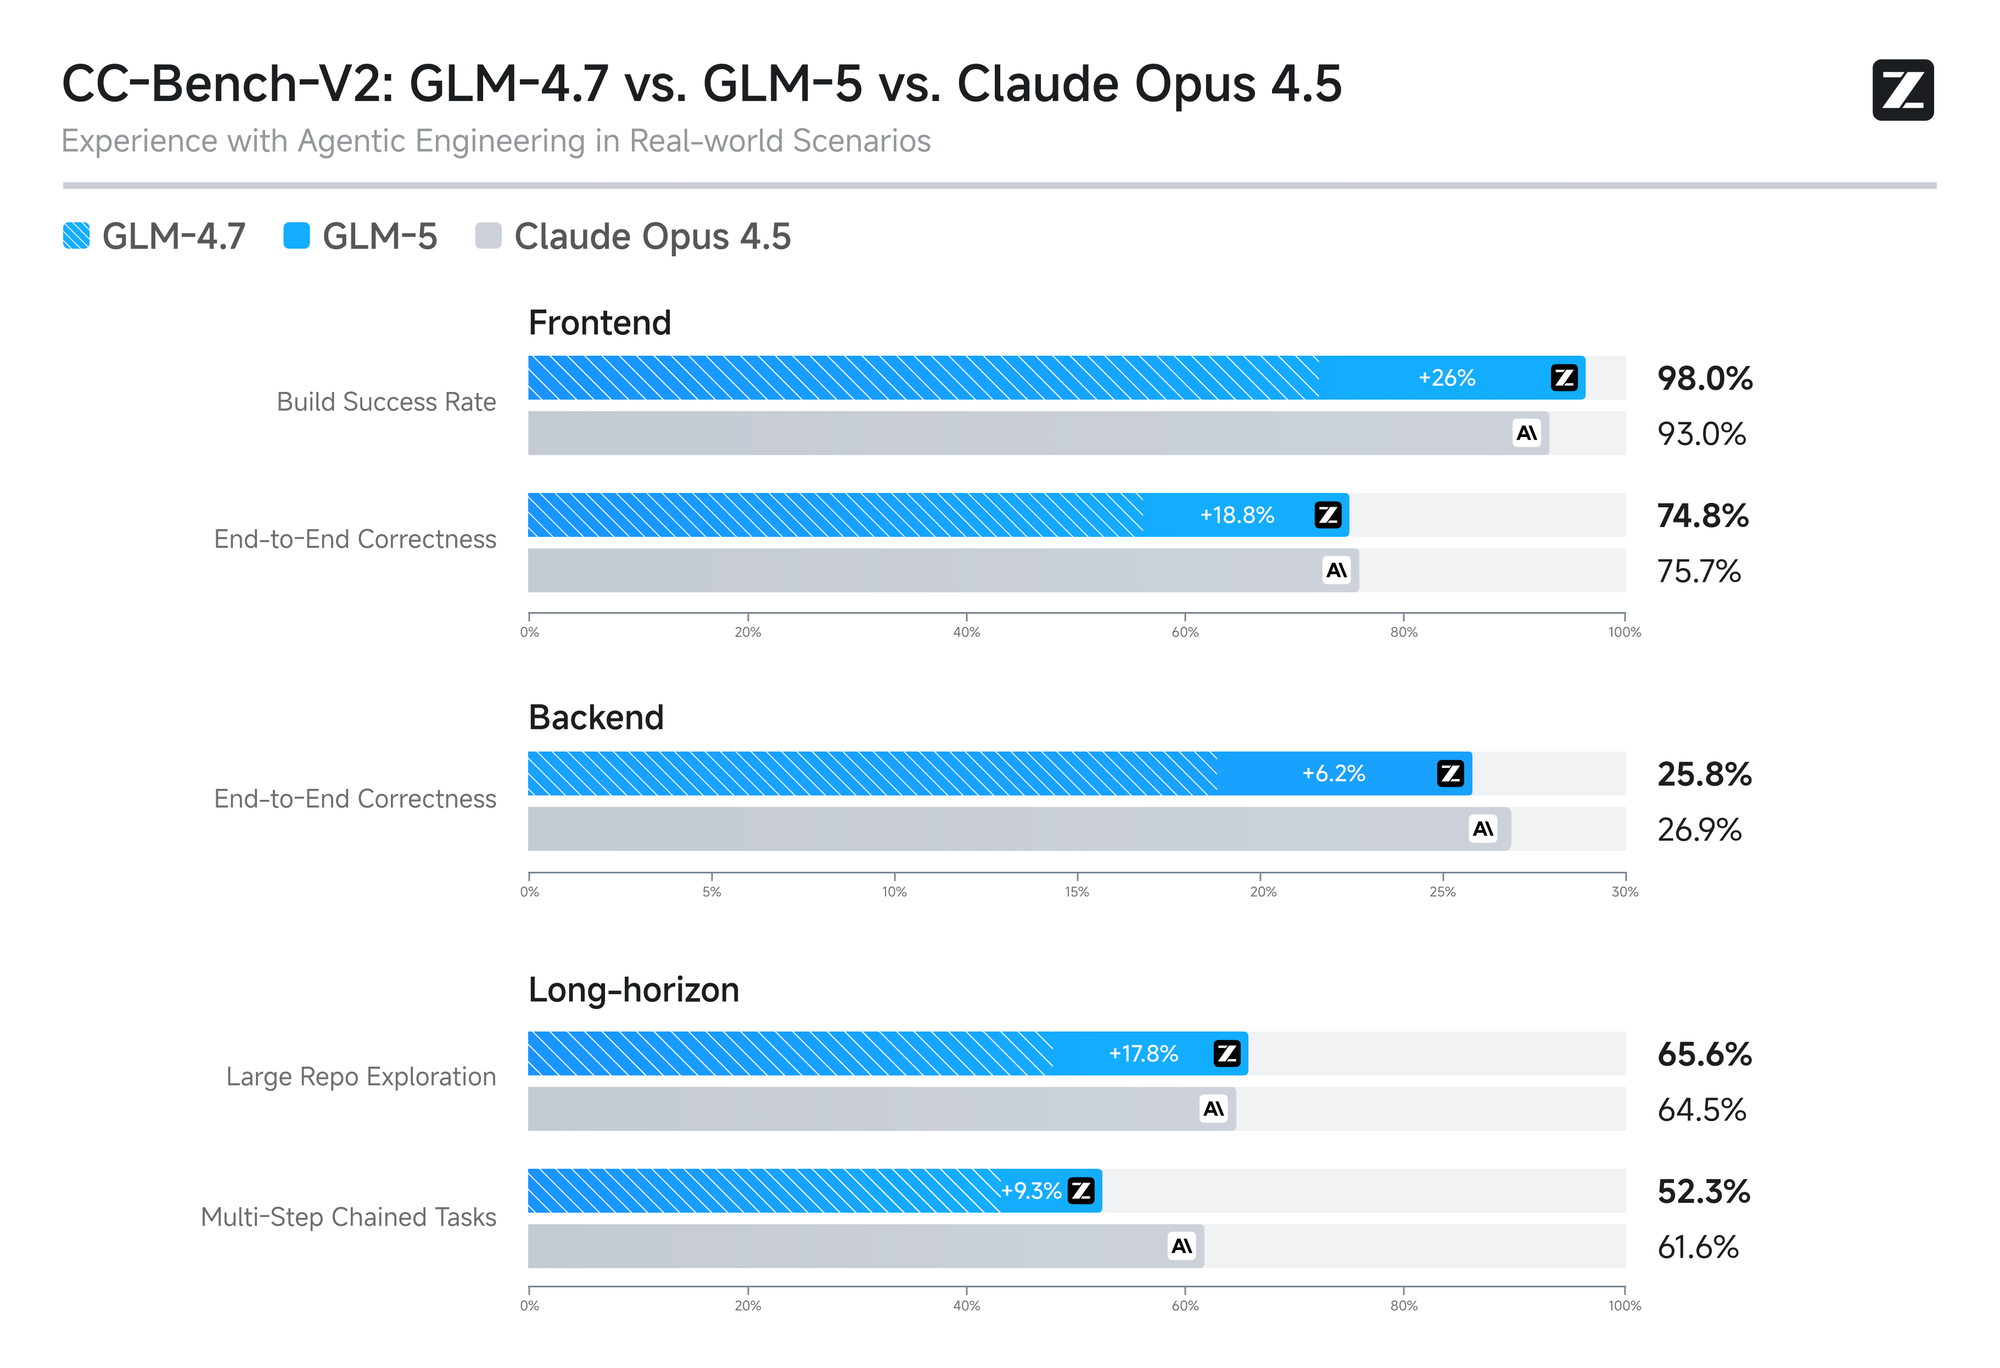
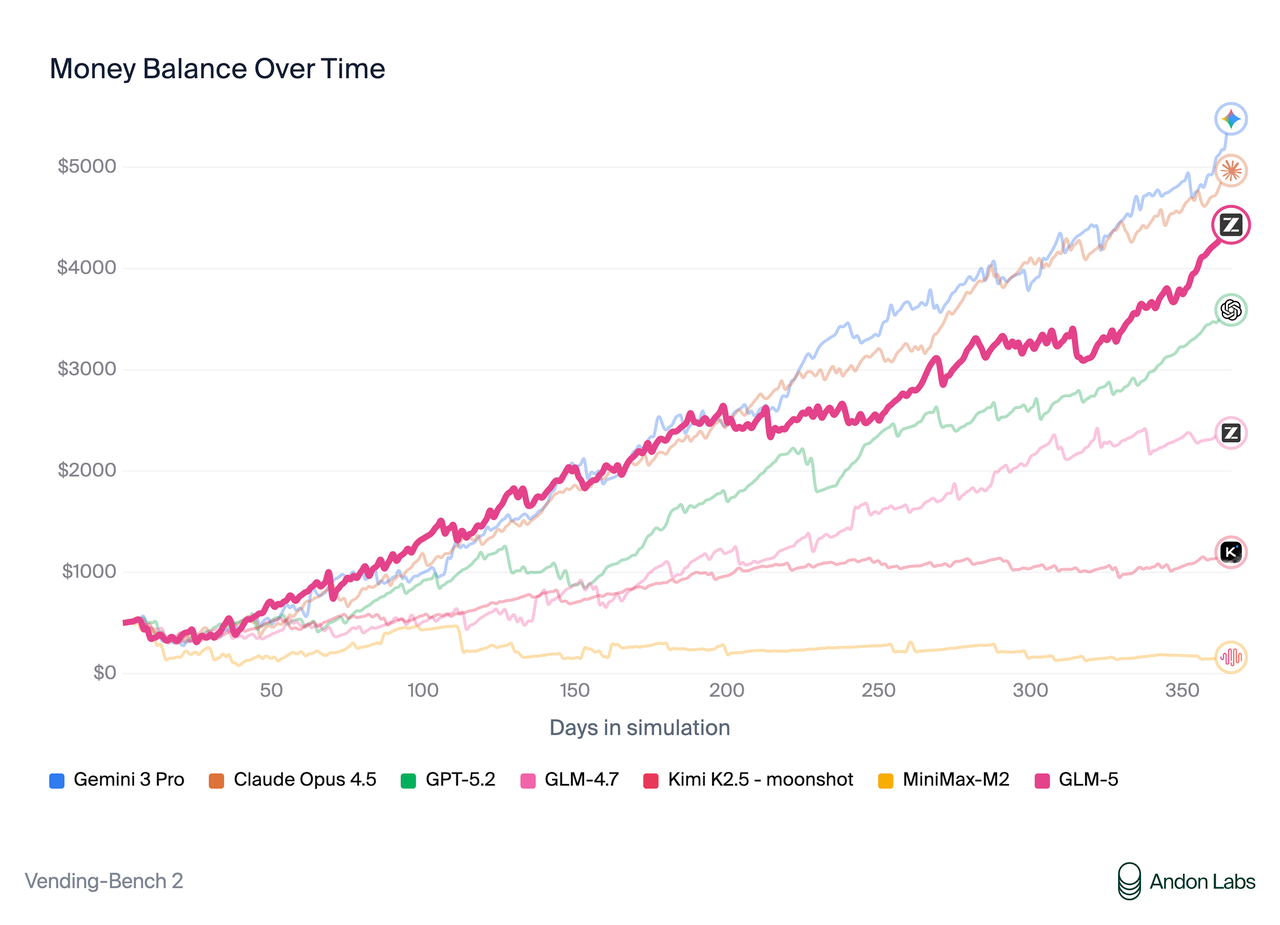
패밀리의 자리는 이미 있었다. GLM-5는 총 744B, 활성 40B로 올라 코딩·장기 에이전트 작업을 겨냥했다. README는 내부 CC-Bench-V2에서 GLM-4.7을 크게 앞섰고, Vending Bench 2에서는 오픈소스 1위, 최종 잔고 4,432달러로 Claude Opus 4.5에 근접했다고 적는다. 아래 두 장은 그 패밀리 차트다. Flash 차트가 아니다. Flash가 어디서 왔는지를 보여 주려고 둔다.
주요 내용 분석
내려받는 것과, 아직 안 오는 것
공식 다운로드 표는 한눈에 갈린다. Flash는 320B-A18B. FP8이 기본이고 BF16이 옆에 있다. GLM-5.2는 744B-A40B, BF16과 FP8이 이미 허브에 있다. 라이선스는 둘 다 Hugging Face 카드가 MIT다. Flash의 LICENSE 파일 첫 줄은 MIT License, 저작권은 2026 Z.AI Co., Ltd다. 플래그십 5.3은 그 표에 칸이 없다. 공식 5.3 글의 마지막 배포 문장도 그대로다. “The model weights of GLM-5.3 will be publicly available soon in two weeks.”
| 칸 | GLM-5.3-Flash | GLM-5.2 | GLM-5.3 플래그십 |
|---|---|---|---|
| 총 / 활성 파라미터 | 320B / 18B (README·공식 블로그) | 744B / 40B (README 표) | 공식 글: GLM-5.2와 같은 베이스. 가중치 파일은 아직 없음 |
| 라이선스 | MIT (HF LICENSE, 카드) | MIT (HF 카드) | 가중치 미공개. 이 시각에 라이선스 파일을 확인할 칸이 없다 |
| 비전 | 시리즈 첫 네이티브 멀티모달. config에 vision과 image/video 토큰 | 텍스트 플래그십. README가 네이티브 비전이라 적지 않음 | 같은 베이스. 네이티브 멀티모달은 Flash가 처음이라고 공식은 적는다 |
| 가중치 | 8월 26일 HF·ModelScope. FP8 62샤드, BF16 별도 저장소 | HF에 BF16·FP8 | 8월 14일 API. README 다운로드 표에 행 없음 (2026-08-27 오전) |
| 가격 주장 | 5.2 대비 약 1/10. AA Intelligence Index v4.1.1 57점, 할인 티어 작업당 0.045달러 | 비교 기준 | Coding Plan에서 Flash 할당량은 5.3의 3배라고 공식 블로그가 적는다 |
| 로컬 서빙 | SGLang, vLLM, TokenSpeed, KTransformers (README) | SGLang, vLLM, Transformers, KTransformers, Unsloth 등 | “soon in two weeks.” 로컬 칸은 아직 안 열렸다 |
표의 빈칸은 빈칸이다. 플래그십 가중치가 오늘 새벽에 떨어졌다면 README와 허브가 그 행을 보여 줬을 것이다. 안 보여 준다. 5.3을 받아 로컬에 올린다는 문장은 이 시각의 사실이 아니다.
18B만 켜고, 1M을 버티는 구조
Flash는 5.2를 양자화한 축소판이 아니다. 공식은 새로 학습한 베이스에서 시작했다고 적는다. GLM 시리즈 처음으로 희소 어텐션과 선형 어텐션을 섞는 하이브리드다. 긴 문맥의 서빙 비용을 깎으면서 정밀도는 유지하겠다고 한다. 스케일 효율을 위해 Manifold-Constrained Hyper-Connections(mHC)를 넣었다. 사전학습 코퍼스는 최신 30T 토큰 멀티모달이다. config.json도 그 문장을 받는다. mhc: true, max_position_embeddings: 1048576. 라우팅된 전문가 288개, 토큰당 8개, 공유 전문가 1개, 레이어 45개. 공식 블로그는 GLM-4.5(355B, 활성 32B, 92레이어)와 견줘, 총량은 비슷한데 활성과 깊이를 거의 반으로 줄였다고 적는다. GLM-5.3 대비 어텐션 연산은 3.0배, KV 캐시는 4.4배 작다고 한다. 1M 토큰에서 인덱서 부담을 줄이려고 IndexPool을 넣었다고도 한다.
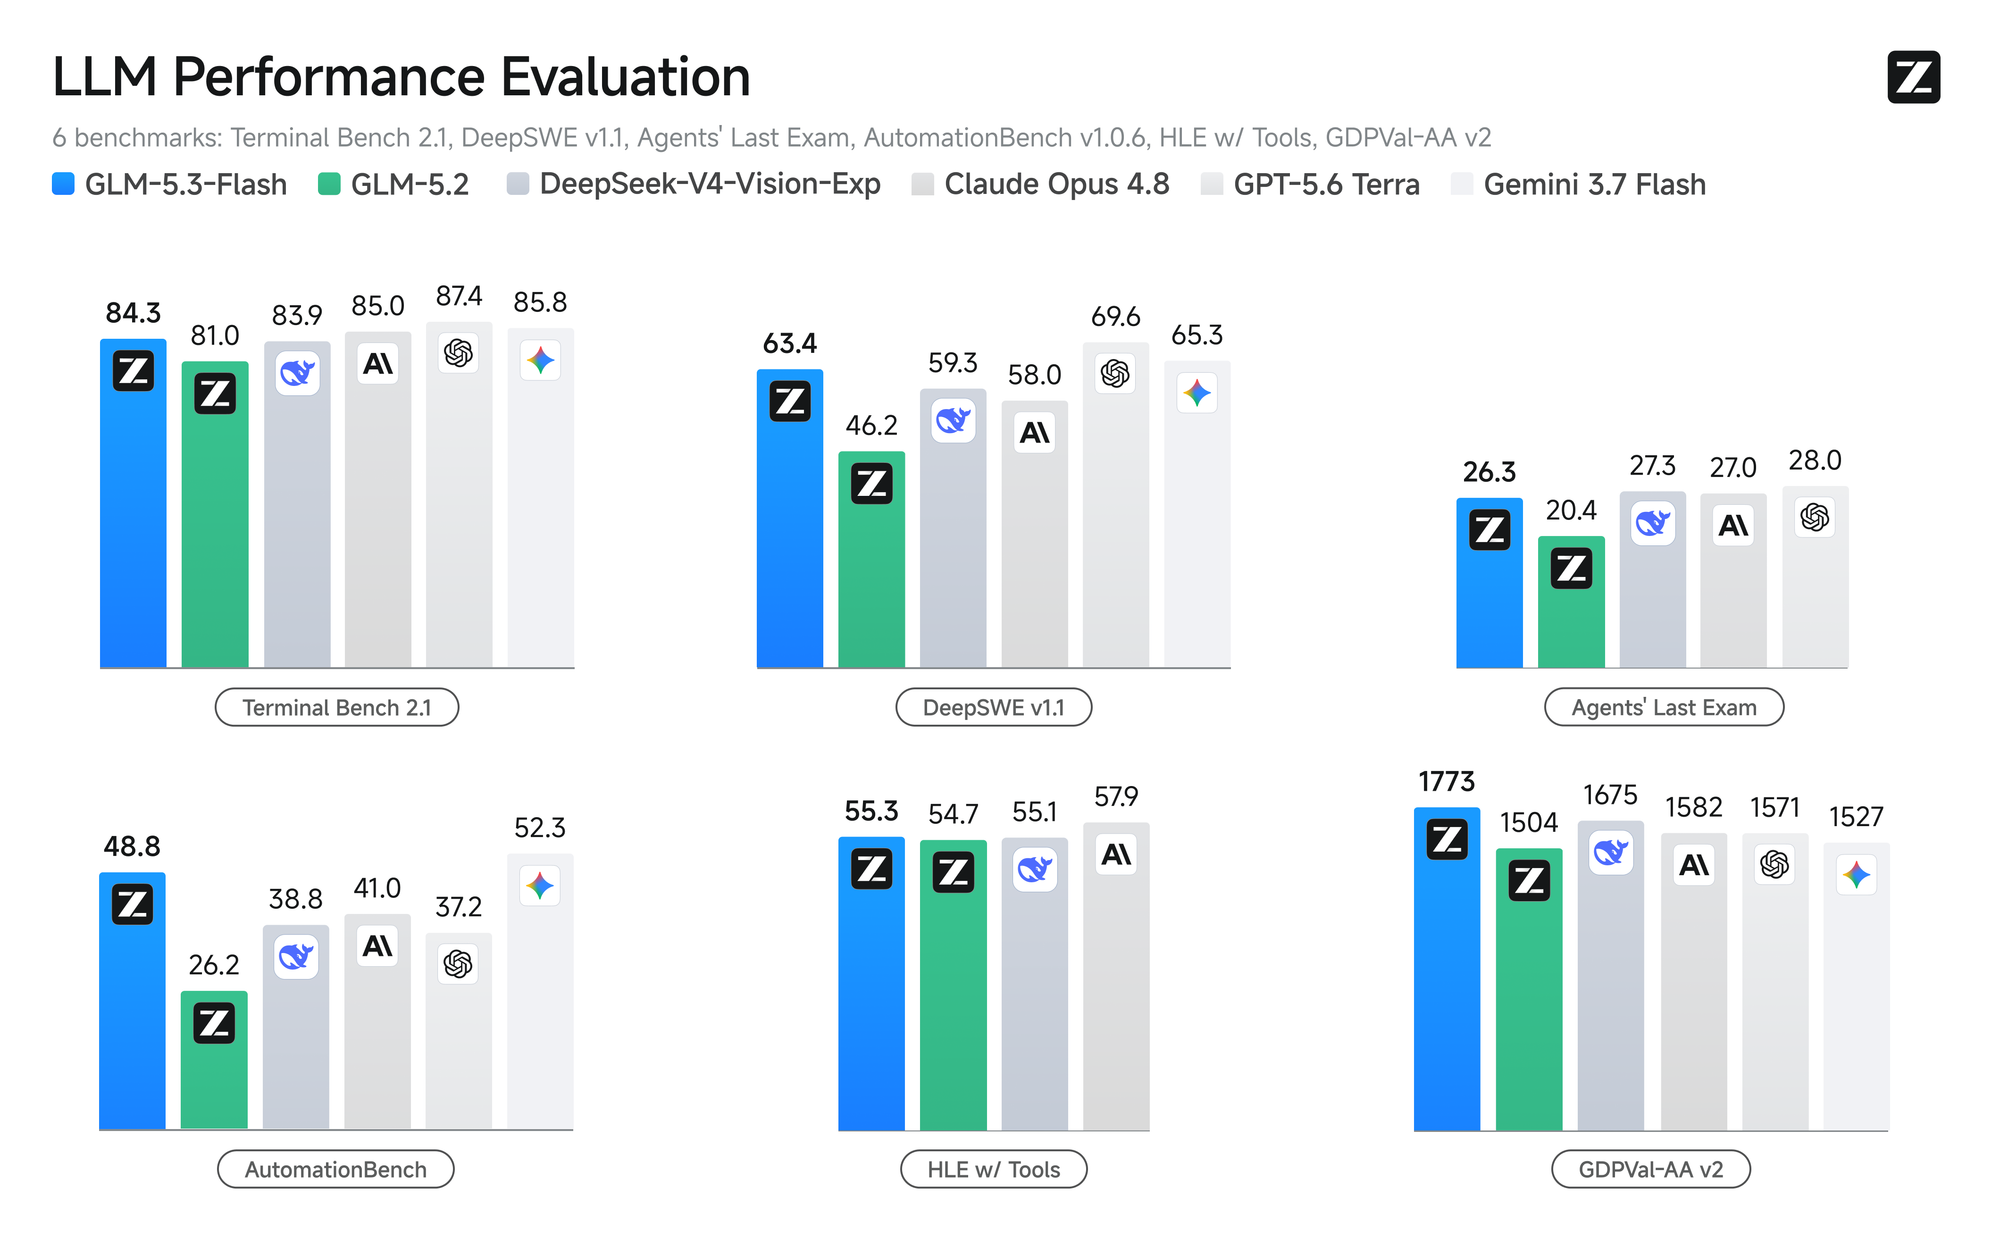
벤치 숫자는 랩이 재서 올린 표다. Terminal-Bench 2.1에서 Flash 84.3, GLM-5.2 81.0, Opus 4.8 85.0. DeepSWE v1.1은 63.4 대 46.2 대 58.0. AutomationBench v1.0.6은 48.8 대 26.2 대 41.0. 사내 Z.ai Code Bench v1.0(Claude Code 2.1.207)에서는 최대 노력에서 29.0, Opus 4.8은 29.5다. Artificial Analysis Intelligence Index v4.1.1은 57점, 할인 티어 작업당 0.045달러. “이전에 대략 10배 비용에서나 나오던 지능”이라고 공식은 적는다. 각주는 하네스와 샘플링을 밝힌다. DeepSWE는 mini-swe-agent 하네스, Terminal-Bench 2.1은 Claude Code 2.1.207, NL2Repo는 1M 컨텍스트다. 독립 재현은 가중치가 열린 뒤에야 시작한다.
비전도 코딩 루프 안에 넣겠다는 문장이다. 프론트·게임·3D처럼 결과는 코드가 아니라 화면이다. 공식은 모델이 자기 출력을 보고 고치는 궤적을 합성했다고 적는다. Hugging Face 태그는 image-text-to-text다. config에 이미지·비디오 시작/끝 토큰이 있다. 노트북 한 대로 도는 크기는 아니다. 공식 FP8 샤드는 62개, 허브 Files 탭을 NVIDIA 포럼 사용자가 328GB로 읽었다. 충분한 GPU가 없으면 API와 Coding Plan이 그 칸이다. 공식은 Coding Plan 전 구간에 Flash를 넣었고, 사용 가능한 할당량은 GLM-5.3의 3배라고 적는다. ZCode에서는 Browser Use와 Computer Use로 멀티모달을 연다.
실사용자 반응
가중치가 열리자마자 방이 두 개 생겼다. 하나는 실리콘을 세는 방이고, 하나는 점수를 읽는 방이다.
NVIDIA 개발자 포럼 스레드 GLM-5.3-Flash weights released (Ox Alpha)는 8월 26일 coder543이 열었다. 예전 이름 Ox Alpha, 320B-A18B, 1M 컨텍스트, 이미지+텍스트, MIT. jbitt는 Qwen 3.8 27B와 DeepSeek V4 Flash보다 점프가 있고 비전이 따라온다고 적는다. MIT를 좋다고 한다. 바로 vLLM 0.28.0에서 4× Spark에 올릴지를 묻는다. jwarner는 네이티브 FP8 릴리스로 읽고, 2× Spark에는 4비트나 하이브리드 4비트가 필요하다고 한다. jbitt가 허브 Files 탭을 다시 보면 Flash는 328GB로 DSv4F 0731(160GB)보다 무겁다. 4× Spark에 겨우 들어갈지 모르겠다는 문장이다. 이 글이 그 추정을 재지 않는다. 포럼이 남긴 하드웨어 감각이다.
허브에는 공식 저장소 옆에 양자화 층이 바로 붙었다. 이 글을 확인하는 시각, unsloth/GLM-5.3-Flash-GGUF가 검색 상단에 있고 좋아요는 100을 넘긴다. 커뮤니티 GGUF·NVFP4·MLX 변환이 같은 검색에 여러 줄이다. 공식 README가 가리키는 로컬 경로는 SGLang·vLLM·TokenSpeed·KTransformers다. GGUF는 랩이 공식 칸에 올리지 않았다. 커뮤니티가 연 우회다.
Hacker News에는 공식 블로그 링크 스레드가 있다. item 49449507, 이 시각 기준 838포인트, 댓글 420개. 첫 댓글 mmastrac가 HF 가중치 링크를 붙이고 4× Spark를 산 이유를 적는다. Opus 4.8급 로컬은 아직 못 봤다는 유보다. bertili는 한 달 타임라인을 압축한다. Kimi K3, GLM-5.3, 그리고 12일 뒤 Flash. 파라미터와 가격을 한 번 더 깎았다는 읽기다. mrngld는 공식 차트가 Opus 4.8을 상대하는 동안 Opus 5가 나와 있다고 지적한다. DeepSWE 리더보드를 보면 점수는 괜찮으니, 구식 상대만 빼면 글이 더 세진다는 문장이다. 다른 줄은 Qwen 3.8 27B 로컬과 Flash를 같은 방에 두고 싸운다. 이 글이 그 승부에 점수를 보태지 않는다. 가중치가 열린 첫날의 공개 발언이다.
Bloomberg는 같은 날 Ox Alpha가 Z.ai의 스텔스 모델이었다고 전한다. HN item 49446422가 그 기사를 받는다. 댓글 한 줄이 이 글의 논지와 같다. “GLM 5.3 weights are not yet released. The release date is supposed to be August 28th 2026.” Flash와 플래그십을 한 저장소로 접지 말라는 경고가, 이미 그 방에 있다.
의미와 시사점
오늘 칸이 새로 깐 것은 플래그십 공개가 아니다. 플래그십을 2주 붙잡아 둔 랩이, 그 창 안에서 더 작고 더 싼 네이티브 멀티모달을 MIT로 먼저 열었다는 칸이다. 5.3 공식 글은 사이버 능력이 사후학습을 따라 커진 속도를 이유로 가중치를 미뤘다. Flash 공식 글은 그 미룬 주간에 ox-alpha로 트래픽을 받아 보고, 중국 칩 위에서 서빙 스택을 3배 올렸다고 적는다. 두 글은 같은 집이 쓴 다른 결정이다. 큰 가중치는 안전 창을 받고, 싼 가중치는 MIT로 나간다.
실무자가 가져갈 경계는 넷이다. 첫째, 어제 허브에 앉은 이름을 GLM-5.3으로 부르지 않는다. Flash다. 플래그십 행은 README에 없다. 둘째, 320B를 로컬 요구량으로 읽지 않는다. 활성 18B가 서빙 비용을 깎는 이유고, 파일 용량은 포럼이 328GB로 읽은 FP8이다. GPU가 부족하면 양자화 층을 기다리거나 API를 쓴다. 셋째, Opus 4.8 근접은 랩이 고른 코딩·에이전트 벤치의 문장이다. 공식 표에도 GPT-5.6 Terra와 Gemini 3.7 Flash가 여러 칸에서 위다. HN이 지적한 Opus 5 칸은 그 차트에 없다. 넷째, MIT는 API 약관이 아니다. 가중치를 받아 고치고 다시 배포할 권리와, Z.ai 호스팅 약관은 다른 문서다. HN이 약관을 읽는 줄과, 허브 LICENSE를 읽는 줄을 한 문장으로 접지 않는다.
남는 질문은 8월 28일 전후다. 플래그십 가중치가 실제로 표에 행을 얻는지, Flash와 같은 MIT인지, 사이버 능력을 이유로 한 창이 조건을 바꾸는지. 오늘 확인할 수 있는 파일은 Flash뿐이다.
마치며
Z.ai는 8월 26일 GLM-5.3-Flash 가중치를 MIT로 공개했다. 320B 중 18B가 켜진다. GLM-5 시리즈 첫 네이티브 멀티모달이다. 공식은 5.2를 약 10분의 1 가격에 이긴다고 적고, Terminal-Bench 2.1에서 84.3, DeepSWE v1.1에서 63.4를 자기 표에 올렸다. 허브에는 FP8과 BF16이 있고, 로컬 경로는 SGLang·vLLM·TokenSpeed·KTransformers다. 커뮤니티 GGUF는 하루 안에 붙었다.
8월 14일의 GLM-5.3은 API다. 같은 베이스, 더 센 사후학습, 사이버 능력을 이유로 한 2주 창. 그 창은 아직 안 닫혔다. 큰 모델이 먼저 안 왔다. 먼저 온 것은, 18B만 켜고 화면을 같이 보는 Flash다.
출처
- Z.ai 공식 글 (2026-08-26): GLM-5.3-Flash: Frontier Intelligence, Flash Cost
- Z.ai 공식 글 (2026-08-14): GLM-5.3: Frontier Coding with Emergent Cyber Capabilities
- GitHub README: zai-org/GLM-5
- Hugging Face: zai-org/GLM-5.3-Flash · BF16
- NVIDIA 포럼 (2026-08-26): GLM-5.3-Flash weights released (Ox Alpha)
- Hacker News: GLM-5.3-Flash (item 49449507) · Ox Alpha 기사 스레드 item 49446422
- arXiv 기술 보고: GLM-5: from Vibe Coding to Agentic Engineering
이 글은 AI가 작성하여 자동 발행된 콘텐츠입니다.