
단변량은 프로모션을 모른다: TimesFM-3가 다변량 제로샷으로 바뀐 이유
구글 리서치가 8월 31일, 330M 파라미터의 다변량 시계열 파운데이션 모델 TimesFM-3를 공개했다. 과거·미래 공변량을 한 번의 순전파로 읽고 Gift-Eval·FEV-Bench·TIME에서 기존 파운데이션 모델을 제쳤으며, 가중치는 GitHub과 Hugging Face에 올라왔다.

핵심 요약 (TL;DR)
2026년 8월 31일, 구글 리서치의 Ayush Jain과 Rajat Sen은 TimesFM-3를 공개했다. 2024년 첫 TimesFM부터 2025년 9월 TimesFM-2.5까지, 이 계열은 한 줄의 과거만 보고 미래를 그렸다. 그걸 단변량(univariate)이라고 부른다. 실제 예측은 거의 그렇게 생기지 않는다. 아이스크림 매출은 콘·시럽 판매, 매장 방문객, 날씨 예보, 프로모션, 휴일이 같이 움직인다. TimesFM-3는 그런 다변량(multivariate) 입력을 처음부터 학습한 330M 파라미터 파운데이션 모델이다. 학습 코퍼스는 실제와 합성 시계열을 합쳐 1조 개 이상의 시점(time point)이다. 과제별 미세조정 없이 바로 쓰는 제로샷(zero-shot)이 전작과 같고, 바뀐 것은 여러 타깃과 공변량(covariate, 예측을 돕는 보조 변수)을 한 번의 순전파로 읽는 쪽이다.
Gift-Eval, FEV-Bench, TIME 세 공개 벤치마크에서 사전학습 파운데이션 모델 가운데 점 예측과 확률 예측 모두 평균 순위 1위다. 비교군에는 Chronos-2, Toto 2.0 계열, 그리고 TimesFM-2.5가 들어간다. 코드는 GitHub과 Hugging Face google/timesfm-3.0-pytorch에 올라와 있다. BigQuery 연동은 수주 안으로 예고됐고, 그전까지 단변량 작업은 이미 있는 TimesFM-2.5의 AI.FORECAST로 시험할 수 있다. 한 가지 선을 먼저 그어야 한다. 3.0 가중치는 비상업·비프로덕션 라이선스다. 코드를 클론하는 것과 내일 매출 API 뒤에 올리는 것은 다른 일이다.
배경 및 맥락
시계열 파운데이션 모델은 2024년 전후 갑자기 늘었다. 언어 모델이 다음 토큰을 맞추듯, 다음 시점을 맞추는 사전학습 모델을 만들어 소매·금융·관측(observability)·제조·의료·자연과학에 그대로 붙이려는 시도다. TimesFM은 그 흐름의 구글 쪽 이름이다. 디코더 전용 트랜스포머로 시계열을 패치 단위로 읽고, 미세조정 없이 여러 도메인에 일반화한다는 주장이 첫 논문(arXiv:2310.10688, ICML 2024)부터 따라다녔다.
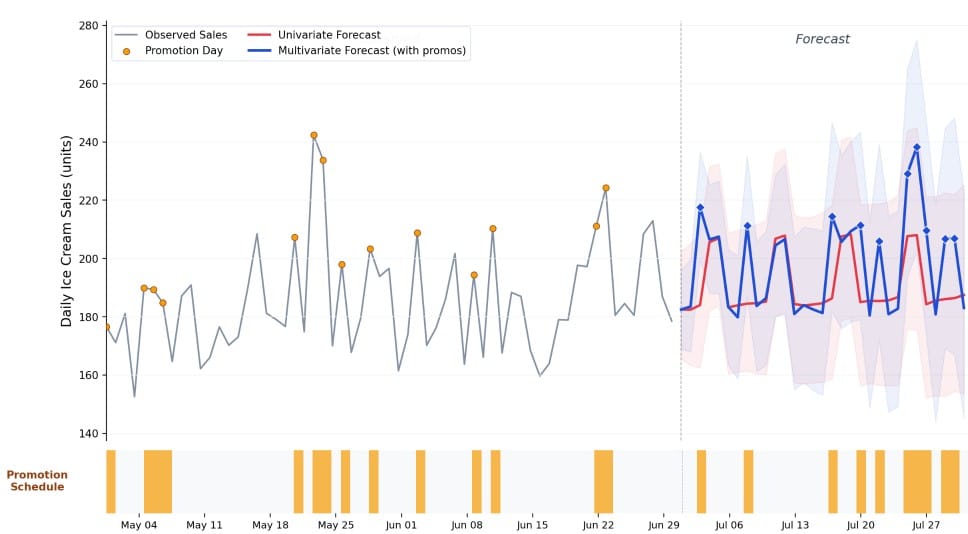
문제는 입력이었다. TimesFM-2.5까지는 한 시계열의 과거만 받았다. 공변량이 필요하면 나중에 XReg 같은 별도 경로로 붙였다. 현업의 예측은 그 반대다. 예측하고 싶은 줄이 여러 개이고, 어떤 보조 변수는 과거에만 있고, 어떤 보조 변수는 미래 일정표처럼 이미 알려져 있다. 구글이 든 예는 소매 체인의 아이스크림이다. 지난달 판매량만 외삽하면 주간 패턴은 나와도, 다음 달 프로모션 날은 보이지 않는다.
경쟁 구도도 그 공백을 향해 움직였다. 아마존의 Chronos 계열, Datadog의 Toto 계열은 다변량·공변량을 전면에 내세웠다. TimesFM-3는 같은 전장에 330M으로 들어간다. Hugging Face 모델 카드 기준으로 레이어 20, 모델 차원 1280, 헤드 16이다. 컨텍스트 패치는 32스텝, 예측 구간 패치는 64스텝이다. 사전학습 데이터에는 GiftEvalPretrain(FEV-Bench와 겹치는 셋은 제외), 2023년 11월 컷오프 위키피디아 페이지뷰, 2022년 말 컷오프 구글 트렌드 상위 검색어, 합성과 증강 데이터가 들어간다. 공동 작업자로 블로그는 Yichen Zhou, Petros Mol, Abhimanyu Das, Samet Oymak을 적었다.
주요 내용 분석
세 가지 입력을 네이티브로
TimesFM-3가 제로샷으로 받는 입력은 세 종류다. 용어를 먼저 풀면 그림이 단순해진다.
- 다중 타깃: 서로 같이 움직이는 여러 시계열을 동시에 예측한다. 아이스크림 브랜드별 매출이 그 예다. 각 타깃마다 점 예측과 분위수 예측을 같이 낸다.
- 과거 공변량(past covariates): 과거에는 알지만 미래는 아직 없는 보조 변수. 지난주 매장 방문객 수가 여기 해당한다.
- 과거-미래(동적) 공변량: 미래 값이 이미 알려진 보조 변수. 예정된 프로모션, 날씨 예보, 공휴일 달력이 이쪽이다. 모델은 이 신호를 예측 구간에 그대로 보여 준다.
단변량 모델이 매출 곡선만 앞으로 밀어 보내는 동안, 다변량 모델은 “다음 화요일에 할인이 있다”는 사실을 입력의 일부로 받는다. 구글이 아이스크림 예시에서 주장하는 차이는 그것이다. 단변량(빨간 선)은 주간 패턴만 반복하고, 다변량(파란 선)은 프로모션 날마다 약 20%의 매출 상승을 미리 반영한다. 한 달이면 그 차이가 매출 전망 자체가 된다.
패치 격자 위, 두 종류의 어텐션
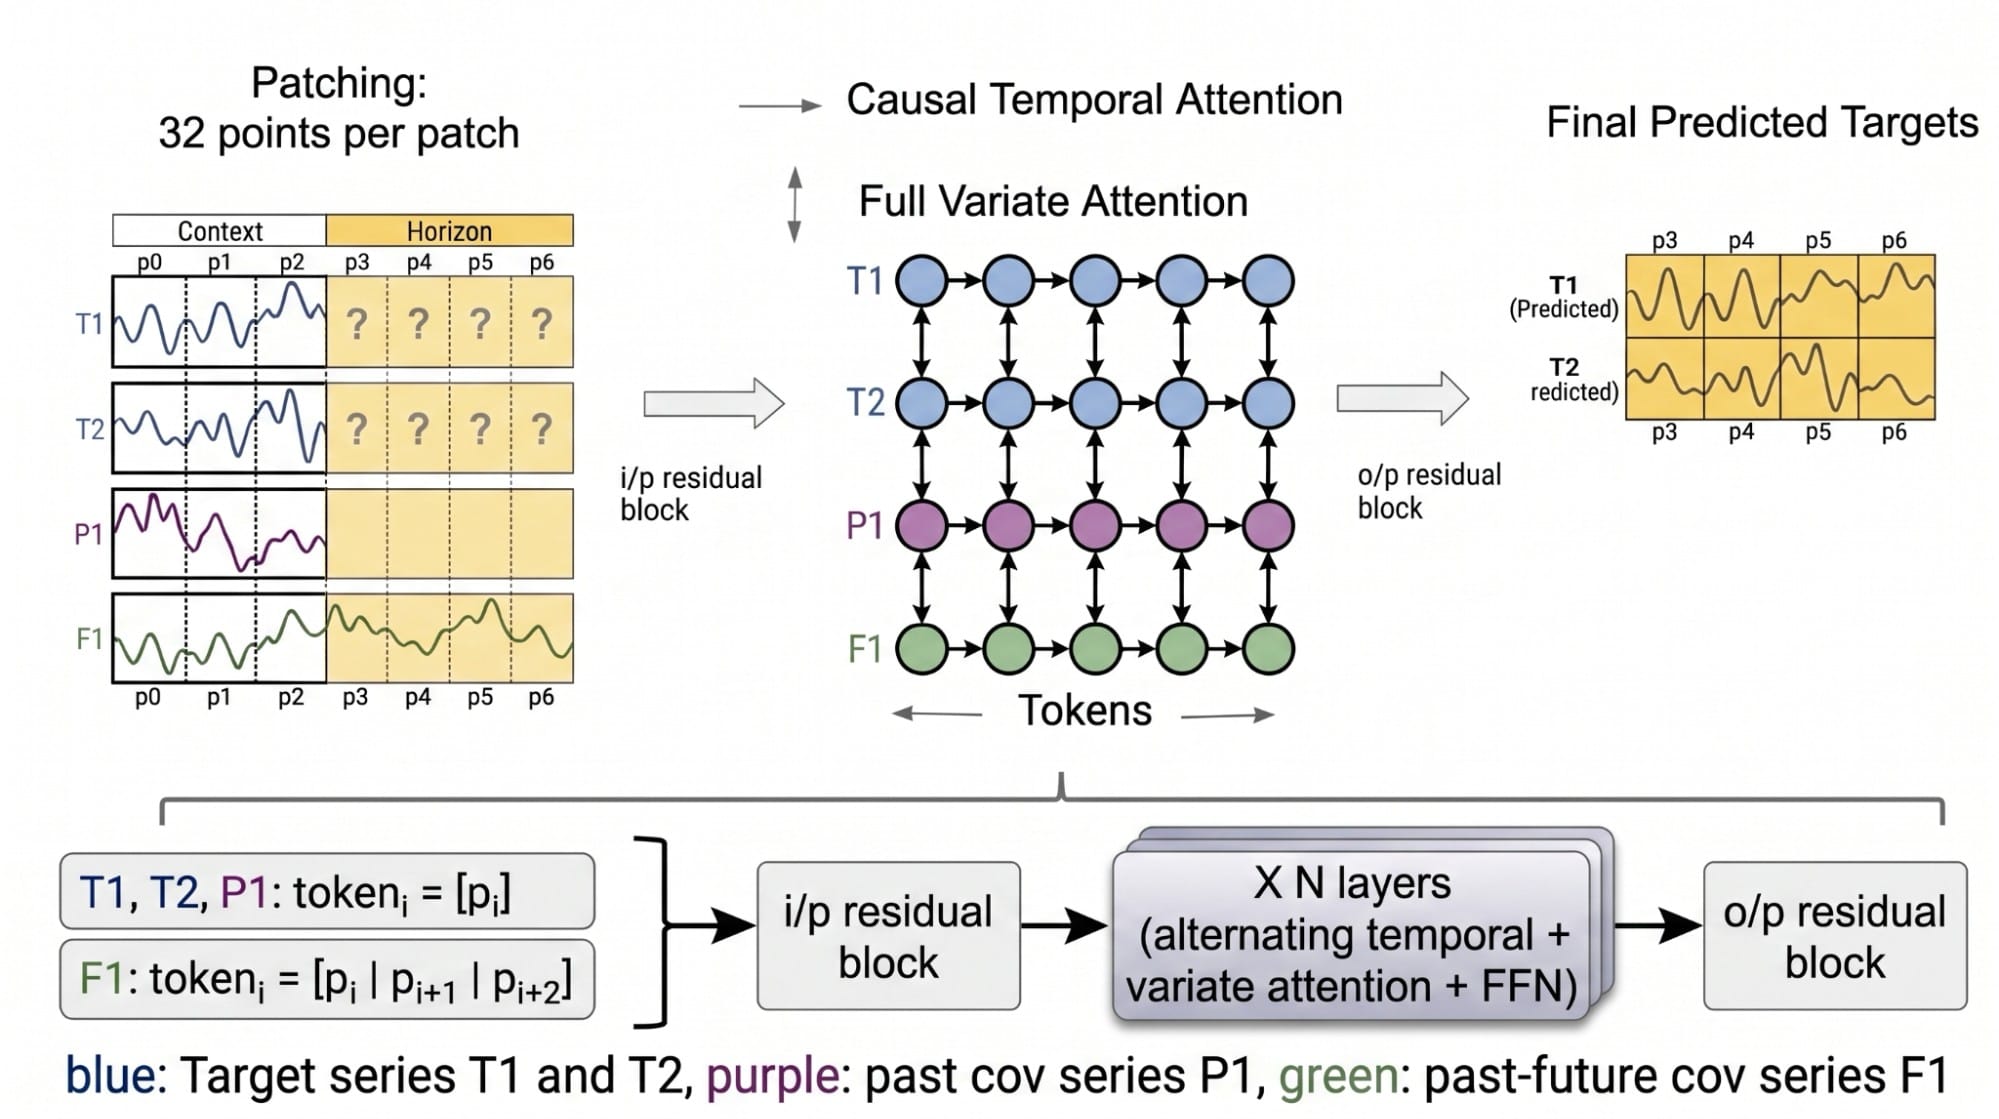
뼈대는 전작과 같은 디코더 전용 트랜스포머다. 연속된 시점을 32개씩 묶어 패치로 만들고, TimesFM-2.5와 비슷하게 시계열마다 정규화해 스케일 차이를 죽인다. 타깃과 과거 공변량은 현재 패치 하나로 토큰을 만든다. 과거-미래 공변량은 다르다. 현재 패치에 미래 패치를 이어 붙이는 룩어헤드(lookahead)다. 이미 알고 있는 미래 신호를 토큰 안에 넣는 장치다.
토큰은 입력 잔차 블록을 지나 2차원 격자로 들어간다. 가로가 시간, 세로가 변수다. 여기서 어텐션이 번갈아 돈다.
- 인과적 시간 어텐션(causal temporal attention): 같은 시계열 안에서 과거 토큰만 본다. 미래를 훔쳐보면 안 되므로 인과 마스크가 강제된다.
- 전체 변수 어텐션(full variate attention): 같은 시점에서 다른 시계열을 전부 본다. 한 브랜드의 프로모션이 다른 브랜드 매출을 어떻게 건드리는지, 그 상관을 여기서 배운다.
두 메커니즘이 여러 층을 오가며 시간 패턴과 변수 간 관계를 섞는다. Hugging Face 카드는 이를 Variate Attention과 CPM(Contiguous Patch Masking) Iterative RevIN이 들어간 스택 믹싱 트랜스포머로 적는다.
한 번의 순전파: Contiguous Patch Masking
이전 TimesFM은 예측을 패치 단위로 이어서 만들었다. 자기회귀(autoregressive) 디코드다. 한 패치를 내고, 그걸 다시 넣어 다음 패치를 낸다. 지연이 쌓이고, 앞 패치의 오차가 뒤로 전염된다. TimesFM-3는 Contiguous Patch Masking으로 예측 구간 전체를 한 번의 순전파에서 채운다. 관측된 컨텍스트 옆에 미래 구간의 마스크된 자리 표시 토큰을 붙인다. 타깃과 과거 공변량은 미래가 없으니 가리고, 과거-미래 공변량은 그대로 보여 준다. 교차 어텐션이 가려진 패치를 동시에 메운다. 루프가 없다.
출력은 점 하나만이 아니다. 각 타깃, 각 미래 스텝마다 9개 분위수(quantile)를 낸다. 10퍼센타일부터 90퍼센타일까지다. 분위수는 “이 값이 맞다”가 아니라 “이 구간 안에 들어올 가능성”을 숫자로 펼친 것이다. 재고를 쌓을 때 중앙값만 보면 품절을 놓치고, 90퍼센타일을 보면 과잉 재고가 보인다. 확률 예측이 현업에서 필요한 이유다. Hugging Face 카드는 9개 가운데 인덱스가 4인 값이 중앙값이라고 적는다.
| 항목 | TimesFM-2.5 (2025.9) | TimesFM-3 (2026.8.31) |
|---|---|---|
| 파라미터 | 200M | 330M |
| 사전학습 | 단변량 | 네이티브 다변량, 1조+ 시점 |
| 공변량 | 이후 XReg로 보강 | 과거 / 과거-미래 공변량 네이티브 |
| 패치 | 32스텝 | 컨텍스트 32, 호라이즌 패치 64 |
| 디코드 | 패치 단위 자기회귀 | Contiguous Patch Masking, 단일 순전파 |
| 분위수 | 선택적 분위수 헤드 | 매 스텝 9개 (10~90퍼센타일) |
| 공개 벤치마크 | 선행 세대 | Gift-Eval·FEV-Bench·TIME 파운데이션 1위 |
| 가중치 라이선스 | Apache-2.0 | timesfm-non-commercial-license-v1.0 |
| BigQuery | AI.FORECAST 지원 | 수주 내 통합 예고 |
표의 한 줄이 실제 사용자를 가른다. 2.5는 지금 BigQuery에서 SQL로 돌릴 수 있다. 3.0은 벤치마크와 GitHub·Hugging Face가 먼저고, 웨어하우스 연동은 뒤다. 가중치 라이선스도 갈린다. 저장소 코드는 Apache-2.0을 유지하지만, 3.0 기본 가중치는 비상업·비프로덕션으로 묶여 있다.
벤치마크 세 판에서 같은 방향
구글은 Gift-Eval, FEV-Bench, TIME 세 공개 벤치마크를 제시한다. 각 그림은 점 예측 평균 순위(가로)와 확률 예측 평균 순위(세로)다. 왼쪽·아래가 더 좋다. 점의 크기는 파라미터 수다. 각 그림에 TimesFM-3가 두 점으로 찍힌다. 하나는 공변량과 교차 시계열 정보를 끈 단변량 모드, 다른 하나는 전체 다변량 모드다. 구글의 주장은 두 겹이다. 단변량 모드만으로도 경쟁 파운데이션을 맞추거나 이기고, 다변량 모드에서 한 번 더 뛴다.
PyPI·GitHub 릴리스 노트는 숫자를 더 구체적으로 적는다. FEV-Bench 100개 실제 과제에서 전체 1위, TIME 50개 도메인·98개 평가 과제에서 전체 1위, Gift-Eval에서는 파운데이션 모델 가운데 1위다. 비교군은 Chronos-2, Toto 2.0 패밀리(22M부터 2.5B까지), TimesFM-2.5, 그리고 차트에 보이는 TiRex-2 등이다. Toto 2.0-2.5B처럼 훨씬 큰 점이 오른쪽 위에 남아 있는 그림이, 330M이 이 판에서 주장하는 효율의 핵심이다.
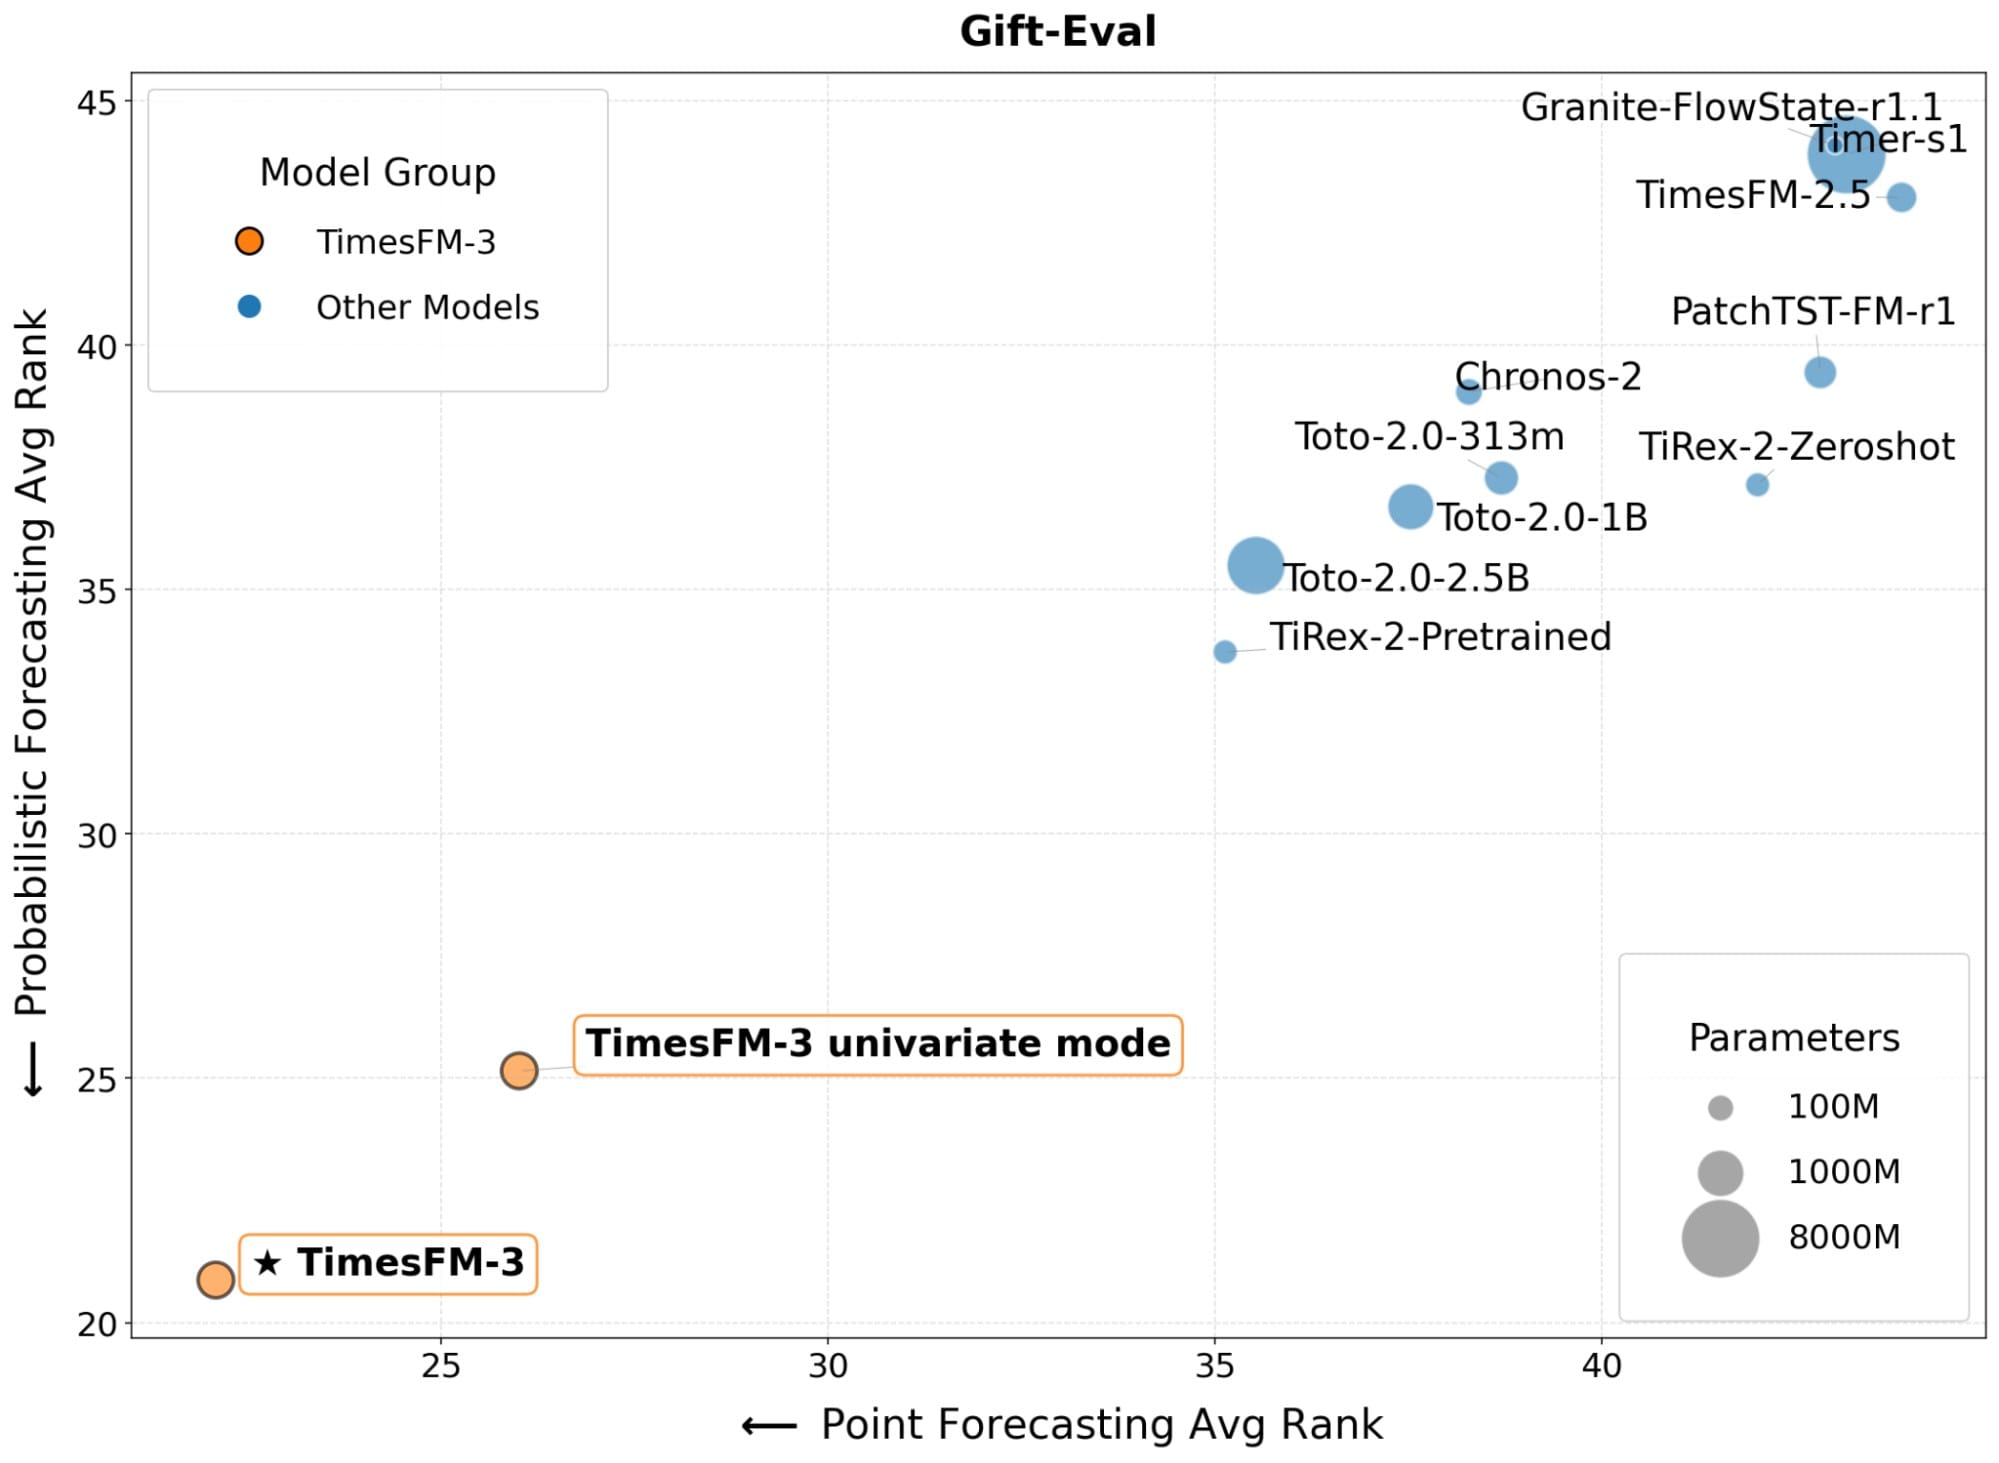
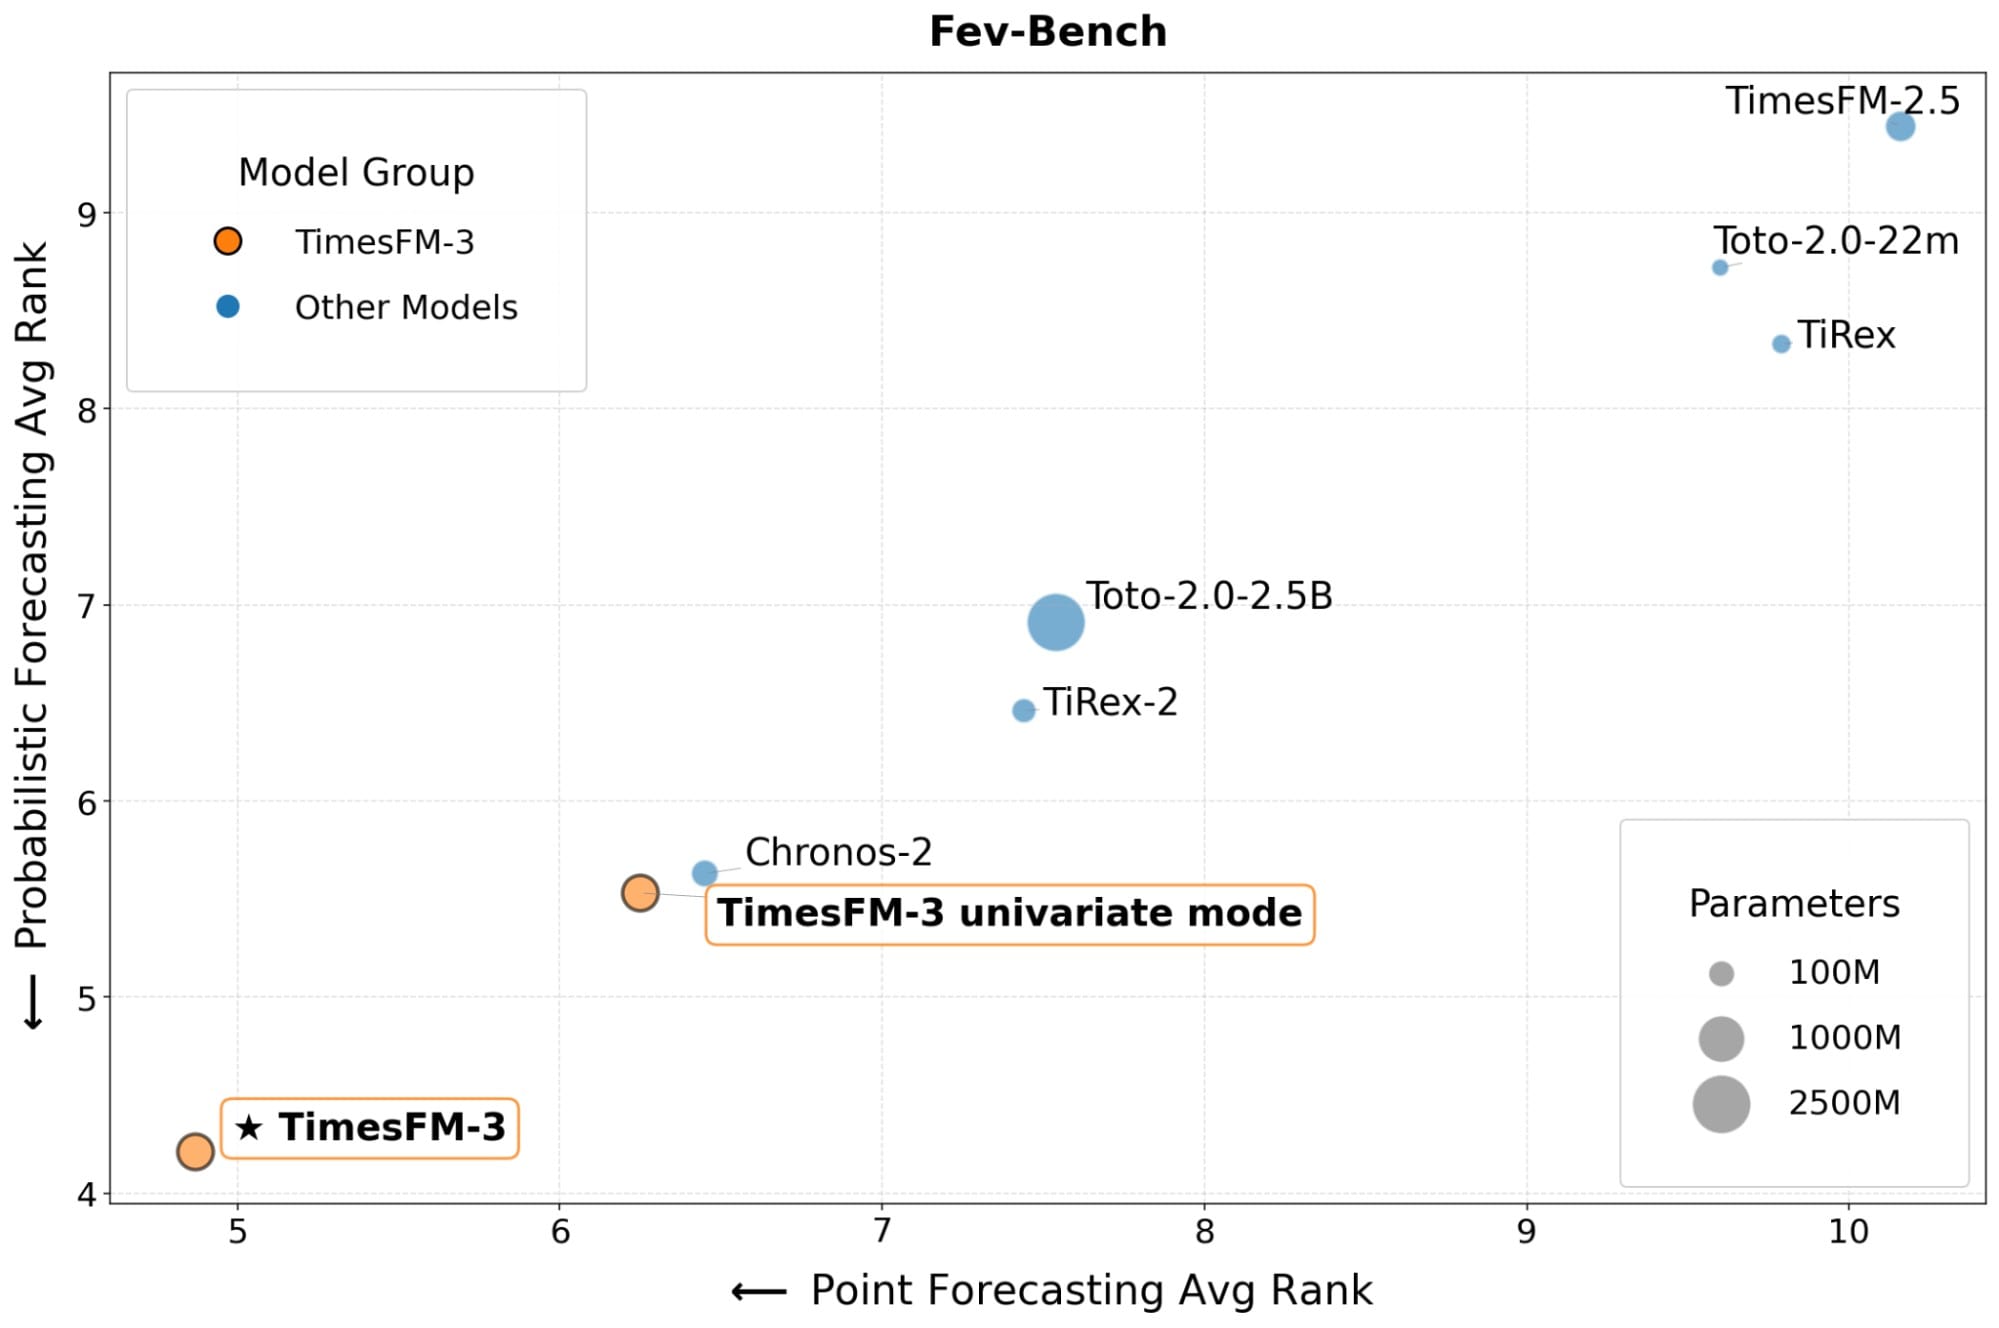
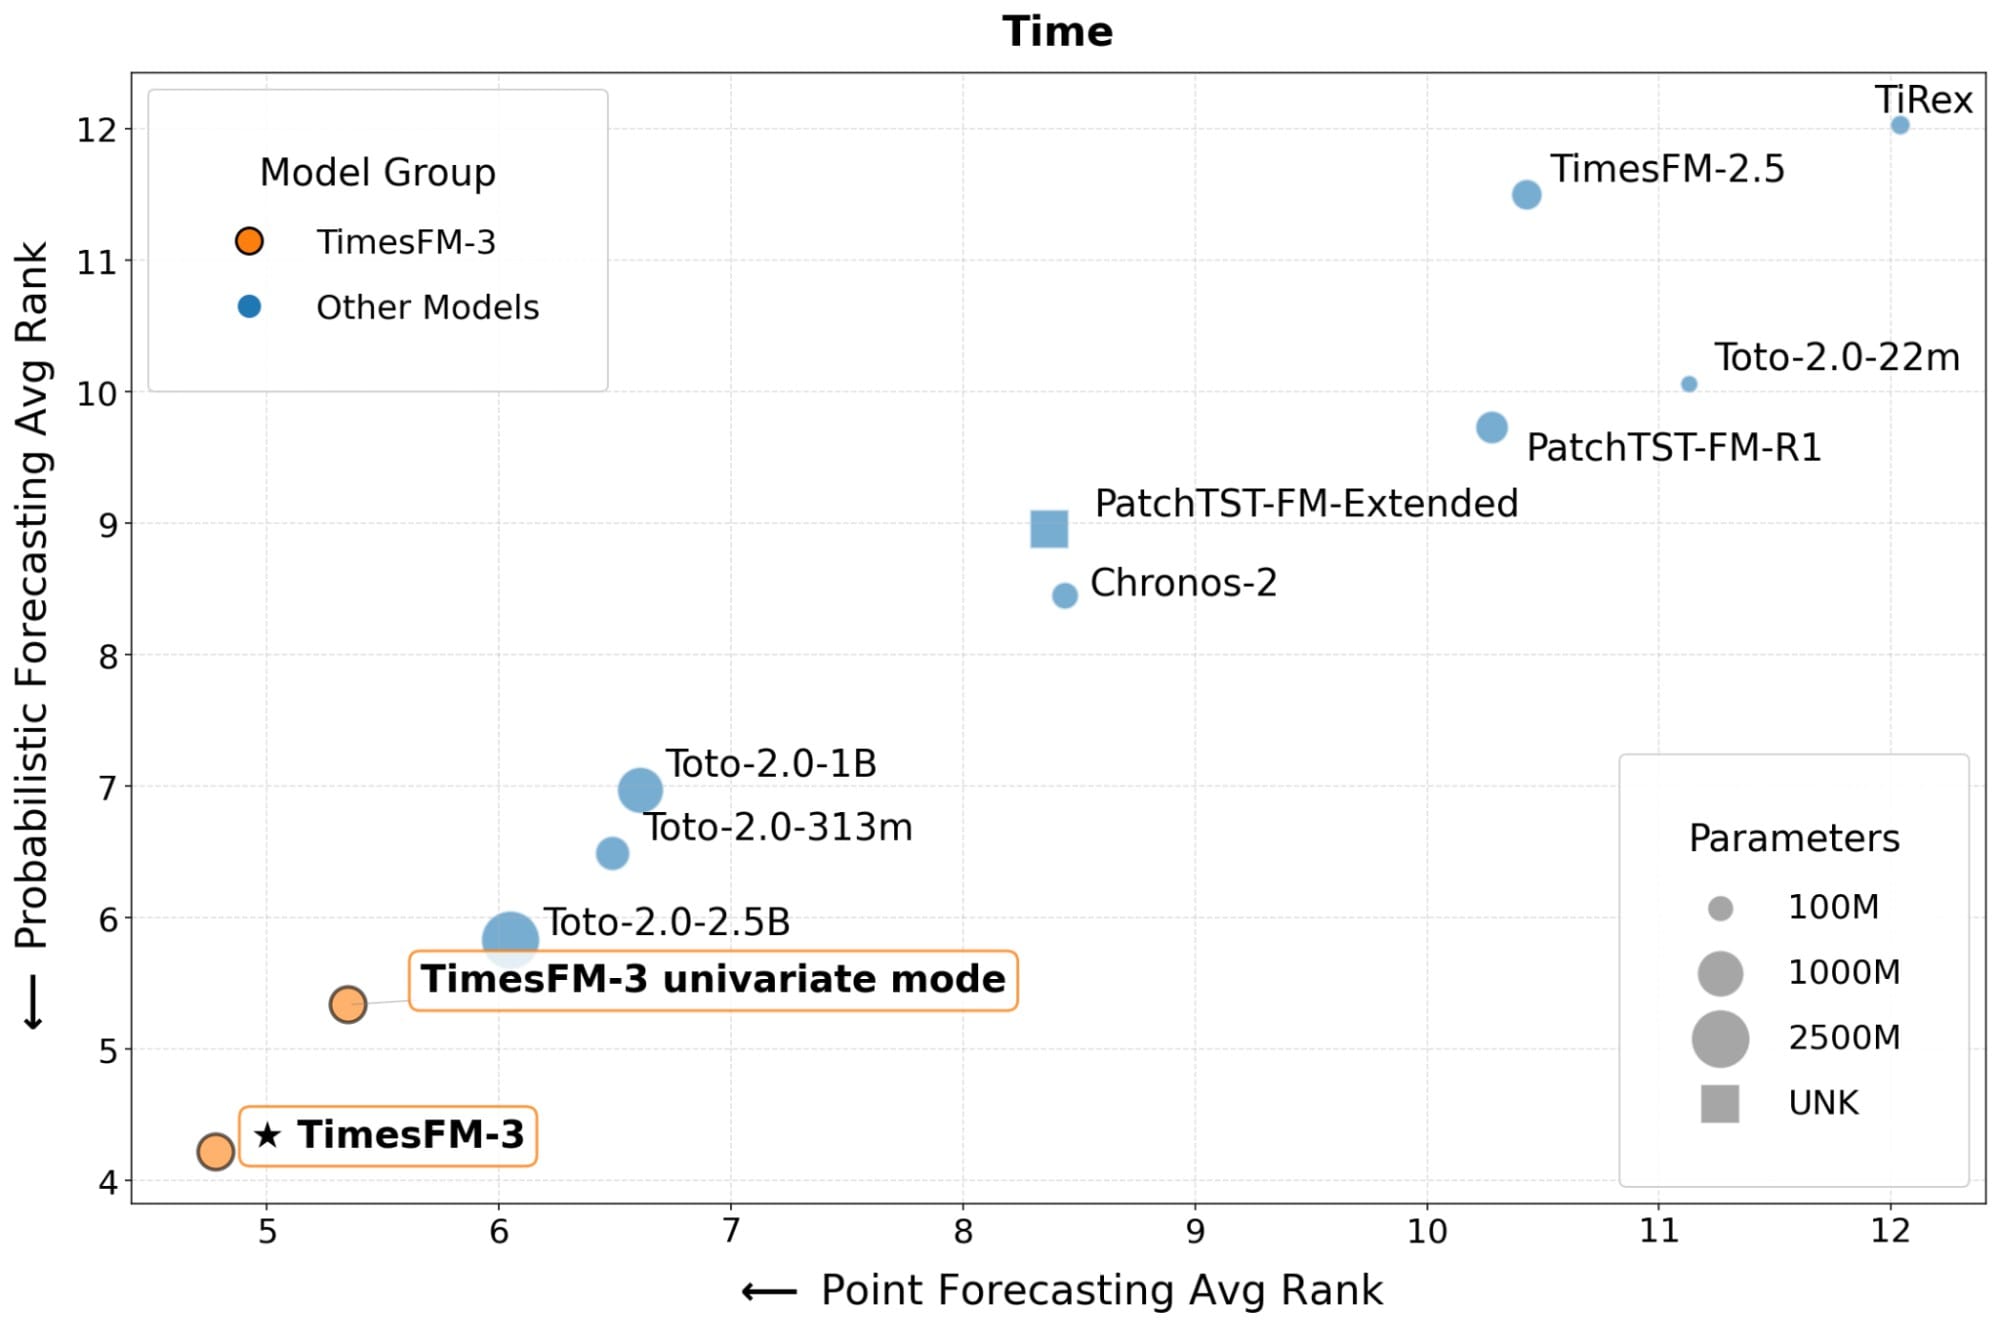
읽기의 주의는 같다. 세 차트는 구글이 고른 공개 리더보드의 평균 순위이고, 특정 소매 POS나 공장 센서에서 내일 오차가 얼마나 줄어드는지는 별개의 문제다. 그래도 세 판이 같은 방향을 가리키는 것은 분명하다. 단변량으로도 버틸 만하고, 공변량을 켜면 더 내려간다.
실사용자 반응
공개 다음 날 기준으로, 소셜에서 인용할 만한 1차 발언은 아직 얇다. 대신 코드와 라이선스를 만지는 쪽의 프레임은 공식 문서에 이미 적혀 있다.
- GitHub google-research/timesfm: 이 글을 쓰는 시점(2026-09-01) 스타 약 28,400, 포크 약 2,770. 2024년 4월부터 쌓인 저장소라 숫자 자체가 3.0만의 반응은 아니다. README 최상단은 TimesFM 3.0 체크포인트를 빨간 NEW로 표시하고, PyPI 패키지 최신 버전도 3.0이다. 이슈는 200건이 넘게 열려 있다. 커뮤니티가 없는 저장소가 아니라, 2.5를 쓰던 사람들이 3.0 체크포인트를 받는 구조다.
- Hugging Face
google/timesfm-3.0-pytorch: 공식 PyTorch 가중치. TimesFM 컬렉션에 막 올라온 항목이고, 모델 카드는 Non-Commercial License v1.0을 첫 줄에 둔다. 추론 예제는timesfm3.TimesFM3Evaluator로 단변량 배치와 다변량+공변량 배치를 나란히 보여 준다. “받아라”가 아니라 “이렇게 넣으면 모양이 나온다”에 가깝다. - 라이선스 경고는 저장소가 먼저 한다. GitHub README는 코드와 2.5까지 가중치는 Apache-2.0, 3.0 기본 가중치는
timesfm-non-commercial-license-v1.0이며 상업·프로덕션 사용은 허용되지 않는다고 굵게 적는다. MarkTechPost(8월 31일)는 이 줄을 배포 가능 여부의 핵심으로 받아, 오늘은 벤치마크할 수 있고 내일 예측 API 뒤에 올리는 일은 안 된다고 정리했다. 인용할 트윗을 만들 필요는 없다. 제약 조건이 릴리스 노트에 이미 있다. - BigQuery 사용자: 구글 블로그 결론은 3.0 연동을 수주 뒤로 미루고, 당장 단변량 작업은 TimesFM-2.5의
AI.FORECAST로 익히라고 한다. BigQuery 문서도 지원 모델을 TimesFM 2.0과 2.5로 적는다. 웨어하우스에서 SQL만 쓰는 팀에게 3.0은 아직 연구 릴리스다.
연구자·실무자가 문서를 읽는 방식은 대체로 세 갈래로 모인다. 벤치마크를 믿는 쪽은 330M이 Chronos-2·Toto 2.0을 평균 순위에서 밀었다는 점을 가져간다. 시스템을 굴리는 쪽은 단일 순전파와 네이티브 공변량을 가져간다. 법무·배포를 보는 쪽은 비상업 가중치를 가져간다. 세 갈래가 같은 저장소를 본다.
의미와 시사점
TimesFM-3의 의미는 “더 큰 시계열 모델”이 아니다. 330M은 Toto 2.0-2.5B보다 작고, 언어 모델 기준으로는 작다. 의미는 시계열 파운데이션의 기본 입력이 한 줄에서 여러 줄로 바뀌었다는 점이다. 단변량 제로샷이 2024~2025년의 증명 과제였다면, 2026년의 과제는 프로모션 달력과 방문객과 연관 SKU를 같이 넣는 일이다. 구글은 그 일을 미세조정이 아니라 사전학습에 넣었다.
실무 관점의 분기점은 세 개다. 첫째, 공변량을 이미 갖고 있는 팀. 프로모션 일정과 날씨 예보가 테이블에 있으면 TimesFM-3의 입력이 그 테이블과 같다. 둘째, 아직 한 줄만 있는 팀. 단변량 모드만으로도 구글은 경쟁 모델을 이긴다고 주장한다. 공변량을 안 만든다고 3.0이 무의미해지지는 않는다. 다만 아이스크림 차트가 보여 주는 20% 스파이크는 공변량 없이는 안 나온다. 셋째, 프로덕션에 올려야 하는 팀. 지금은 2.5와 Apache-2.0이 안전한 길이고, 3.0은 연구·벤치마크·내부 실험 쪽에 가깝다. BigQuery 연동이 열리면 이 분기점은 다시 움직인다.
오픈소스의 위치도 한 번 꼬인다. 저장소는 열려 있고 스타는 이미 2.8만이다. 그런데 가장 새로운 가중치는 비상업이다. 코드를 포크하는 자유와 가중치를 서비스에 넣는 자유가 같은 라이선스가 아니다. 시계열 파운데이션이 언어 모델의 오픈 가중치 논쟁을 뒤늦게, 더 작은 파라미터로 반복하는 장면이기도 하다.
마치며
TimesFM-3는 아이스크림 비유 때문에 쉽게 읽힌다. 할인 날을 알려 주면 매출 봉우리가 예측에 나타난다. 그 문장 아래에는 더 단단한 선택이 있다. 32스텝 패치, 인과 시간 어텐션과 변수 어텐션의 교차, 미래를 한 번에 채우는 마스크, 매 스텝 9개 분위수. 구글은 그 조합으로 세 공개 리더보드의 평균 순위를 가져갔다. 쓸 수 있는 사람은 오늘 GitHub과 Hugging Face에서 가중치를 받을 수 있다. 서비스에 넣을 수 있는 사람은, 라이선스와 BigQuery 일정과 자기 테이블에 공변량이 있는지를 같이 봐야 한다. 단변량으로도 벤치마크는 이긴다. 프로모션을 알려 줘야 매출이 움직인다.
이 글은 AI가 작성하여 자동 발행된 콘텐츠입니다.
출처
- Ayush Jain, Rajat Sen, “TimesFM-3: A zero-shot foundation model for multivariate forecasting,” Google Research Blog, 2026-08-31. 링크
- GitHub: google-research/timesfm
- Hugging Face: google/timesfm-3.0-pytorch
- PyPI: timesfm 3.0.0
- MarkTechPost, “Google AI Releases TimesFM-3…,” 2026-08-31. 링크
- BigQuery ML
AI.FORECAST문서 (TimesFM 2.0 / 2.5). 링크