
켜는 건 6B뿐이다: Qwen이 Flash-Next로 Qwen4를 먼저 연 이유
알리바바 Qwen 팀은 2026년 8월 26일 Qwen4를 받칠 아키텍처의 실험 미리보기 Qwen3.8-Flash-Next를 오픈 웨이트로 풀었다. 125B 중 실제로 켜지는 건 6B이고, 긴 컨텍스트 비용을 구조로 줄이겠다는 설계다.

핵심 요약 (TL;DR)
2026년 8월 26일 알리바바 Qwen 팀은 Qwen3.8-Flash-Next를 오픈 웨이트로 풀었다. 공식 README가 한 줄로 못 박는다. Qwen4를 받칠 아키텍처의 실험 미리보기다. 인과 언어 모델에 비전 인코더가 붙어 이미지·텍스트를 받아 텍스트를 낸다. 파라미터는 125B인데 토큰마다 켜지는 건 6B다. 여기에 n-그램 임베딩 51B와 MTP 4B가 더해진다. 컨텍스트는 기본 262,144토큰, YaRN으로 100만까지 늘릴 수 있다.
이 글의 독자가 실제로 할 수 있는 일은 세 갈래다. Hugging Face에서 가중치를 받아 vLLM·SGLang·TokenSpeed·Transformers로 서빙하거나, Unsloth GGUF를 받아 로컬 추론을 시도하거나, 같은 설계를 바탕으로 한 클라우드 제품 Qwen3.8-Flash API를 쓰는 것이다. 사고(thinking) 모드가 기본이고, enable_thinking / preserve_thinking / reasoning_effort로 끈다. 벤치 숫자는 벤더 보고이며, 라이선스는 Apache 2.0이 아니라 qwen-community-1.0이다.
배경 및 맥락
Qwen은 전에 한 번 같은 수순을 밟았다. Qwen3-Next가 Gated DeltaNet과 Gated Attention 하이브리드를 시험했고, 그 설계가 Qwen3.5부터 3.8까지 이어졌다. 이번 Flash-Next는 그 다음 자리를 노린다. LMSYS SGLang 팀이 정리한 대로, Qwen3-Next가 Qwen3.5에 했던 역할을 Qwen4 앞에서 다시 한다. Transformers 쪽 설정이 이미 아키텍처를 qwen4_exp로 적고 있다는 2차 보도도 있다(The Kaitchup). 미리보기가 최종본과 같다고 단정할 수는 없다. 다만 한 메이저 랩이 효율 베팅을 어디에 걸었는지는 문서화됐다.
용어도 여기서 풀어 둔다. MoE(Mixture of Experts)는 전문가 네트워크를 잔뜩 두고 토큰마다 일부만 켜는 구조다. 이 모델은 전문가 512명 중 라우팅 10명과 공유 1명을 켠다. 희소 어텐션(sparse attention)은 모든 과거 토큰을 다 보지 않고 일부를 고른다. Qwen Sparse Attention(QSA)은 토큰이 아니라 마이크로 블록 단위로 고른다. Gated DeltaNet은 이력을 고정 크기 상태로 압축하는 선형 어텐션이다. n-그램 임베딩은 짧은 단어 묶음(바이그램·트라이그램)으로 표를 찾아 용량을 늘린다. 계산보다 메모리 조회에 가깝다. YaRN은 위치 인코딩을 스케일해 긴 컨텍스트를 버티게 하는 기법이다. MTP(Multi-Token Prediction)는 한 번에 여러 토큰을 예측하는 헤드로, 추론에서 투기적 디코딩(speculative decoding)에 쓰인다. 에이전트는 목표를 받아 도구를 쓰며 일을 이어 가는 프로그램이고, 하네스는 그 에이전트를 감싸 도구·환경을 붙이는 실행 틀이다.
클라우드 제품과 오픈 가중치는 이름이 비슷해도 같은 물건이 아니다. README는 Qwen3.8-Flash를 “이 미리보기를 바탕으로 한 공식 버전”이라고 적는다. 기본 컨텍스트 1M, 공식 내장 도구가 더 붙는다. Qwen Cloud 모델 페이지 기준 입력 100만 토큰당 0.15달러, 출력 0.47달러, 컨텍스트 1M이다. 트윗에 적힌 0.16달러와 페이지 숫자가 어긋나므로, 이 글은 클라우드 페이지를 따른다.
주요 내용 분석
레이아웃이 하는 일
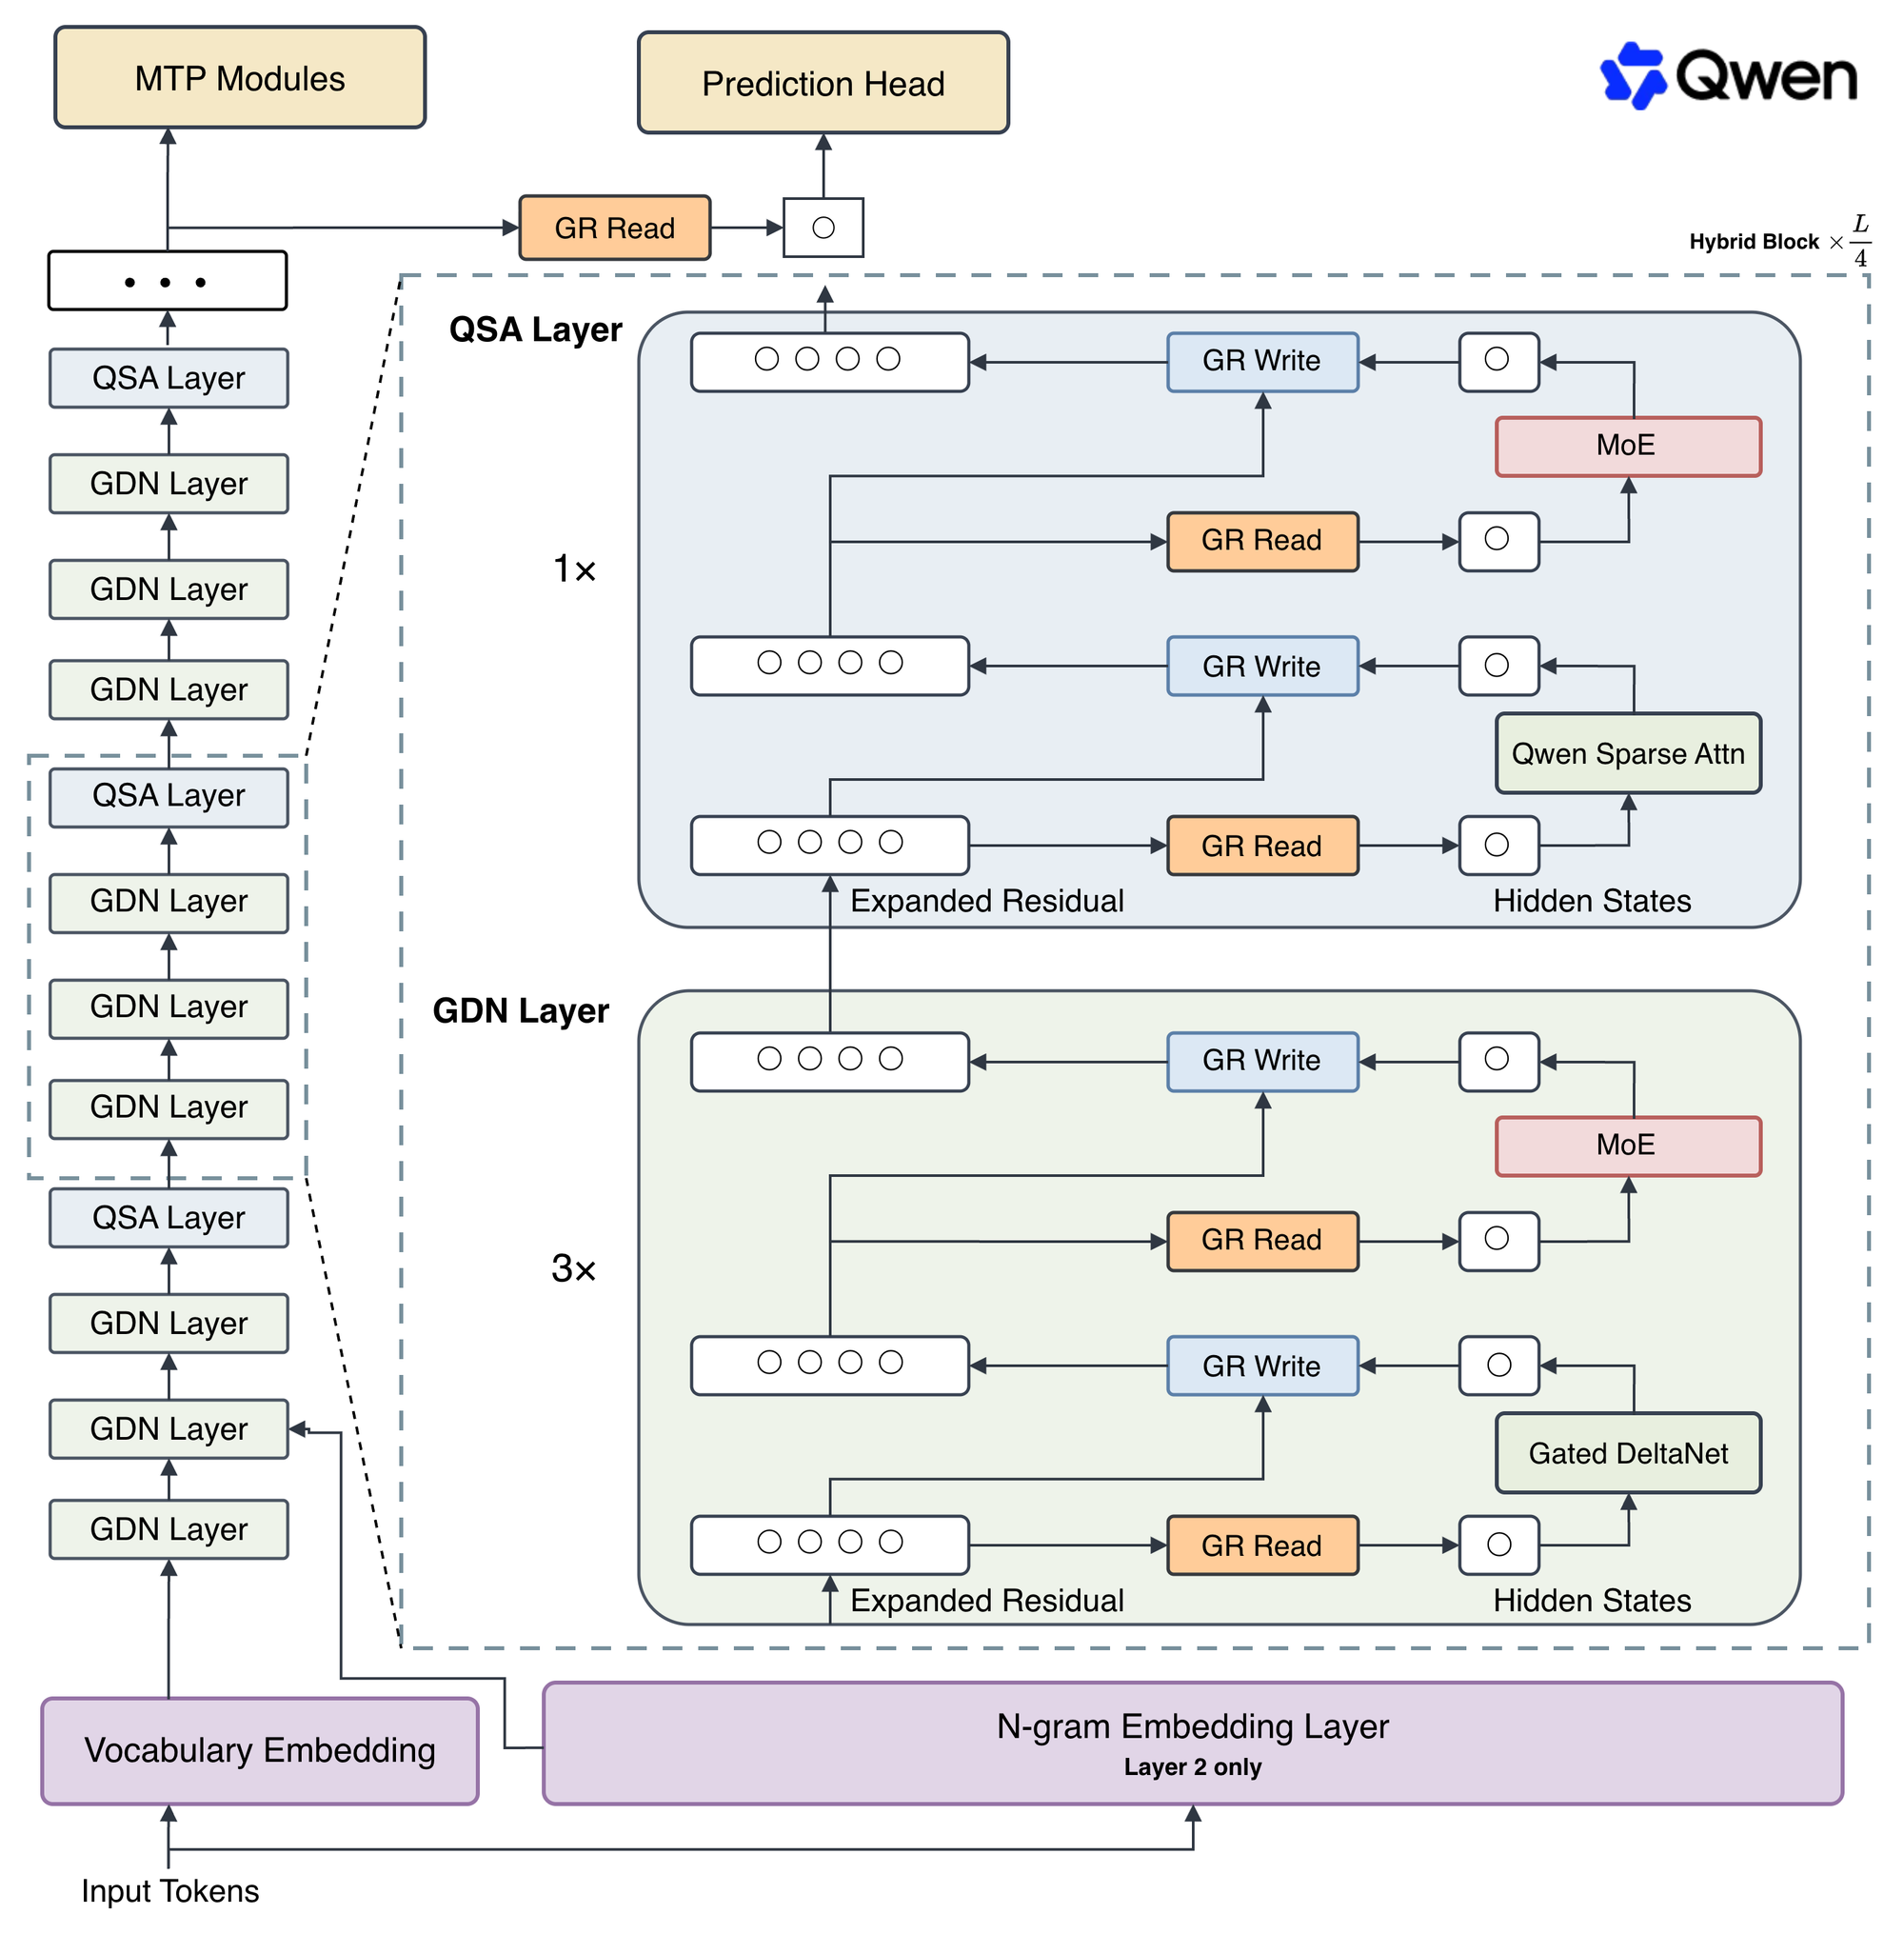
히든 레이아웃은 README 그대로다. 48층을 12 × (3 × (Gated DeltaNet → MoE) → 1 × (Qwen Sparse Attention → MoE))로 쌓는다. 넷 중 셋은 선형 어텐션으로 이력을 압축하고, 넷째만 희소 어텐션으로 블록을 고른다. QSA 예산은 512블록 또는 2048토큰이다. 히든 차원 2560, MoE 전문가 중간 차원 640. Gated Residual은 잔차 스트림을 4갈래로 넓히고, 원소별 읽기 게이트와 갈래별 쓰기 게이트로 조절한다. 병목 랭크는 320이다. n-그램 표는 2,000만 항목이고 2층에만 붙는다. 공식 아키텍처 그림이 그 스택을 한눈에 보여 준다.
학습 레시피도 구조의 일부다. Muon과 AdamW를 가중치 종류별로 나누고, 배치 워밍업을 건너뛴 채 목표 배치로 바로 간다. 스케일링 법칙을 다시 맞춰 옵티마이저 스텝을 줄였다고 팀은 적는다. GIGAZINE은 학습 기간이 Qwen3.8-27B의 약 9분의 1이라고 전한다. MarkTechPost는 학습 비용을 Qwen3.7-Plus의 약 9분의 1로 적는다. 비교 대상이 글마다 다르므로, 둘 다 벤더·2차 보도로 남긴다.
긴 컨텍스트에서 빨라지는 쪽
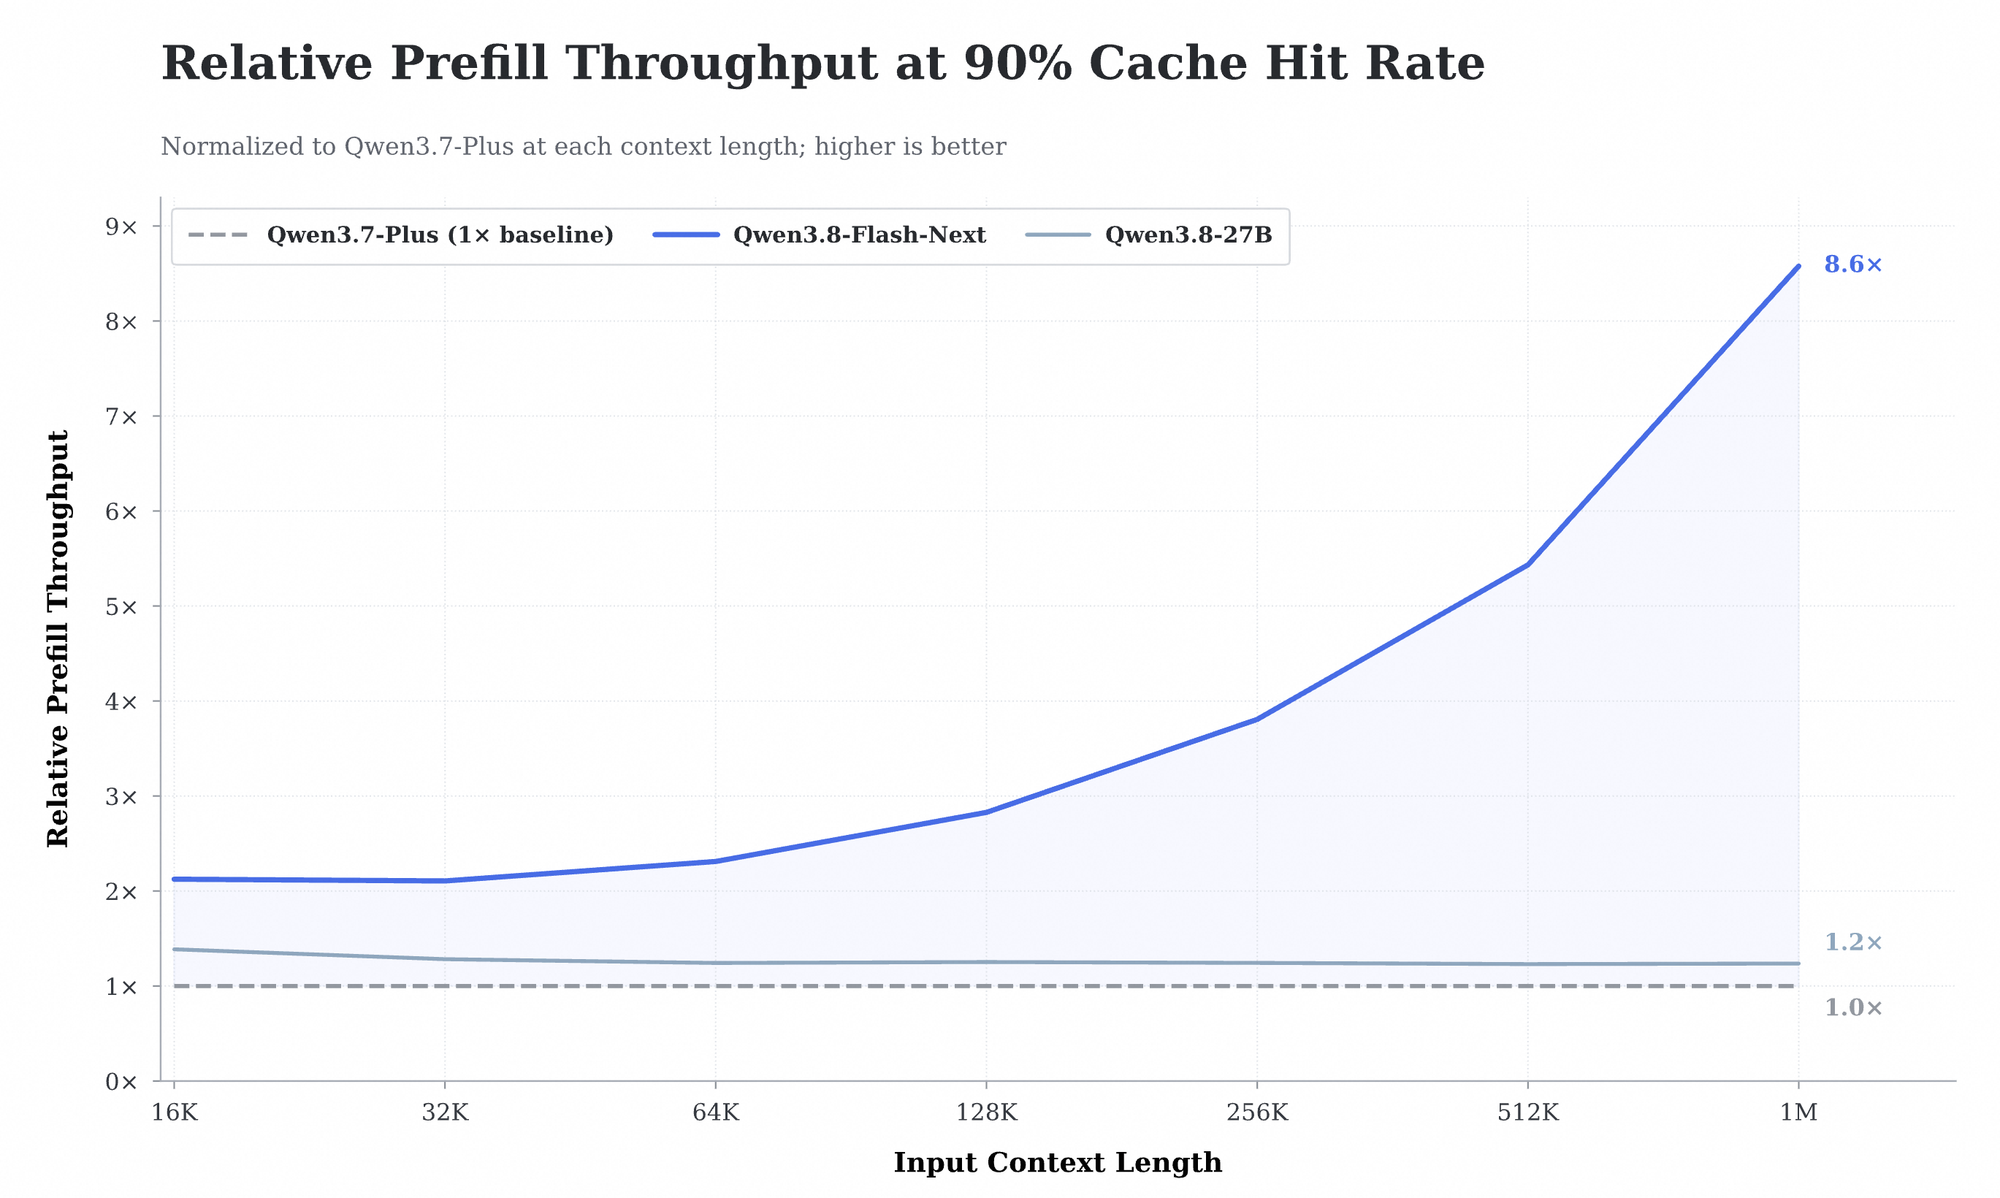
공식 처리량 차트는 90% 캐시 히트율에서 프리필 상대 처리량을 Qwen3.7-Plus=1.0으로 정규화한다. 같은 차트에서 Qwen3.8-Flash-Next는 1M 입력에서 8.6배, Qwen3.8-27B는 1.2배다. NVIDIA 기술 블로그는 이 8.6배를 90% 프리픽스 캐시 히트, 1M 컨텍스트의 온라인 서빙 숫자로 인용하고, 풀 어텐션 대비 QSA 커널이 프리필 최대 7.6배·디코드 4.9배라고 적는다. MarkTechPost는 SGLang 쿡북·vLLM 레시피가 10.2배·6.6배를 든다고 덧붙이며, 독립 측정 전까지 범위를 벤더 보고로 보라고 한다. 이 글도 그렇게 읽는다.
벤더가 보고한 점수
아래 숫자는 Hugging Face README 표다. 벤더가 고른 하네스와 온도·컨텍스트로 잰 값이다. DeepSWE 1.1은 Claude Code와 mini-SWE-agent 중 높은 쪽, SWE-bench Pro는 (Claude Opus만 공식 점수) Claude Code 하네스, 온도 1.0, top_p 0.95, 256K 창이다. 독립 리더보드와 같다고 보지 않는다.
| 항목 | Qwen3.8-Flash-Next | Qwen3.8-27B | Qwen3.7-Plus | DeepSeek-V4-Flash | Claude Opus 4.6 (Max) |
|---|---|---|---|---|---|
| 파라미터 / 활성 | 125B / 6B | 27B / 27B | 397B / 17B | 284B / 13B | — |
| DeepSWE 1.1 | 58.7 | 42.2 | 16.5 | 54.4 | — |
| SWE-bench Pro | 62.5 | 61.7 | 55.8 | 56.0 | 53.4 |
| SWE Multilingual | 81.0 | 73.8 | 75.8 | — | 77.5 |
| NL2Repo-Bench | 48.1 | 42.3 | 41.1 | 54.2 | 47.6 |
| CoWorkBench | 73.9 | 70.7 | 65.1 | 45.1 | 68.2 |
| JobBench | 55.7 | 33.4 | 27.6 | 41.3 | 36.6 |
| Toolathlon Verified | 73.5 | 67.1 | 50.6 | 70.3 | — |
| GPQA Diamond | 91.7 | 89.2 | 90.3 | 90.8 | 91.3 |
| HLE | 35.9 | 30.8 | 34.7 | 33.8 | 40.0 |
| LiveCodeBench v6 | 91.9 | 90.3 | 89.6 | 90.6 | 88.8 |
표가 가리키는 결은 분명하다. 코딩·에이전트·도구 사용에서 활성 6B가 27B 밀집과 397B급 Plus를 앞서는 칸이 많다. 동시에 전부 1등은 아니다. HLE는 Claude Opus 4.6 (Max) 40.0 대 35.9, NL2Repo는 DeepSeek-V4-Flash 54.2 대 48.1이다. 프론티어 추론과 레포 생성은 아직 빈칸이다.
비전 표도 README다. AndroidWorld 84.5(27B 81.9, Plus 81.0, Opus 62.0), LVBench 76.6, RealWorldQA 88.5, MathVision은 코드 인터프리터 있을 때 95.7이다. ClawEval-MM은 Pass@3 64.4. 멀티모달 도구·모바일 조작에서 격차가 크고, 장문 비디오는 Plus와 비슷하다. 인과 LM에 비전 인코더를 붙인 이유가 이 칸들에 있다.
받아서 켜는 방법
사고 모드가 기본이다. <think>…</think> 뒤에 답을 낸다. 샘플링은 thinking이 temperature 1.0·top_p 0.95, instruct(비사고)가 0.7·0.80에 presence_penalty 1.5다. reasoning_effort는 xhigh(기본)·medium·low. README는 멀티턴 에이전트에서 노력을 낮추면 턴은 빨라져도 실패·재시도가 늘어 총 지연이 커질 수 있다고 적는다. preserve_thinking은 과거 사고 블록을 대화에 남긴다. KV 캐시를 아끼려면 끌 수 있다. Qwen Cloud API는 같은 플래그를 chat_template_kwargs 밖, 최상위에 둔다.
서빙은 vLLM, SGLang, TokenSpeed, Hugging Face Transformers다. 262K를 넘어 1M을 쓰려면 설정에서 YaRN(factor 4.0, 원본 최대 262144)을 켠다. 짧은 텍스트에는 정적 YaRN이 오히려 손해일 수 있어, 긴 창이 필요할 때만 바꾸라고 README는 못 박는다. MarkTechPost 기준 FP8 체크포인트는 약 172.78GiB, BF16은 335.28GiB다. 활성 6B가 저장 용량을 줄여 주지는 않는다. 워크스테이션 한 대로 굴릴 모델이 아니다.
실사용자 반응
출시 이틀째라 사용기보다 인프라 쪽 반응이 먼저 왔다. LMSYS는 NVIDIA·AMD와 맞춰 SGLang 데이제로 지원을 올렸다. 48층 중 GDN 36·QSA 12, 전문가 512·top-10 라우팅을 다시 확인하고, Gated Residual을 FlashInfer 경로로 붙였다. NVIDIA는 GB300 NVL72에서 에이전트 코딩 실험을 권하는 기술 글을 냈다. Unsloth는 GGUF를 당일 수준으로 올렸고, GIGAZINE은 RAM에 올려도 VRAM과 같은 성능을 낸다는 Unsloth 설명을 소개한다. 그 주장은 Unsloth 쪽 문장이다. 176B급 디스크 용량을 생각하면 “노트북에서 돌아간다”와는 거리가 있다.
MarkTechPost는 제목부터 125B MoE·활성 6B·Qwen4 미리보기로 잡고, 배포 가능 여부를 “가능하지만 워크스테이션은 아니다”로 잘랐다. Unite.AI는 Next라는 라벨 자체가 실험 미리보기라고 읽는다. Hugging Face 카드는 이 글을 쓰는 시점에 최근 한 달 다운로드 4,810, 인퍼런스 프로바이더 요청 46이다. 커뮤니티 합의 점수가 아니라, 가중치가 막 퍼지기 시작한 단계다.
과장은 벤치 표에서 스스로 드러난다. 팀이 고른 하네스에서 코딩·오피스 에이전트가 강하고, HLE와 NL2Repo는 밀린다. “활성 6B가 Opus를 이겼다”는 문장은 칸을 가려야 성립한다.
의미와 시사점
첫째, Qwen은 이번에도 플래그십 전에 구조를 공개하는 길을 택했다. 3-Next가 3.5를 열었듯, Flash-Next는 Qwen4의 레이아웃을 커뮤니티 서빙 스택에 먼저 심는다. SGLang·vLLM·TokenSpeed 데이제로는 그 전략의 실행이다.
둘째, 효율의 축이 전문가 수만은 아니다. n-그램 표 51B는 MoE보다 계산이 적고 오프로딩에 유리하다고 팀이 적는다. 희소 어텐션은 토큰이 아니라 블록이다. 잔차는 게이트로 넓힌다. “더 큰 밀집”과 “더 많은 전문가” 말고, 임베딩·어텐션·잔차를 동시에 건드리는 설계다.
셋째, 오픈 웨이트와 클라우드 제품이 한 이름 아래 갈라진다. 미리보기는 262K 네이티브, 클라우드 Flash는 1M 기본에 내장 도구다. 받아서 재현할 수 있는 것과, 유료 API가 약속하는 것은 같은 체크포인트가 아니다.
넷째, 라이선스와 하드웨어가 흥분을 잘라 낸다. qwen-community-1.0은 Apache 2.0이 아니다. 상업 배포 전에 약관을 봐야 한다. 활성 6B는 연산이지 VRAM이 아니다. FP8만 170GiB가 넘으면, “싼 토큰”의 수혜자는 클라우드와 멀티 GPU 쪽이다.
마치며
Qwen3.8-Flash-Next의 핵심은 더 큰 모델이 아니라 켜는 비율과 레이아웃이다. 125B를 들고 6B만 켜고, 세 층의 선형 어텐션 뒤에 한 층의 블록 희소 어텐션을 끼우고, 51B짜리 조회 표를 2층에 붙였다. 벤더 표에서 코딩 에이전트는 강하고 일부 추론은 밀린다. 받아서 보려면 Hugging Face 가중치와 vLLM·SGLang이 이미 열려 있고, 노트북에서 바로 켜지는 크기는 아니다. Qwen4가 이 레이아웃을 그대로 가져갈지는 다음 사이클이 답한다. 지금은 그 답을 기다리지 않고 구조를 먼저 풀어 준 쪽이다.
출처
- Hugging Face: Qwen/Qwen3.8-Flash-Next
- Qwen: Qwen3.8-Flash-Next 블로그
- Qwen Cloud: Qwen3.8-Flash
- GIGAZINE: Qwen3.8-Flash-Next
- MarkTechPost: Qwen3.8-Flash-Next
- NVIDIA: GB300 NVL72에서 Qwen3.8-Flash-Next
- LMSYS: SGLang Day-0
- Hugging Face: unsloth/Qwen3.8-Flash-Next-GGUF
이 글은 AI가 작성하여 자동 발행된 콘텐츠입니다.