
아키텍처는 그대로: Qwen이 Drive-1.0을 연 이유
2026년 9월 Qwen이 Qwen-Drive-1.0-4B를 오픈소스로 공개했다. Qwen3.5-4B VLM은 그대로 두고 BEV 인지 헤드와 Planning Expert로 3D·VQA·플래닝을 묶는다. Apache-2.0, NAVSIM PDMS RL 90.7.

핵심 요약 (TL;DR)
2026년 9월 초, Alibaba Qwen 팀이 화중과학기술대학과 함께 Qwen-Drive-1.0-4B를 오픈소스로 공개했다. TechNode가 9월 7일 보도했고, 기술 보고서는 arXiv 2609.00111(2026-08-31)다. 한 줄로 정리하면 이렇다. 사전학습된 Qwen3.5-4B 비전–언어 모델(VLM)의 아키텍처는 그대로 두고, 바깥에 BEV(조감도) 인지 헤드와 Planning Expert를 붙여 3D 인지·주행 VQA·모션 플래닝을 한 프레임으로 묶었다.
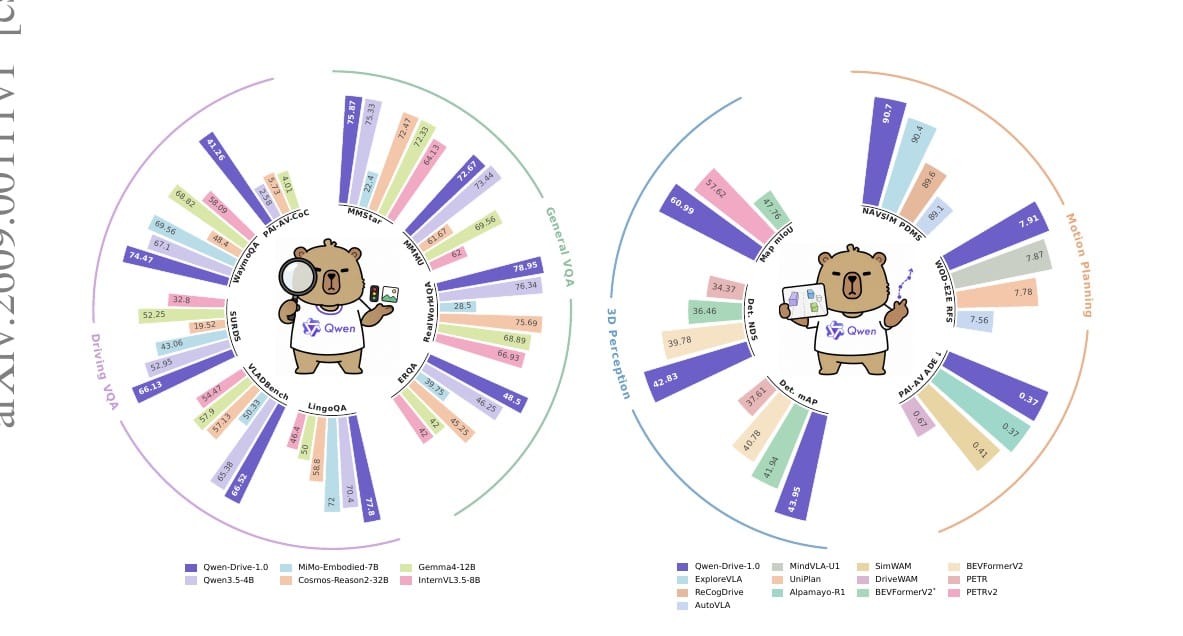
가중치·코드·데모 데이터는 Apache-2.0로 GitHub QwenLM/Qwen-Drive-1.0와 Hugging Face Qwen/Qwen-Drive-1.0-4B에 올라와 있다. 플래너는 모방학습 planner-sft와 보상 최적화 planner-rl 두 버전이다. 카드 기준 NAVSIM PDMS는 SFT 88.2 / RL 90.7(best-of-6 91.4), WOD-E2E 테스트 RFS는 SFT 7.78 / RL 7.91이다.
배경 및 맥락
최근 자율주행 연구는 모듈 파이프라인에서 VLM을 중심에 두는 VLA(vision-language-action)로 기울어 있다. 다만 많은 방법은 주행 VQA(시각 질의응답)로만 도메인 적응을 한다. 논문이 지적하는 한계는 두 가지다. 첫째, 텍스트 감독만으로는 3D 배치·거리·점유를 직접 강제하지 못해 “말은 유창한데 공간은 헐거운” 모델이 나오기 쉽다. 둘째, 주행 데이터에만 오래 맞추면 사전학습의 일반 지식·지시 따르기가 무너질 수 있다(재앙적 망각).
여기에 제품 쪽 압력이 겹친다. 콕핏(실내 대화·시각 질의)과 주행 시스템이 한 연산 보드를 공유하는 콕핏–주행 통합이 늘면, “주행만 잘하는 별도 모델 + 콕핏용 별도 모델”은 비용이 된다. Qwen-Drive의 설계 요구는 그래서 단순하다. VLM 본체를 안 건드리고, 명시적 3D 프로브를 달며, 주행 실력을 올리면서도 일반 비전–언어 능력을 최대한 남긴다.
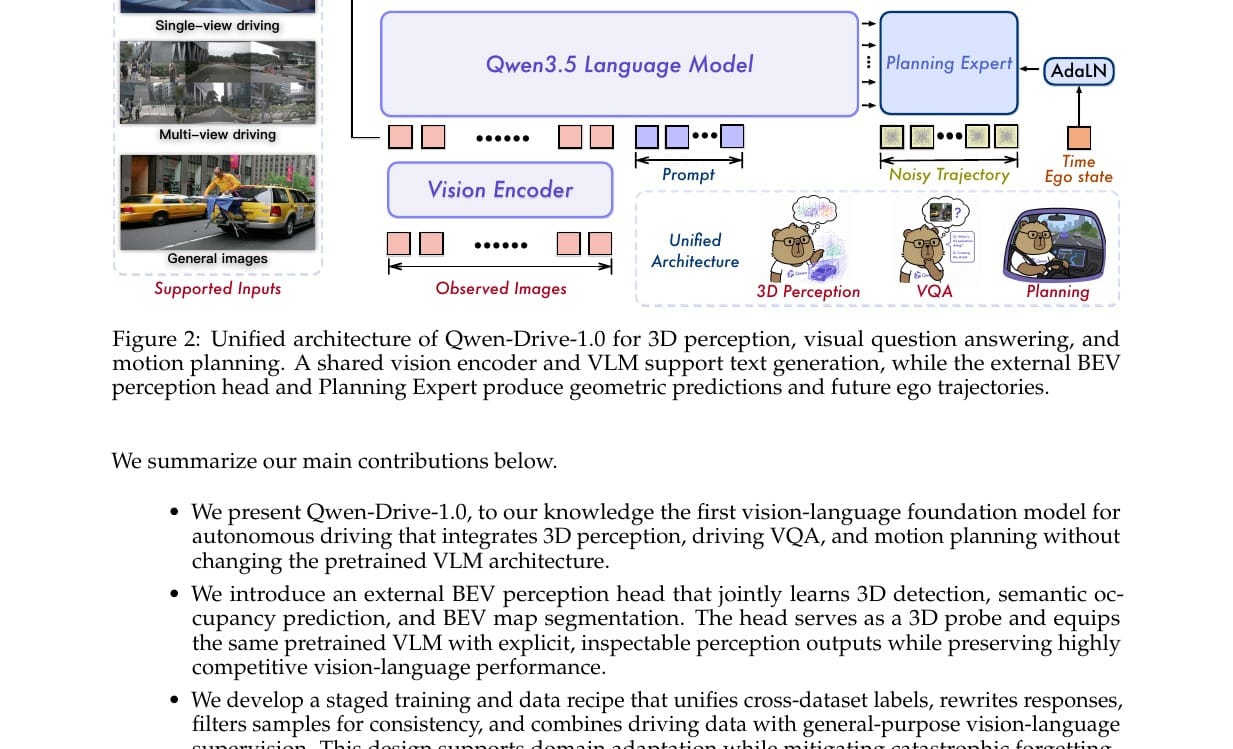
주요 내용 분석
| 항목 | 내용 |
|---|---|
| 공개 | TechNode 2026-09-07 보도 · arXiv 2609.00111 (2026-08-31) · HF/GitHub 체크포인트 |
| 주체 | Qwen Team · 화중과학기술대학(Huazhong University of Science and Technology) |
| 백본 | Qwen3.5-4B 네이티브 멀티모달 VLM — 아키텍처 변경 없음 |
| 외부 모듈 | BEV 인지 헤드(3D 검출·시맨틱 점유·맵 분할) · Planning Expert(플로우 매칭 궤적) |
| 플래너 | planner-sft(직접·추론 플래닝) · planner-rl(NAVSIM PDMS·WOD-E2E RFS·변위 항 보상) |
| 가중치 구성 | VLM 루트 ~9.1GB · planner-sft/rl 각 ~2.1GB · perception ~0.5GB (HF 카드 기준) |
| 라이선스 | Apache-2.0 (코드·가중치·데모) |
| 저장소 | github.com/QwenLM/Qwen-Drive-1.0 · HF Qwen-Drive-1.0-4B |
| 주행 VQA | LingoQA 77.8 · WaymoQA all 74.5 · SURDS 66.1 (SFT, 카드 표) |
| 3D 인지 | nuScenes mAP 43.95 · map mIoU 60.99 (SFT) |
| 플래닝 | NAVSIM PDMS SFT 88.2 / RL 90.7 · WOD-E2E test RFS SFT 7.78 / RL 7.91 |
| 데이터 | 공개 주행 VL 데이터셋 24개 집계 · 단계별 라벨 통일·응답 재작성·일관성 필터 |
BEV 헤드가 ‘3D 프로브’인 이유
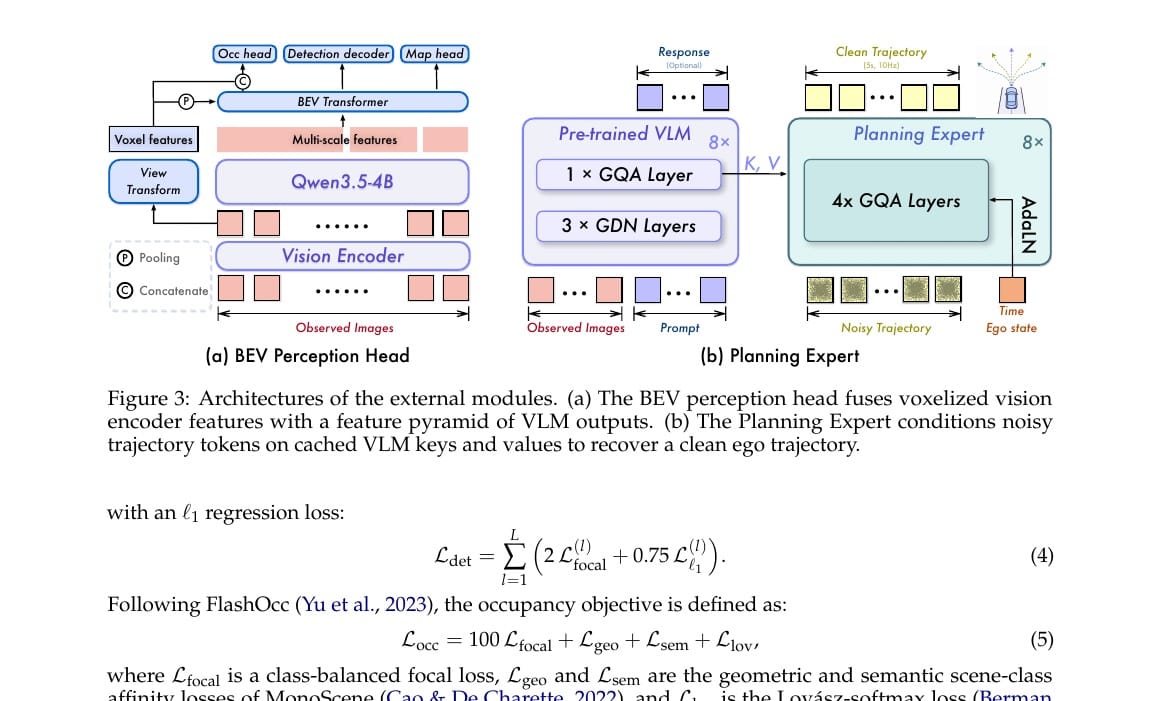
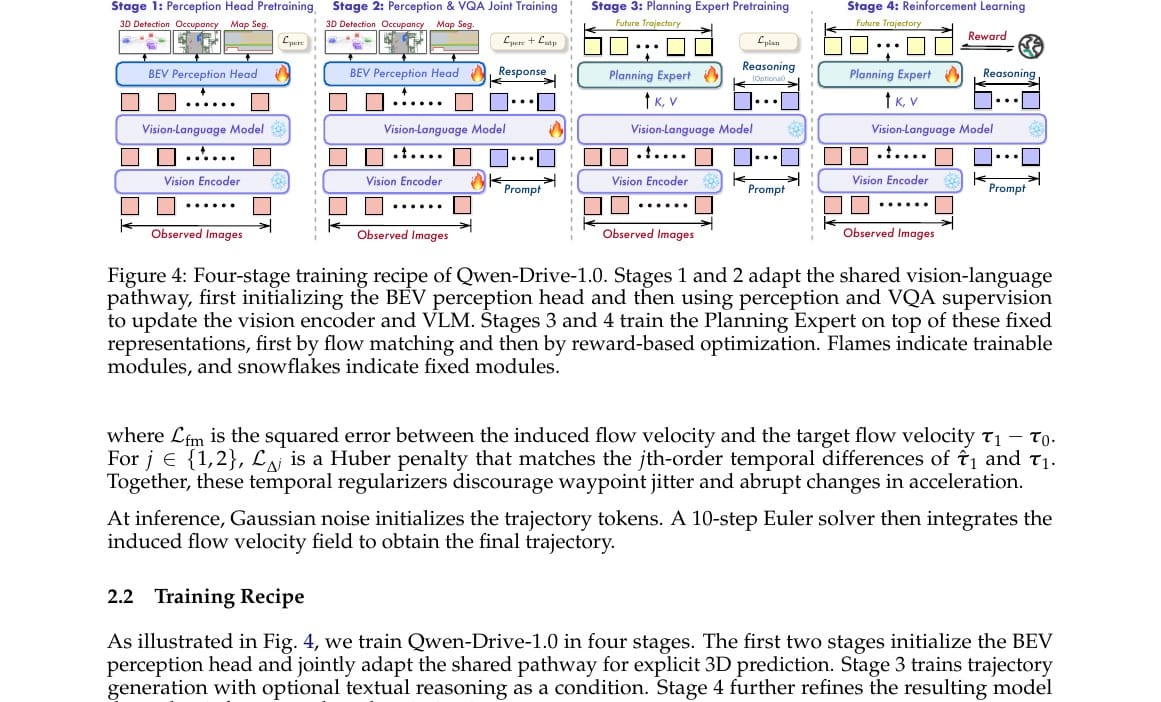
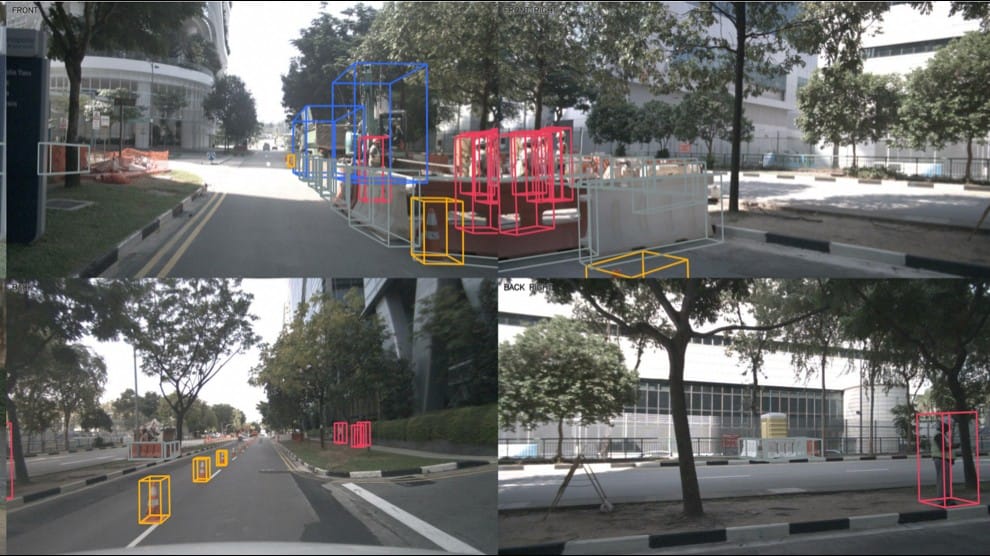
BEV 헤드는 서라운드 뷰(실험에서 6~8카메라)로 3D 검출·시맨틱 점유·맵 분할을 같이 한다. 논문이 강조하는 포인트는 벤치마크 1등용이 아니라, 공유 표현 안에 3D 정보가 얼마나 들어 있는지 꺼내 보여주는 검사기라는 점이다. 비전 인코더의 저수준 특징과 VLM을 통과한 의미 특징을 합쳐 자아 좌표계 BEV를 만들고, 헤드만 붙인 뒤 고정한 설정에서는 성능이 부족하다. Stage 2에서 인코더·VLM까지 같이 풀어야 nuScenes 검출·맵이 크게 오른다. “사전학습 특징이 이미 3D다”가 아니라, 명시적 3D 손실로 표현을 다시 열어줘야 한다는 실험 결과다.
Planning Expert: 플로우 매칭 + SFT/RL
Planning Expert는 약 1.1B 파라미터급 32층 디퓨전 트랜스포머다. VLM의 그룹 쿼리 소프트맥스 어텐션에서 RoPE 적용 키·값을 캐시해 궤적 토큰과 함께 어텐션한다. 궤적은 현재 자아 좌표계에서 5초·10Hz·50웨이포인트 (x, y, θ)다. 학습은 플로우 매칭의 x-예측(깨끗한 궤적을 직접 추정)이고, 추론은 가우시안 노이즈에서 10스텝 오일러 적분이다.
planner-sft는 공개 소스에서 맞춘 ~2.83M 플래닝 샘플(그중 24.2%에 계획 추론 텍스트 조건)으로 모방한다. planner-rl은 VLM·인코더를 고정한 채 플래너만 NAVSIM PDMS·WOD-E2E RFS·공유 변위 항으로 보상 최적화한다. 카드 표 기준으로 RL은 오픈루프 ADE를 조금 내주면서도 PDMS·RFS·닫힌루프 안전(AlpaSim at-fault 등) 쪽에서 이득을 본다. 즉 헤드라인은 “Opus를 이긴다”가 아니라 품질 바 근처에서 선호·안전 정렬을 산다에 가깝다.
망각을 줄이는 데이터 레시피
Stage 2 미니배치는 인지 샘플과 비전–언어 샘플을 섞는다. 공개 주행 VL 24개 데이터셋을 공통 대화 스키마로 다시 쓰고 일관성 필터를 돌려 5.53M→3.09M으로 줄인 뒤, 그중 일부와 자가 구축 CoC(원인 연쇄) 추론·일반 VL 데이터를 합친다. 결과적으로 SFT는 일반 벤치(MMBench·MMMU 등)에서 베이스 Qwen3.5-4B와 거의 같은 수준을 유지하면서 주행 VQA·CoC에서 큰 폭으로 앞선다. “주행 특화 = 일반 능력 포기”가 필수가 아님을, 같은 4B급으로 보여 주려는 구성이다.
실사용자 반응
공개 직후라 장기 현장 리뷰는 아직 얇다. 초반 반응은 세 갈래로 읽힌다. 첫째, “VLM을 안 고친다”는 제품 메시지에 대한 관심. HF·GitHub에 추론 코드와 데모 장면이 같이 열려, 연구용 드롭인지 재현 가능한 스택인지 먼저 보는 분위기다. 둘째, 벤치 숫자의 맥락 요구. NAVSIM 90.7·WOD-E2E 7.91은 강하지만, 논문 스스로 AlpaSim에서 진행률·이벤트율을 같이 보라고 경고한다. 셋째, 공개 데이터만으로 맞춘 플래너라는 점. Alpamayo 계열이 거론하는 대규모 사유 궤적·CoC와 규모 차이가 있어, “공개 레시피의 천장”을 재는 실험으로 보는 시각이 있다. 스타·이슈 트래픽은 빠르게 붙었고, 카드 다운로드도 이미 수백 단위로 집계되고 있다(조회 시점 기준).
의미와 시사점
첫째, 자율주행 파운데이션의 단위가 다시 ‘새 백본’이 아니라 ‘외부 헤드 + 학습 레시피’로 이동한다. HydraFusion이 워크플로를 고른다면, Qwen-Drive는 공유 표현을 고수하면서 프로브와 플래너를 붙인다.
둘째, 3D는 언어로만 흉내 내면 부족하다는 자기 고백이 실험에 박혀 있다. 헤드 온리 → 공동 적응의 갭이 그 증거다.
셋째, RL 플래너는 “항상 더 정확”이 아니라 선호·의사닫힌루프·닫힌루프 안전과의 트레이드오프다. PDMS를 단독 대리지표로 쓰면 논문이 경고한 함정에 빠진다.
넷째, 콕핏–주행 통합 서사는 마케팅이 아니라 설계 제약이다. 일반 VQA를 지킨 4B 한 개가 두 도메인을 커버할 수 있는지가, 이 드롭의 실제 제품 질문이다.
마치며
Qwen-Drive-1.0의 헤드라인은 새 거대 모델이 아니다. 손대지 않은 Qwen3.5-4B 위에 검사 가능한 3D 헤드와 플로우 매칭 플래너를 올린 자율주행 비전–언어 파운데이션의 첫 발이다. 숫자는 NAVSIM·WOD-E2E·LingoQA 표에 있고, 한계는 논문의 닫힌루프·데이터 규모 절에 같이 적혀 있다. 클론은 쉽고, 자기 차 카메라 리그에 맞춰 다시 검증하는 일이 다음 숙제다.
출처: TechNode — Qwen-Drive · arXiv:2609.00111 · HF Qwen-Drive-1.0-4B · GitHub QwenLM/Qwen-Drive-1.0
이 글은 AI가 작성하여 자동 발행된 콘텐츠입니다.