
좁힌 엔진이 이긴다: Perplexity가 Lily를 Apple Silicon에 연 이유
Perplexity가 Hybrid Compute용 로컬 엔진 Lily를 Apache-2.0으로 열었다. Qwen3.6-35B-A3B와 Apple Silicon만 겨냥한 Rust·Metal 전용 런타임으로, MLX-LM 대비 프리필 1.23×·디코드 1.35×를 공식 수치로 내세운다.

핵심 요약 (TL;DR)
2026년 9월 초, Perplexity가 Lily를 오픈소스로 열었다. Hybrid Compute(클라우드 프론티어 모델과 맥 로컬 모델을 한 작업 안에서 나누는 구조)용으로 만든 로컬 추론 엔진이다. 공식 블로그 Optimizing On-Device Inference for Apple Silicon과 pplx-garden/lily에 코드·벤치가 올라와 있다. 라이선스는 Apache-2.0.
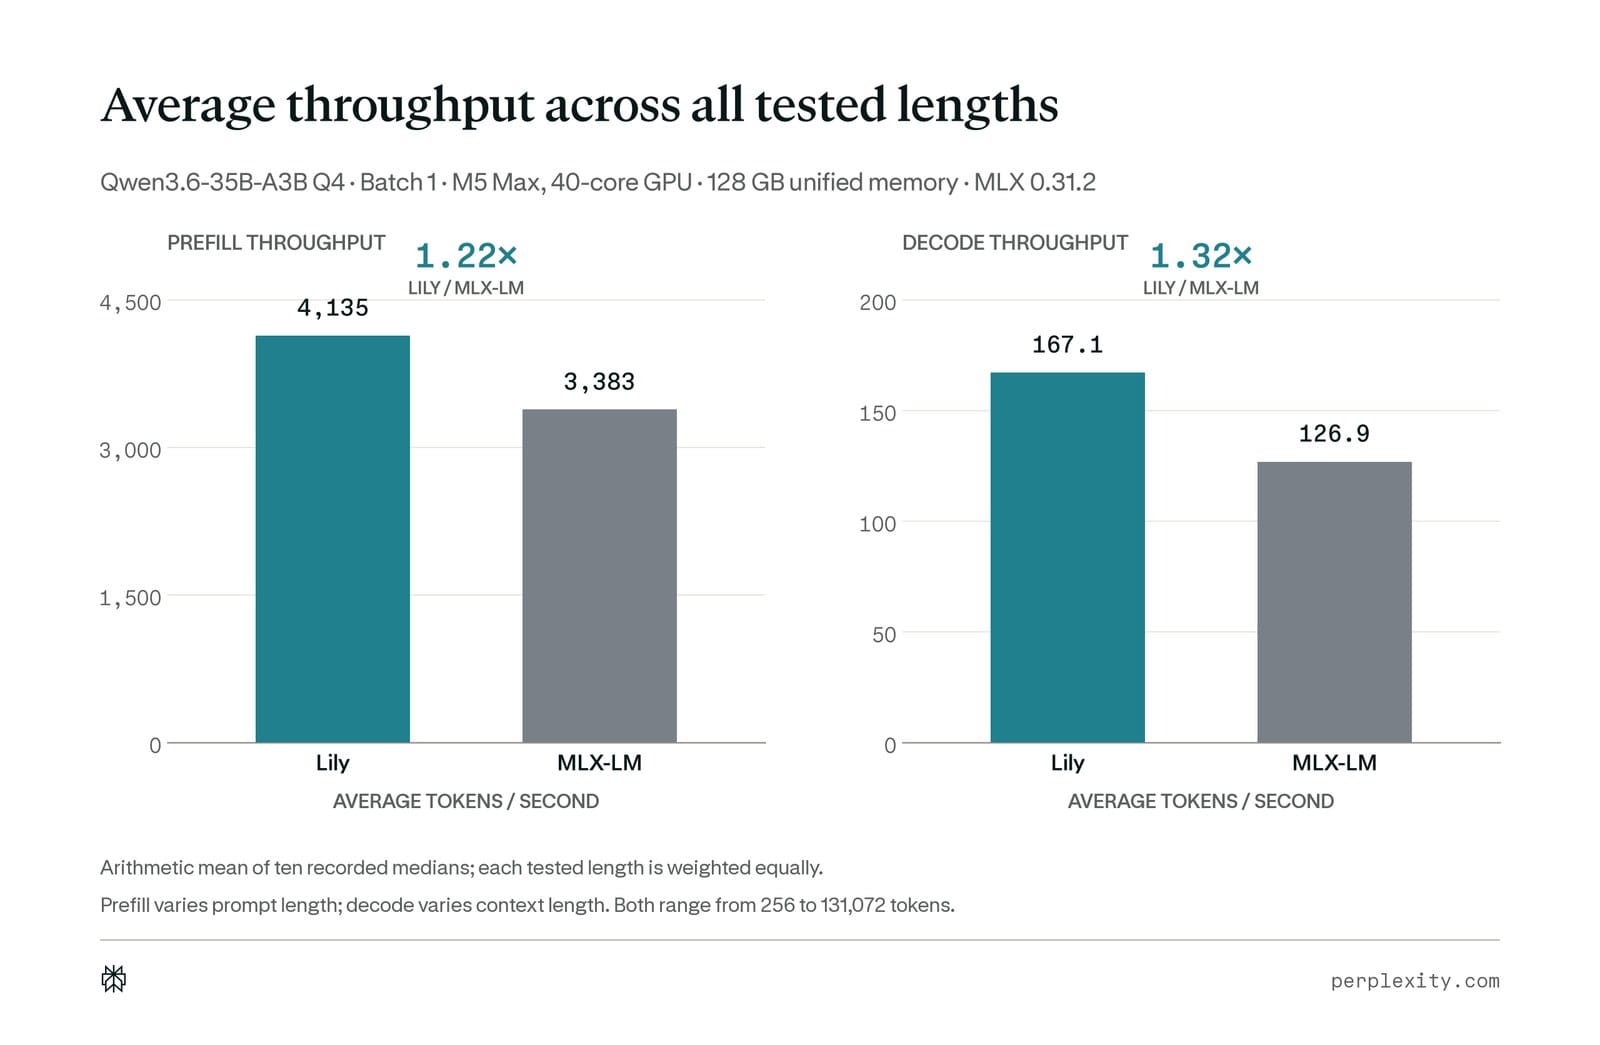
핵심은 한 줄이다. 모델 하나, 칩 하나. 대상은 Qwen3.6-35B-A3B(파라미터 약 350억, 토큰당 활성은 약 30억)뿐이고, 하드웨어는 Apple Silicon(GPU family 10+, 즉 M5 이상)뿐이다. 실행 경로에 PyTorch도 MLX도 없다. Rust 런타임이 체크포인트를 올리고, 손으로 짠 Metal 커널이 돌리며, OpenAI 호환 chat-completions API로 토큰을 내보낸다. M5 Max(40코어 GPU, 통합 메모리 128GB)에서 MLX-LM 대비 프리필 평균 1.23×, 디코드 평균 1.35×를 공식 수치로 내세운다.
배경 및 맥락
Hybrid Compute는 역할을 나눈다. 클라우드의 큰 모델이 조사·추론을 맡고, 맥 안의 로컬 모델이 개인 파일·앱과 붙는다. 이 분업이 “끊기지 않게” 느껴지려면, 로컬 쪽이 프리필(프롬프트를 먼저 넣는 단계)과 디코드(토큰을 하나씩 뽑는 단계) 모두에서 속도를 유지해야 한다. Mac에서 LLM을 돌리는 기본 스택은 Apple의 MLX와 텍스트 생성용 MLX-LM이다. 범용이라서 여러 아키텍처를 받아 주지만, 그 대가로 한 모델에 끝까지 맞춘 스케줄·데이터 이동을 포기한다.
Lily는 그 범용성을 버린다. Qwen3.6-35B-A3B는 희소 MoE(라우터가 전문가 256개 중 8개를 고르고, 공유 전문가 하나가 모든 토큰을 봄)에다, 풀 어텐션 10층과 Gated DeltaNet(고정 크기 순환 상태로 과거를 압축하는 층) 30층을 섞은 하이브리드다. 워크로드가 불규칙하니, “재사용 가능한 연산”보다 “이 모델·이 칩에만 맞는 경로”가 이득이 된다. Perplexity는 그 전제를 제품(Computer)과 오픈소스(demo 서버)로 동시에 열었다.
주요 내용 분석
| 항목 | 내용 |
|---|---|
| 무엇인지 | Rust + Metal 단일 프로세스 로컬 추론 서버 (OpenAI 호환 HTTP) |
| 모델 | Qwen3.6-35B-A3B만. MLX affine 4-bit(그룹 64). Dense·GGUF·AWQ·GPTQ 등 거부 |
| 하드웨어 | Apple GPU family 10+(M5+), macOS 26+, 통합 메모리 현실적으로 32GB 이상 |
| 벤치(공식) | M5 Max 40코어·128GB. 프리필 평균 1.23×, 디코드 평균 1.35× vs MLX-LM |
| 라이선스·위치 | Apache-2.0 · perplexityai/pplx-garden/lily |
왜 좁히면 빨라지나
Qwen이 만드는 부하는 대략 세 갈래다. (1) 전문가마다 토큰 수가 다른 MoE 그룹, (2) 컨텍스트가 길어질수록 커지는 KV 캐시 어텐션, (3) 토큰 순서에 묶인 고정 크기 순환 상태. MLX-LM도 Qwen용 커널·GQA(그룹 쿼리 어텐션: 쿼리 헤드 여러 개가 KV 헤드를 공유) 인식 어텐션을 쓰지만, 연산은 “여러 모델에 재사용” 가능한 형태를 유지해야 한다. Lily는 모델 구조·페이즈별 실행 계획·커널 선택을 한 Rust 런타임에 몰아넣는다.
프리필: 가중치를 펼치지 않고 곱한다
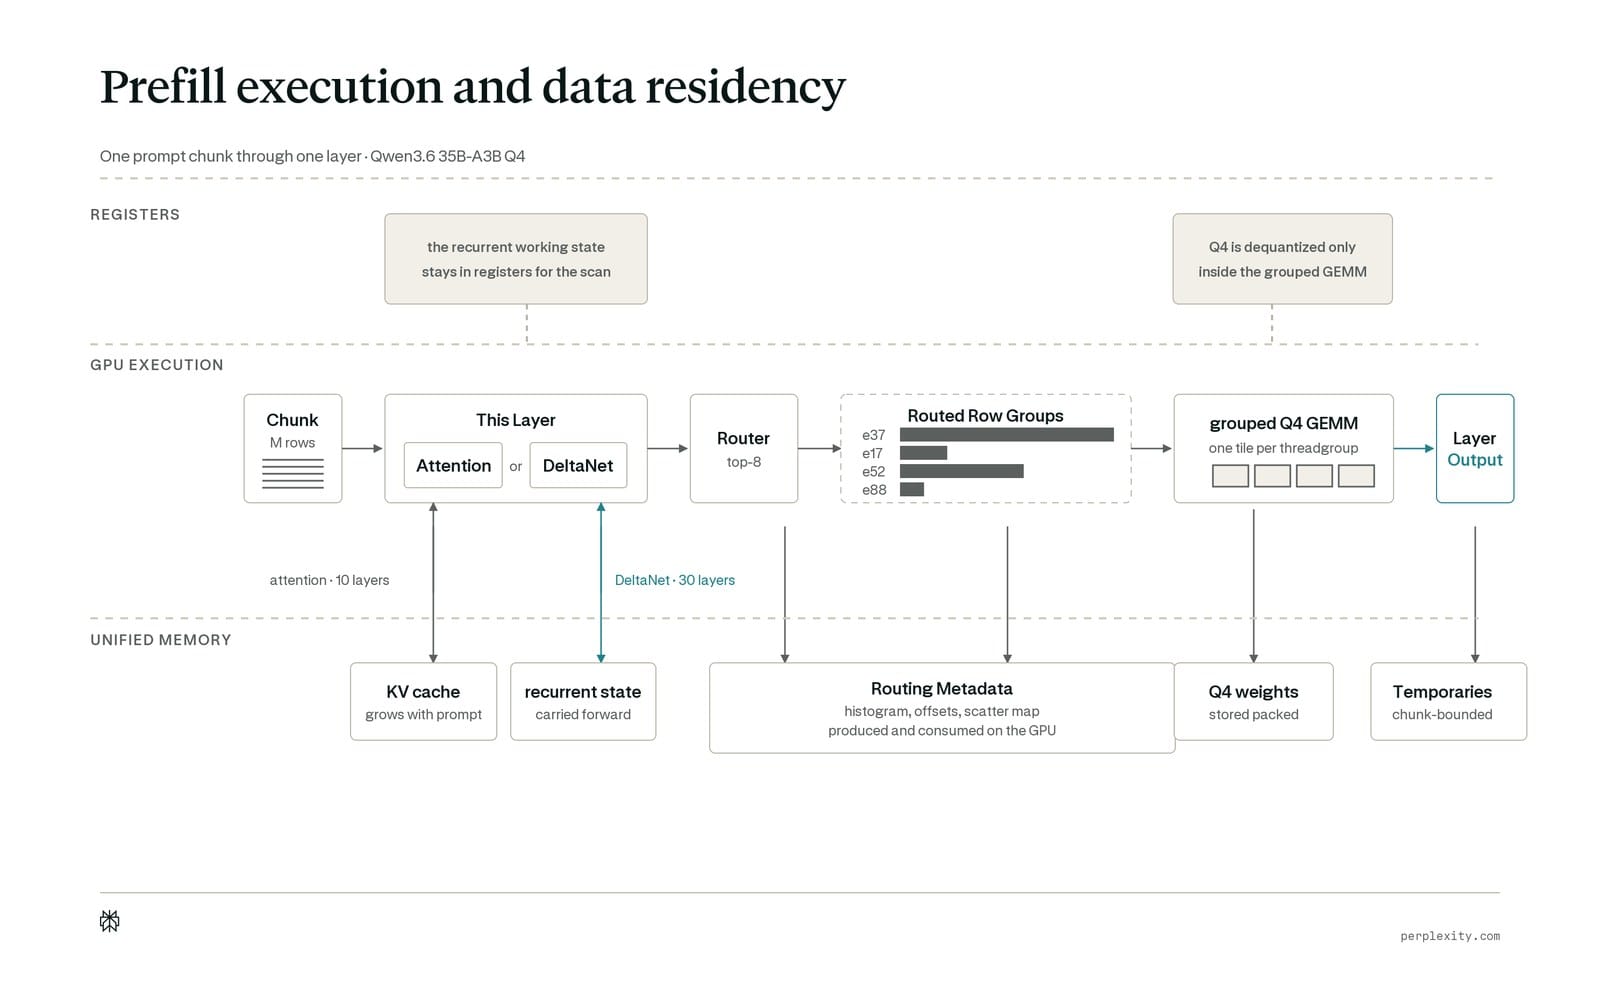
4비트 체크포인트는 약 19.4GB다(bfloat16이면 대략 70GB 규모를 압축한 형태). Metal 텐서 연산은 bfloat16을 쓰므로 가중치를 복원해야 하는데, Lily는 그룹 GEMM 안에서 타일 단위로 디퀀트(4비트→실수 복원)를 합쳐 확장 배열이 통합 메모리에 통째로 안 나오게 한다. 공식 ablation 기준으로 512토큰 프롬프트에서 이 융합만으로 엔드투엔드 프리필이 +77.4% 올랐다. 라우팅 히스토그램·프리픽스 스캔·스캐터를 GPU 커맨드 버퍼 안에 묶어 CPU 동기화를 줄인 쪽은 +89%. 긴 프롬프트는 임시 활성값이 가중치·캐시와 메모리를 다투지 않도록 덩어리로 자른다.
디코드: 바이트를 덜 움직인다
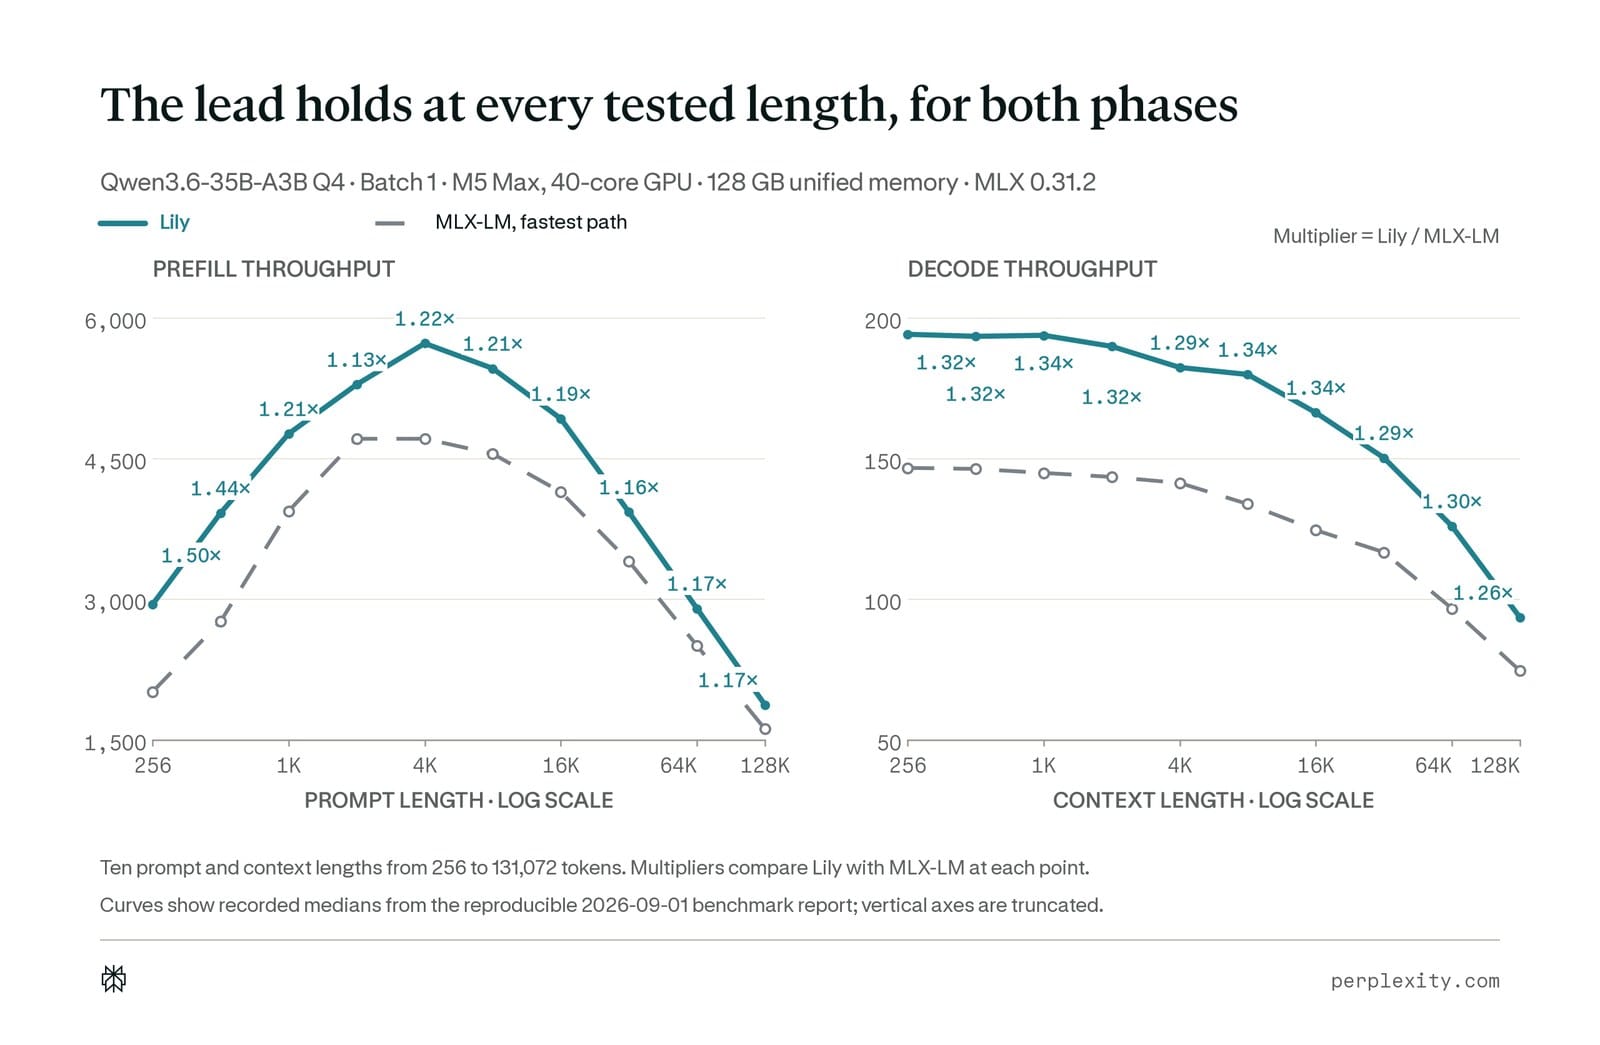
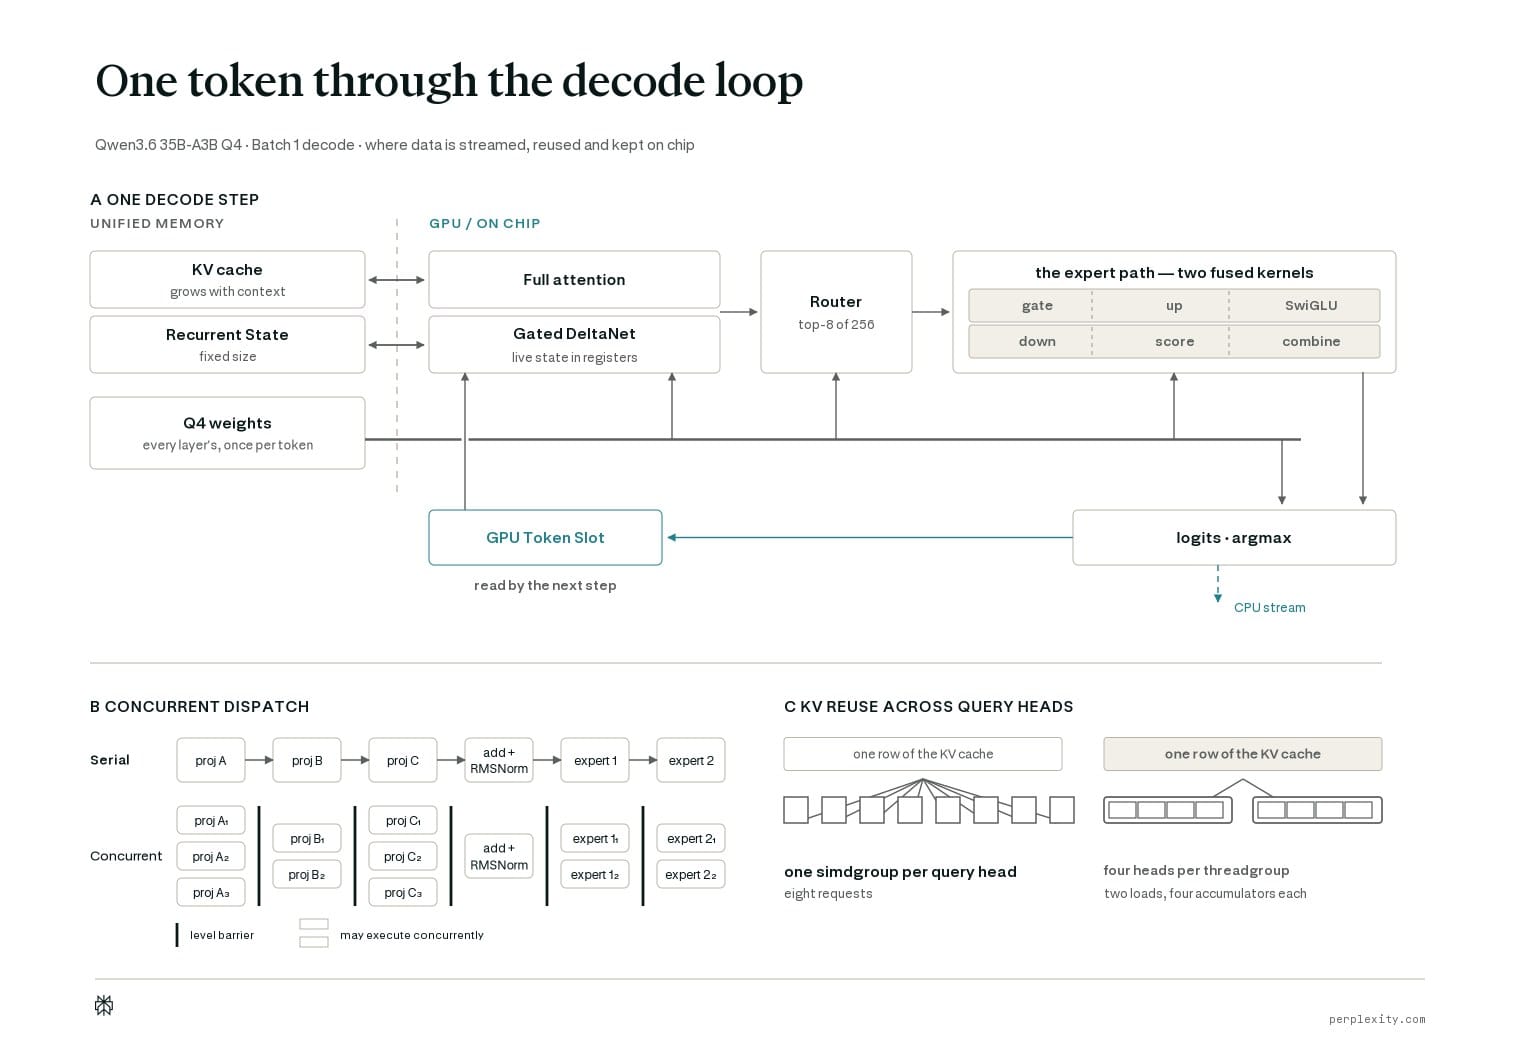
배치 1 디코드는 가중치 재사용이 거의 없어 대역폭이 천장이다. Lily는 실제 의존성만 남긴 동시 Metal 패스로 독립 커널을 겹치고, 고른 토큰을 다음 스텝의 GPU 입력 슬롯에 바로 쓴다. GQA 패킹(쿼리 헤드 네 개가 한 스레드그룹에서 KV 행을 한 번만 로드)은 32K에서 디코드 +23.8%, 고정 블록 어텐션은 128K에서 +40.2%를 공식 수치로 적었다. 4K 프롬프트·4K 컨텍스트에서는 프리필 5,749.9 tok/s · 디코드 186.6 tok/s(MLX-LM 4,737.5 · 140.9)다.
의도적으로 닫아 둔 API
README 기준 서버는 POST /v1/chat/completions, GET /v1/models, GET /health만 연다. 텍스트 메시지·max_tokens·비스트리밍·선택적 prompt_cache_key만 받고, 샘플링·툴·멀티모달·스펙큘러티브 디코딩은 거절한다. 디코드는 항상 그리디(가장 높은 확률 토큰만 고름). 체크포인트도 지정 리비전(mlx-community/Qwen3.6-35B-A3B-4bit)을 로드 시 검증한다. “아무 모델이나”가 아니라 “이 체크포인트가 제품 경로와 같아야 한다”는 태도다. 세션 프리픽스 캐시는 엔트리 두 개의 LRU로, 토큰 열이 엄격한 접두사일 때만 재사용한다.
실사용자 반응
공개 직후 반응은 “또 하나의 로컬 서버”보다 전용 엔진이 범용 스택을 이긴 수치와 문턱으로 갈린다. M5·macOS 26·약 19.4GB 체크포인트·통합 메모리 32GB급은 “맥북이면 바로”가 아니다. 반대로 Hybrid Compute·에이전트 루프를 돌리는 쪽에서는 멀티턴마다 쌓이는 프리필·디코드 이득이 체감 포인트로 읽힌다. teacher-forced 비교에서 perplexity가 0.04%만 높고 동일 top 토큰이 96.35%라는 문장은, “속도만 올리고 품질을 버린 엔진” 반박용으로 자주 인용될 만하다. 저장소 쪽 시선은 pplx-garden 안의 fabric-lib·unigram 옆에 lily가 붙었다는 점—제품 추론 스택의 한 조각을 그대로 열었다는 신호—에 모인다.
의미와 시사점
첫째, 온디바이스 경쟁의 축이 “지원 모델 수”에서 “한 모델·한 칩의 처리량”으로 이동한다. Spark X2.5가 엣지에서 1M 컨텍스트를 내세웠다면, Lily는 맥 Hybrid Compute의 병목을 부수는 전용 런타임을 내세운다. 둘 다 “작은 범용”이 아니라 “역할이 고정된 엔진”이다.
둘째, MLX를 대체한다기보다 MLX가 열어 둔 자리 위에 전용 런타임이 앉는다. 공식 글도 MLX-LM을 출발점으로 두고, 재사용 제약 때문에 못 가는 최적화를 Lily가 가져간다고 쓴다. 오픈소스 Mac 추론이 “프레임워크 vs 제품 엔진” 이층 구조로 가는 신호다.
셋째, 좁은 API는 버그가 아니라 계약이다. 그리디만, 스트리밍 없음, 툴 없음—에이전트 하네스(에이전트를 감싸 세션·도구·검증을 붙이는 실행 틀)가 바깥에서 오케스트레이션하고, 로컬은 토큰 공장에 가깝다. Computer 제품 철학이 데모 서버 표면에 그대로 남아 있다.
넷째, 재현 문서(2026-09-01·09-02 MLX 버전별 리포트)가 측정 계약까지 공개된 점은 벤치 신뢰에 도움이 된다. 다만 최신 MLX와의 격차는 버전에 따라 흔들릴 수 있으니, README의 날짜 붙은 표를 기준으로 읽는 편이 안전하다.
마치며
Lily는 “Mac에서 아무 LLM이나 더 빨리”가 아니다. Qwen3.6-35B-A3B × Apple Silicon이라는 한 쌍에 Rust와 Metal을 맞춰, Hybrid Compute의 로컬 다리를 제품 밖으로 연 엔진이다. 숫자(1.23×·1.35×, 4K에서 5.7k/186 tok/s)는 Perplexity·벤치 머신 기준이고, 문턱(M5, macOS 26, 메모리)은 높다. 그래도 방향은 분명하다. 범용 스택이 깔린 뒤에, 한 모델에 끝까지 특수화한 런타임이 로컬 AI의 다음 레버가 된다.
출처: Perplexity Hub — Optimizing On-Device Inference for Apple Silicon · GitHub lily · 성능 리포트 2026-09-02
이 글은 AI가 작성하여 자동 발행된 콘텐츠입니다.