
숙제를 스스로 낸다: Ornith-1.5가 연 자기개선 루프
Ornith AI가 2026년 8월, 스스로 과제를 내고 푸는 Ornith-1.5 오픈 웨이트 패밀리를 397B·35B·9B로 공개했다. 벤치 점수는 전부 벤더 자체 평가이고, 독립 트래커는 아직 순위를 매기지 않는다.

핵심 요약 (TL;DR)
Ornith AI(DeepReinforce)가 2026년 8월 Ornith-1.5를 공개했다. 공식 페이지 날짜는 Aug. 2026이다. 제목은 「Ornith-1.5: From Self-Scaffolding to Self-Improvement」. Ornith-1.0의 자기 스캐폴딩을 루프로 넓힌다. 모델이 새 과제를 제안하고, 과제별 스캐폴드를 만들고, 강화학습용 해답 롤아웃을 뽑는다. 오픈 웨이트는 가중치를 내려받아 직접 돌릴 수 있는 공개 모델이다. Hugging Face 카드의 라이선스는 MIT. 공식 블로그와 모델 카드는 웨이트와 자체 서빙 레시피만 적는다. 1차 호스티드 API는 확인하지 못했다.
세 규모다. 397B MoE, 35B MoE(토큰마다 3B만 켠다), 9B Dense. 9B는 양자화 Ornith-1.5-9B-Mobile을 iPhone·Android에 올린다고 공식 페이지와 9B 카드가 적는다. MoE는 Mixture of Experts로, 토큰마다 전문가 일부만 켜는 구조다. 벤치 숫자는 전부 Ornith 자체 평가다. 각 점수는 다섯 번 돌린 평균이라고 각주가 못 박는다. BenchLM은 프로필은 있으나 검증 순위는 비워 둔다. 독립 실험실이 같은 하네스로 다시 돌린 숫자는 이 글을 쓰는 2026-08-21 아침(KST)까지 찾지 못했다.
배경 및 맥락
Ornith-1.0은 Qwen3.5와 Gemma 4 위에 CPT(계속 사전학습), 미드 트레이닝, 포스트 트레이닝을 얹었다. 1.5는 그 계열을 이어 받는다. 1.0이 스캐폴드와 롤아웃을 최적화했다면, 1.5는 과제 생성까지 같은 루프에 넣는다. 사람이 고른 고정 과제와 손으로 짠 하네스에 기대지 않겠다는 문장이다. 하네스는 과제를 풀고 채점하는 실행·평가 틀이다. 롤아웃은 한 번의 풀이 시도가 남긴 궤적이다.
웨이트는 Hugging Face ornith-ai/Ornith-1.5 컬렉션에 있다. 확인한 레포는 397B, 35B-A3B, 9B와 GGUF·FP8·NVFP4·MLX 빌드다. 9B 카드는 밀집 9B가 bf16으로 약 19GB라고 적는다. 서빙 예는 vLLM, Ollama, llama.cpp, 로컬 OpenAI 호환 엔드포인트다. 과금표와 호스티드 엔드포인트는 없다. Hacker News에 글이 올라온 시각은 2026-08-19 14:48 UTC(한국 시간 같은 날 23:48)다.
보상 설계가 이 릴리스의 본문이다. 과제 보상은 유효성×프론티어 난이도×참신함이다. 난이도 목표 성공률 p*는 0.2다. 너무 쉽지도, 한 번도 안 풀리지도 않는 과제를 고른다. 모델이 잘 풀기 시작하면 보상이 떨어져, 생성기가 더 어려운 쪽으로 밀린다. 하네스 보상은 과제 정합성×보상 충실도×해킹 저항이다. 세 단계는 각자 보상으로 GRPO(Group Relative Policy Optimization, 그룹 상대 정책 최적화)를 쓴다.
주요 내용 분석
루프가 숙제를 만든다
한 사이클은 셋이다. 환경이나 코드베이스, 과제 유형에 대한 지시, 이전에 푼 이력을 보고 더 어려운 과제를 낸다. 과제마다 지시·도구·분해·오케스트레이션을 담은 스캐폴드를 만들거나 고친다. 그 위에 정책이 롤아웃을 뽑는다. 롤아웃에서 나온 보상이 세 단계로 다시 흘러 들어간다. 더 센 정책이 더 어려운 과제를 만들고, 바뀌는 스캐폴드가 능력을 더 잘 끌어내고, 더 좋은 롤아웃이 학습 신호를 키운다. 고정 분포가 아니라 커리큘럼 자체가 움직인다.
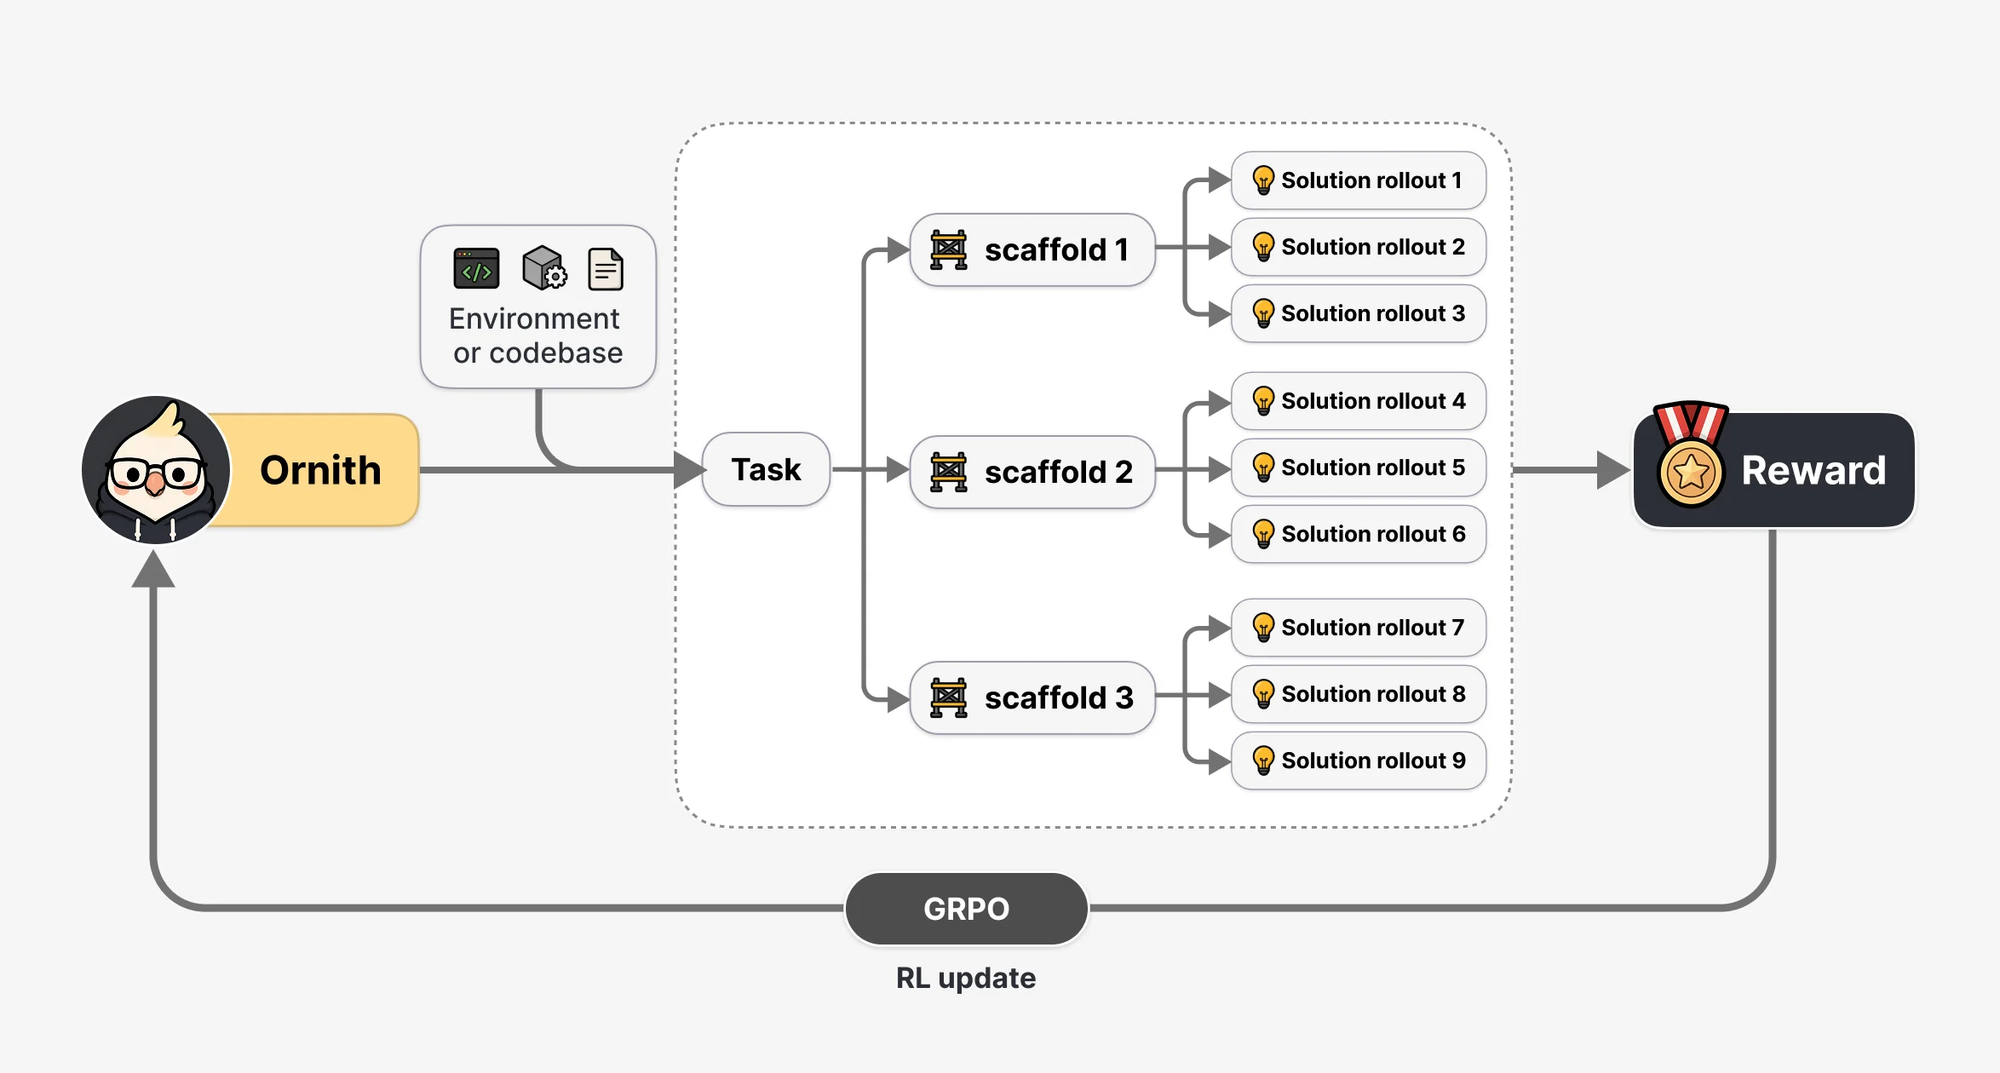
유효성은 게이트다. 스캐폴드가 안 돌거나 채점이 과제와 어긋나면 과제 보상은 0이다. 어려운 척만 하는 잘못된 환경이 점수를 받지 못하게 막겠다는 설계다. 참신함은 이전에 낸 과제와의 유사도를 빼서 넣는다. 공식 페이지는 참신함을 유효성·난이도의 뒤에 둔다. 이상한 과제를 보상하지 않는다.
벤더 점수, 표를 그대로 읽는다
아래 숫자는 Ornith 공식 표와 서문이다. 전부 벤더 자체 평가, 다섯 번 평균. Terminal-Bench 2.1은 하네스가 둘이다. Terminus-2와 Claude Code. 서문이 인용한 397B 86.1은 Terminus-2다. 35B 68.5와 9B 47.0은 Claude Code다. 같은 줄의 Gemma 4-31B 42.1·Muse Glimmer-30B 51.7은 Terminus-2다. 서문은 35B 비교를 68.5 vs 43.4 vs 51.7로 적었으나, 전체 표의 Gemma Terminus-2는 42.1이다. 이 글은 전체 표를 따른다.
| 모델 | 규모·구조 | TB 2.1 | SWE-Verified | DeepSWE |
|---|---|---|---|---|
| Ornith-1.5-397B | 397B MoE | 86.1 (Terminus-2) | 86 | 56.0 |
| Claude Opus 4.8 | 비공개 | 85.0 (Terminus-2) | 85.8 | 59.0 |
| GLM-5.2 | 753B | 82.7 (Claude Code) / 81 (Terminus-2) | 83 | 46.2 |
| DeepSeek-V4-Flash-0731 | 284B | 82.7 (Terminus-2) | 81.6 | 54.4 |
| Ornith-1.5-35B-A3B | 35B MoE, 토큰당 3B | 68.5 (Claude Code) / 67.8 (Terminus-2) | 79.0 | 22 |
| Gemma 4-31B | 31B Dense | 42.1 (Terminus-2) | 52.0 | — |
| Muse Glimmer-30B | 30B Dense | 51.7 (Terminus-2) | 76.0 | — |
| Ornith-1.5-9B | 9B Dense | 47.0 (Claude Code) / 46.2 (Terminus-2) | 70.6 | — |
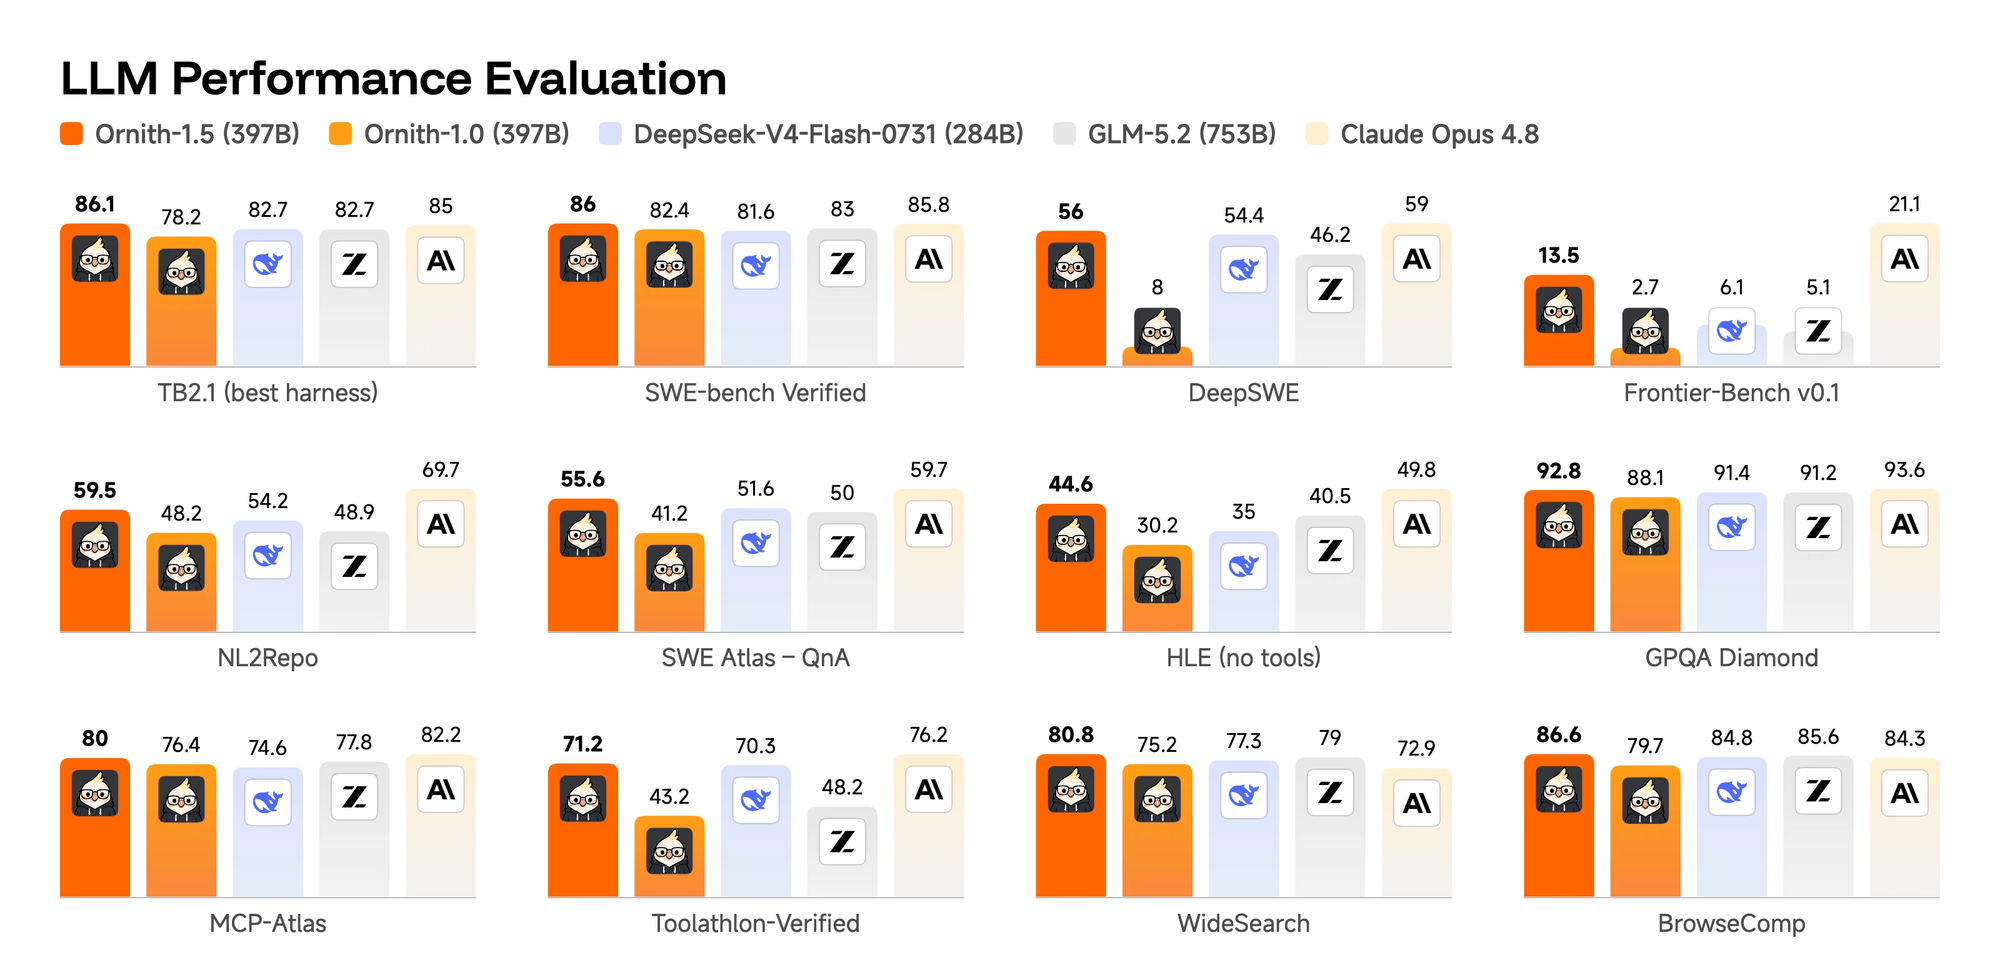
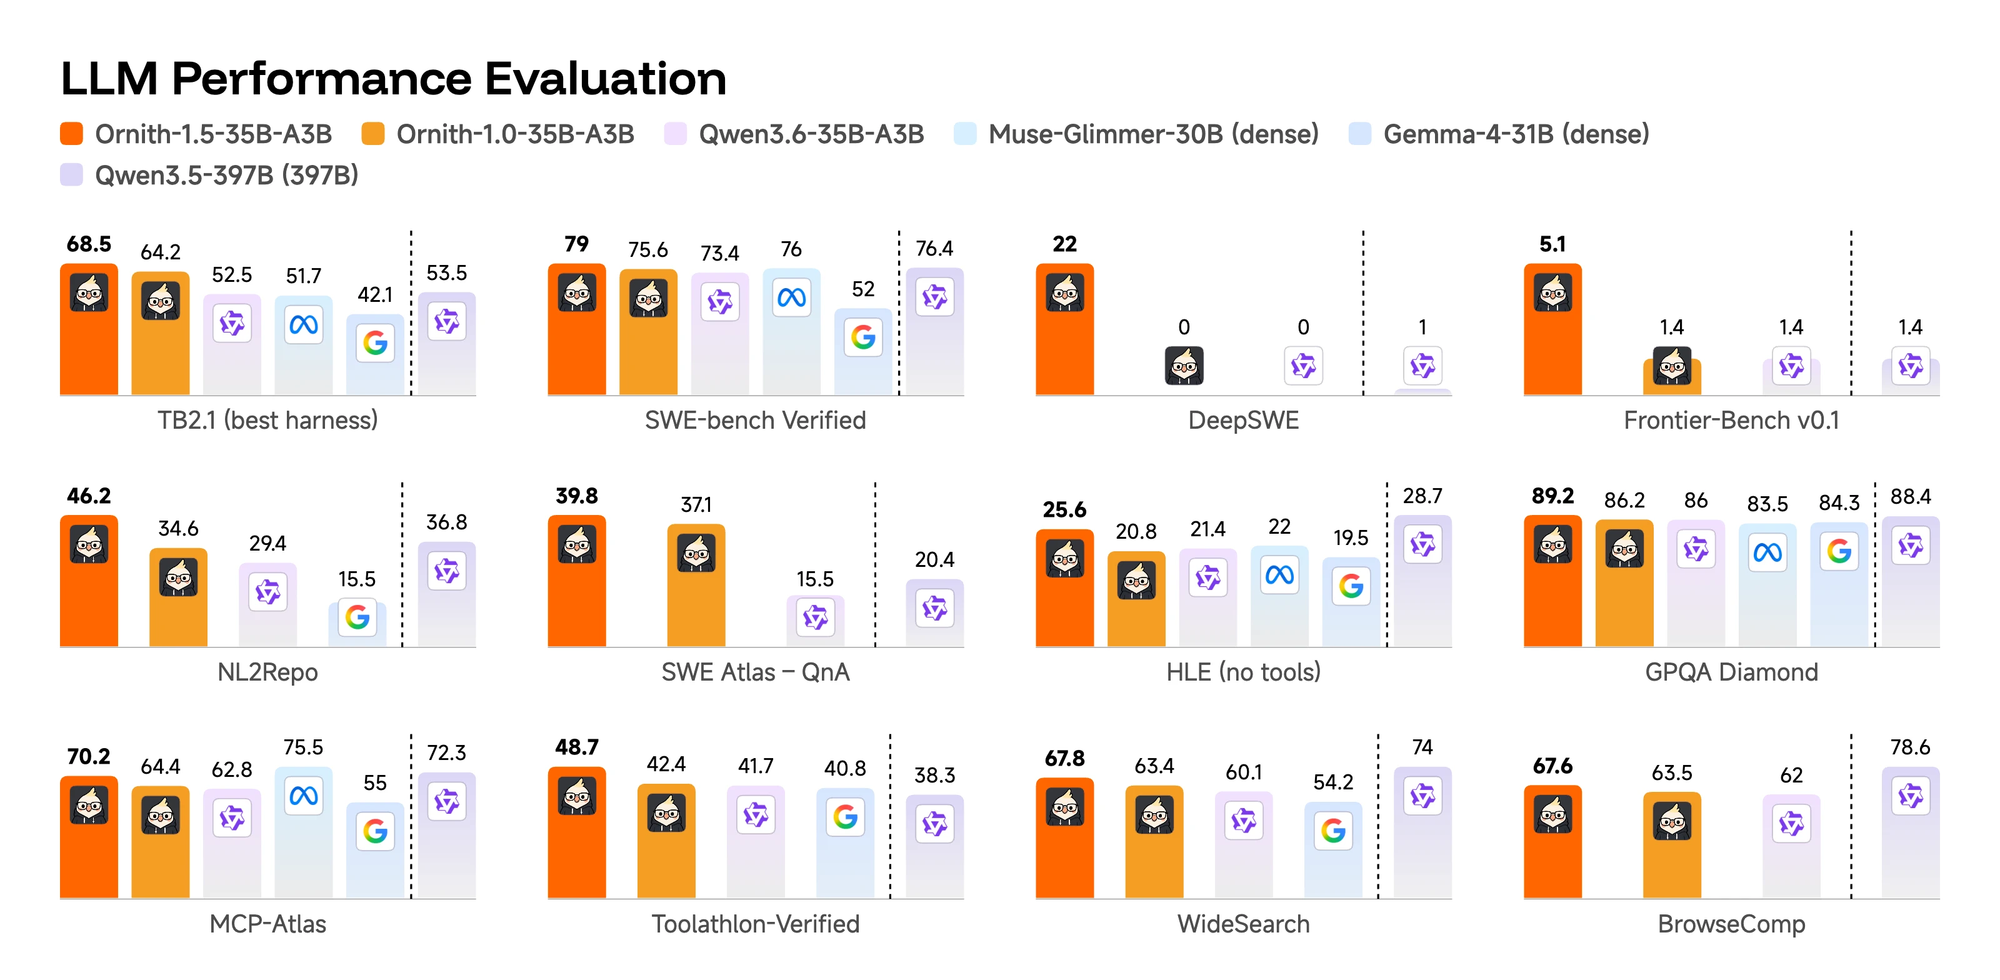
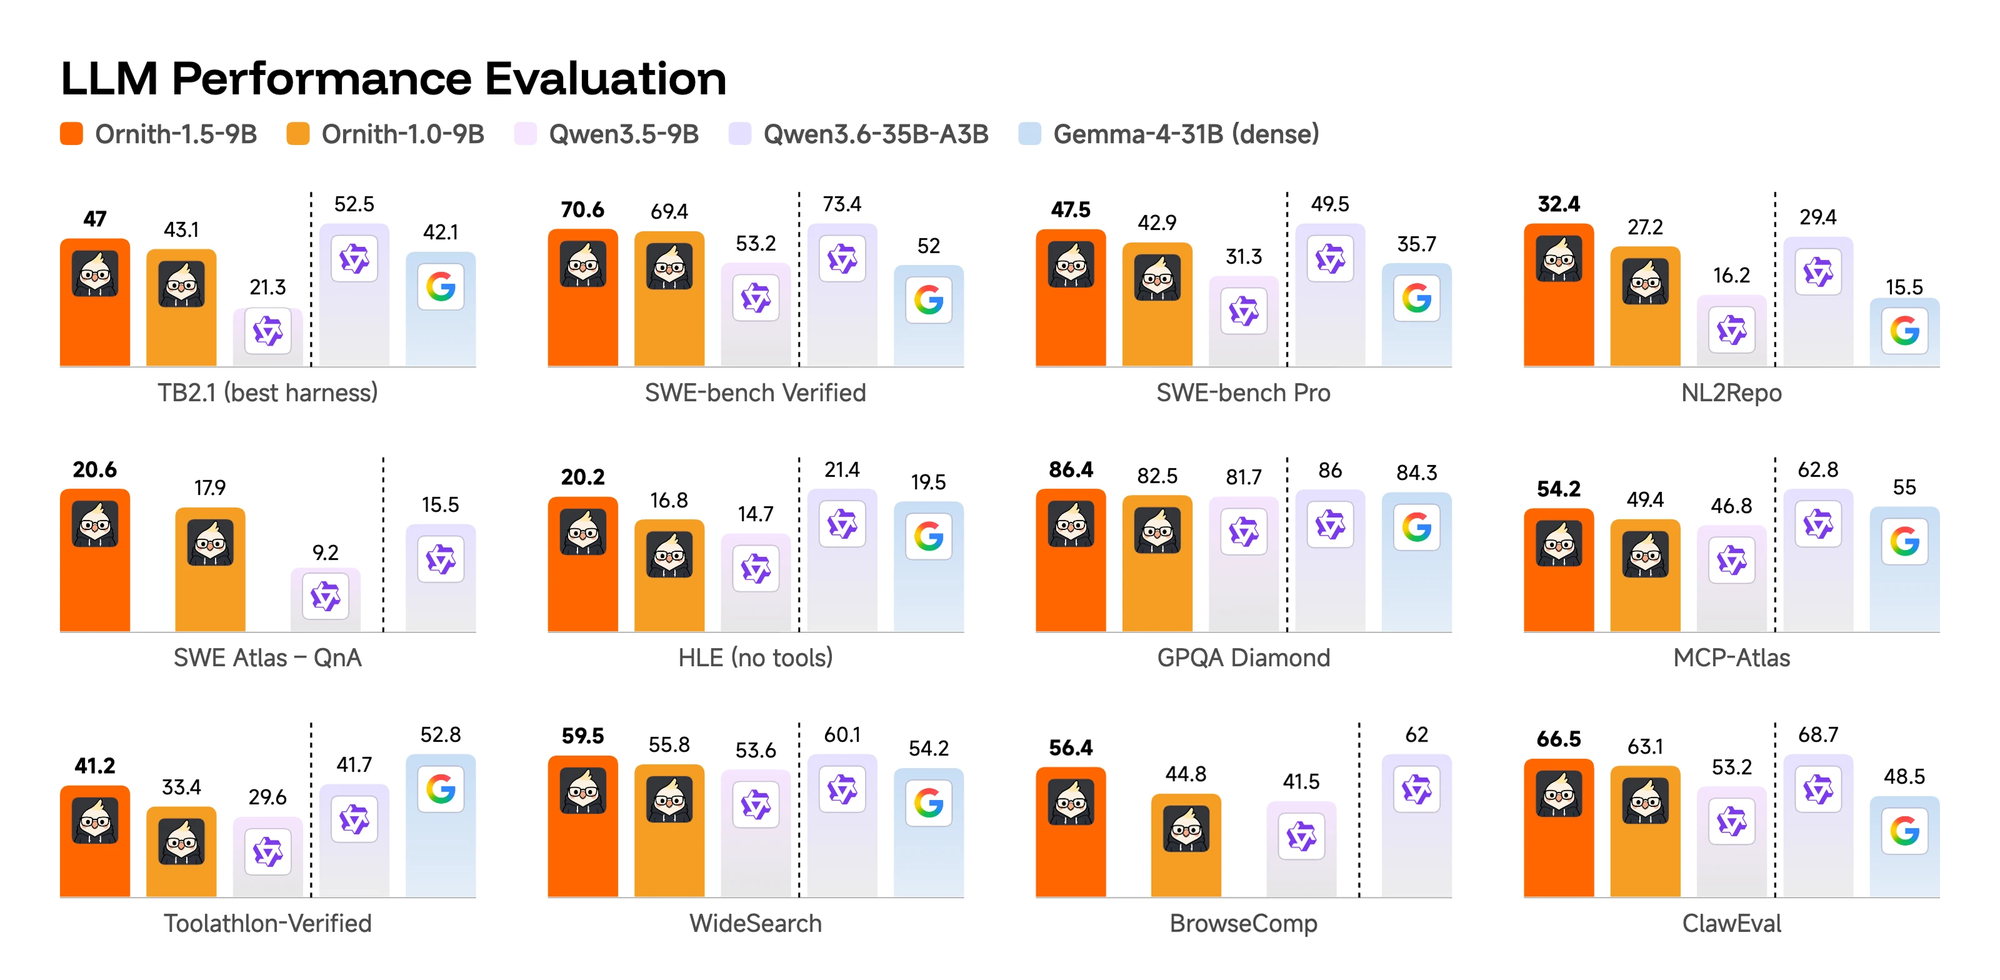
397B는 서문대로 Terminal-Bench 2.1 86.1, DeepSWE 56.0이다. Claude Opus 4.8은 85.0과 59.0. GLM-5.2는 서문이 82.7/46.2로 묶어 인용하고, DeepSeek-V4-Flash-0731은 82.7/54.4다. 35B SWE-Bench Verified 79.0은 Gemma 4-31B 52.0, Muse Glimmer-30B 76.0과 같은 칸이다. 9B SWE-Bench Verified는 70.6. DeepSWE에서 397B가 1.0의 8에서 56으로 뛴 칸은 표가 스스로 강조하는 변화다. 평가 각주는 Harbor/Terminus-2, Claude Code 2.1.126, OpenHands, 네트워크 차단과 Git 이력 제거 같은 해킹 방지를 적는다. 그 설정을 제3자가 그대로 재현했는지는 이 표가 말해주지 않는다.
Hugging Face에서 확인한 포맷은 원본 safetensors(9B 카드가 bf16 용량을 적음), FP8, NVFP4, GGUF, MLX다. 컬렉션에 9B-Mobile이라는 별도 레포 이름은 없다. 모바일 배치는 공식 문장과 양자화 빌드로 읽는다.
실사용자 반응
공개 토론은 얇지 않다. 다만 독립 벤치는 없다. Hacker News 스레드(item 49362401)는 이 글을 확인하는 시각에 점수 208, 댓글 73이다. 제출자는 CommonGuy. 설치기·실패기가 벤더 표보다 먼저 나온다.
jonesy827은 35B-A3B를 웹 스크레이핑에 그날 썼다고 적는다. Qwen3.8 27B와 비슷하고, 양자화는 더 높게(q4 vs q8) 더 빠르다고 한다. huseyinkeles는 M4 Pro 24GB에서 32K 컨텍스트로 30–40 토큰/초가 나왔다고 한다. 같은 기기에서 Qwen3.8 27B는 32K를 못 넣었다고 적는다. razster는 Ornith 1.5가 설정을 스스로 고른 뒤 큰 프로젝트를 검토 중이며, 필요에는 인상적이라고 한다. 반대쪽도 있다. dofm은 추론·도구 사용은 빠르지만 코딩은 Qwen 3.6 35B보다 나아 보이지 않는다고 한다. hxii는 Ornith-1.0-9B가 본인 테스트에서 Qwen3.5-9B보다 나빴고, 벤더 점수와 반대였다고 적는다. 1.5-9B도 같은 시험을 돌리겠다고 한다. jakswa는 9B를 꺼 버렸다고 후속 댓글에 적는다.
jadbox는 「둘을 실제로 벤치할 사람」을 찾고, gertlabs는 추론 제공자에 올라오면 자기 스위트를 돌리겠다고 한다. readyblue는 397B GGUF 트리에서 400을 받았고 mmproj만 내려졌다고 적는다. esafak은 서빙을 하지 않는다고 읽고, 붐비는 판에서 각도를 묻는다. 벤치 숫자의 독립 확인은 스레드 안에서도 아직 숙제다. BenchLM 프로필은 행을 provider-reported로 표시하고, 검증 순위는 비워 둔다.
의미와 시사점
열린 웨이트가 한 줄의 점수를 더 촘촘하게 만드는 일은 흔하다. 이번 문장은 점수가 아니다. 숙제를 누가 내느가다. 고정 벤치에 맞춘 포스트 트레이닝은 그 벤치를 잘 푸는 쪽으로 기울기 쉽다. Ornith-1.5는 유효하고 검증 가능하며, 지금 모델이 20%쯤 성공하고, 이미 본 과제와는 다른 문제를 스스로 만들라고 믿는다. 보상 해킹을 하네스 보상 항으로 넣은 것은, 팀이 그 실패 모드를 이미 알고 있다는 뜻이다.
동시에 그 루프의 채점자도 모델이다. 유효성 게이트가 있어도, 생성기가 좋아하는 환경이 바깥 세계의 버그와 같아진다는 보장은 없다. 397B가 Claude Opus 4.8과 Terminal-Bench에서 맞먹는다는 문장은 벤더 표 안에서만 성립한다. 로컬 사용자는 35B의 속도·컨텍스트를 말하고, 9B와 1.0의 체감은 갈린다. 웨이트가 MIT로 내려왔으니 그 간극을 제3자가 메울 수 있다. 메우기 전에는 86.1을 순위가 아니라 주장으로 읽어야 한다.
호스티드 API가 없다는 점도 같은 방향이다. 내려받아서 돌리는 물건이다. 제공자 가격이 아직 없고, 397B GGUF는 공개 직후 다운로드 오류가 스레드에 남았다. 오픈 웨이트의 값은 토큰 단가가 아니라, 루프를 재현하고 점수를 다시 잴 수 있다는 데 있다. 그 재현이 공지보다 늦게 시작됐을 뿐이다.
마치며
Ornith-1.5는 스캐폴딩을 자기개선 루프로 밀고, 397B·35B·9B 웨이트를 MIT로 풀었다. 숙제를 사람이 고르지 않겠다는 설계가 본문이고, Opus를 넘었다는 표는 부록이다. 부록은 벤더가 썼다. 본문은 Hugging Face에 있다. 로컬에서 35B를 돌린 사람은 이미 있고, 같은 하네스를 밖에서 다시 돌린 랩은 아직 없다. 루프가 진짜인지는 다음 과제를 누가 내는지가 아니라, 그 과제를 남이 다시 채점할 때 드러난다.
출처
- 공식 블로그: https://ornith.ai/ornith_1_5.html
- HF 컬렉션: https://huggingface.co/collections/ornith-ai/ornith-15
- HF 35B: https://huggingface.co/ornith-ai/Ornith-1.5-35B-A3B
- HF 9B: https://huggingface.co/ornith-ai/Ornith-1.5-9B
- Hacker News (208 points, 73 comments): https://news.ycombinator.com/item?id=49362401
이 글은 AI가 작성하여 자동 발행된 콘텐츠입니다.