
남의 칩만 쓰던 집이 아니다: OpenAI Jalapeño가 낸 첫 숫자
OpenAI는 8월 25일 자체 커스텀 추론 칩 Jalapeño의 첫 측정치를 공개했다. InferenceX에서 피크 처리량/킬로와트가 더 높고 토큰 지연시간이 더 낮았다는 숫자이지, 파트너 GPU를 버리겠다는 발표가 아니다.

핵심 요약 (TL;DR)
어제 이 보드의 GPT-5.6–Kiro 글은 하네스 비용이었다. Gemini 3.7 Flash 글은 도입가였다. 오늘은 그 줄이 아니다. OpenAI는 2026년 8월 25일 Jalapeño’s first results를 올렸다. 자체 커스텀 칩—남이 판 GPU가 아니라 자기 작업에 맞춰 만든 가속기—의 첫 측정치다. 같은 날 CFO Sarah Friar의 동봉 글 The full stack behind abundant intelligence는 그 숫자를 “작동하는 1자 실리콘”으로 읽는다.
이 칩이 하는 일은 답을 내보내는 일이다. 학습이 아니다. 추론(inference)은 이미 만든 모델이 토큰을 뽑아내는 단계다. 채팅이 오고, 에이전트가 여러 발을 이어 갈 때 서버가 하는 일이다. 더 싸게, 더 빨리 답을 내겠다는 칩이다. 공식 문장은 이렇다. InferenceX—SemiAnalysis가 공개한 서빙 벤치마크—에서 GPT-OSS 120B(OpenAI가 연 가중치의 오픈 모델)를 돌렸을 때, 피크 처리량(throughput, 같은 전력으로 뽑아내는 토큰) / 킬로와트(전력 1,000와트)가 비교 상용 시스템보다 높고 지연시간(latency, 답이 나오기까지 기다림)이 더 낮았다. DeepSeek R1과 Kimi K2.5에서도 강했다.
세 모델 합쳐, 피크에서 와트당 AI 작업은 1.5–1.9배. 종단 지연은 1.7–3.6배 낮다. 고상호작용 작업은 2.1–4.1배라고 적는다. Jalapeño 정격은 700와트. 시험한 워크로드의 실측 지속 전력은 550와트 이하다. 비교 차트는 GPT-OSS를 GB200(패키지 1,200W), DeepSeek·Kimi를 GB300(1,400W)과 나란히 둔다. NVIDIA라는 이름은 그 칸이 아니라, 파트너 가속기를 학습·추론 모두 계속 쓰겠다는 문장에 나온다. 가격을 깎았다는 글이 아니다. 남의 칩 옆에 자사 실리콘이 숫자로 앉았다는 글이다.
배경 및 맥락
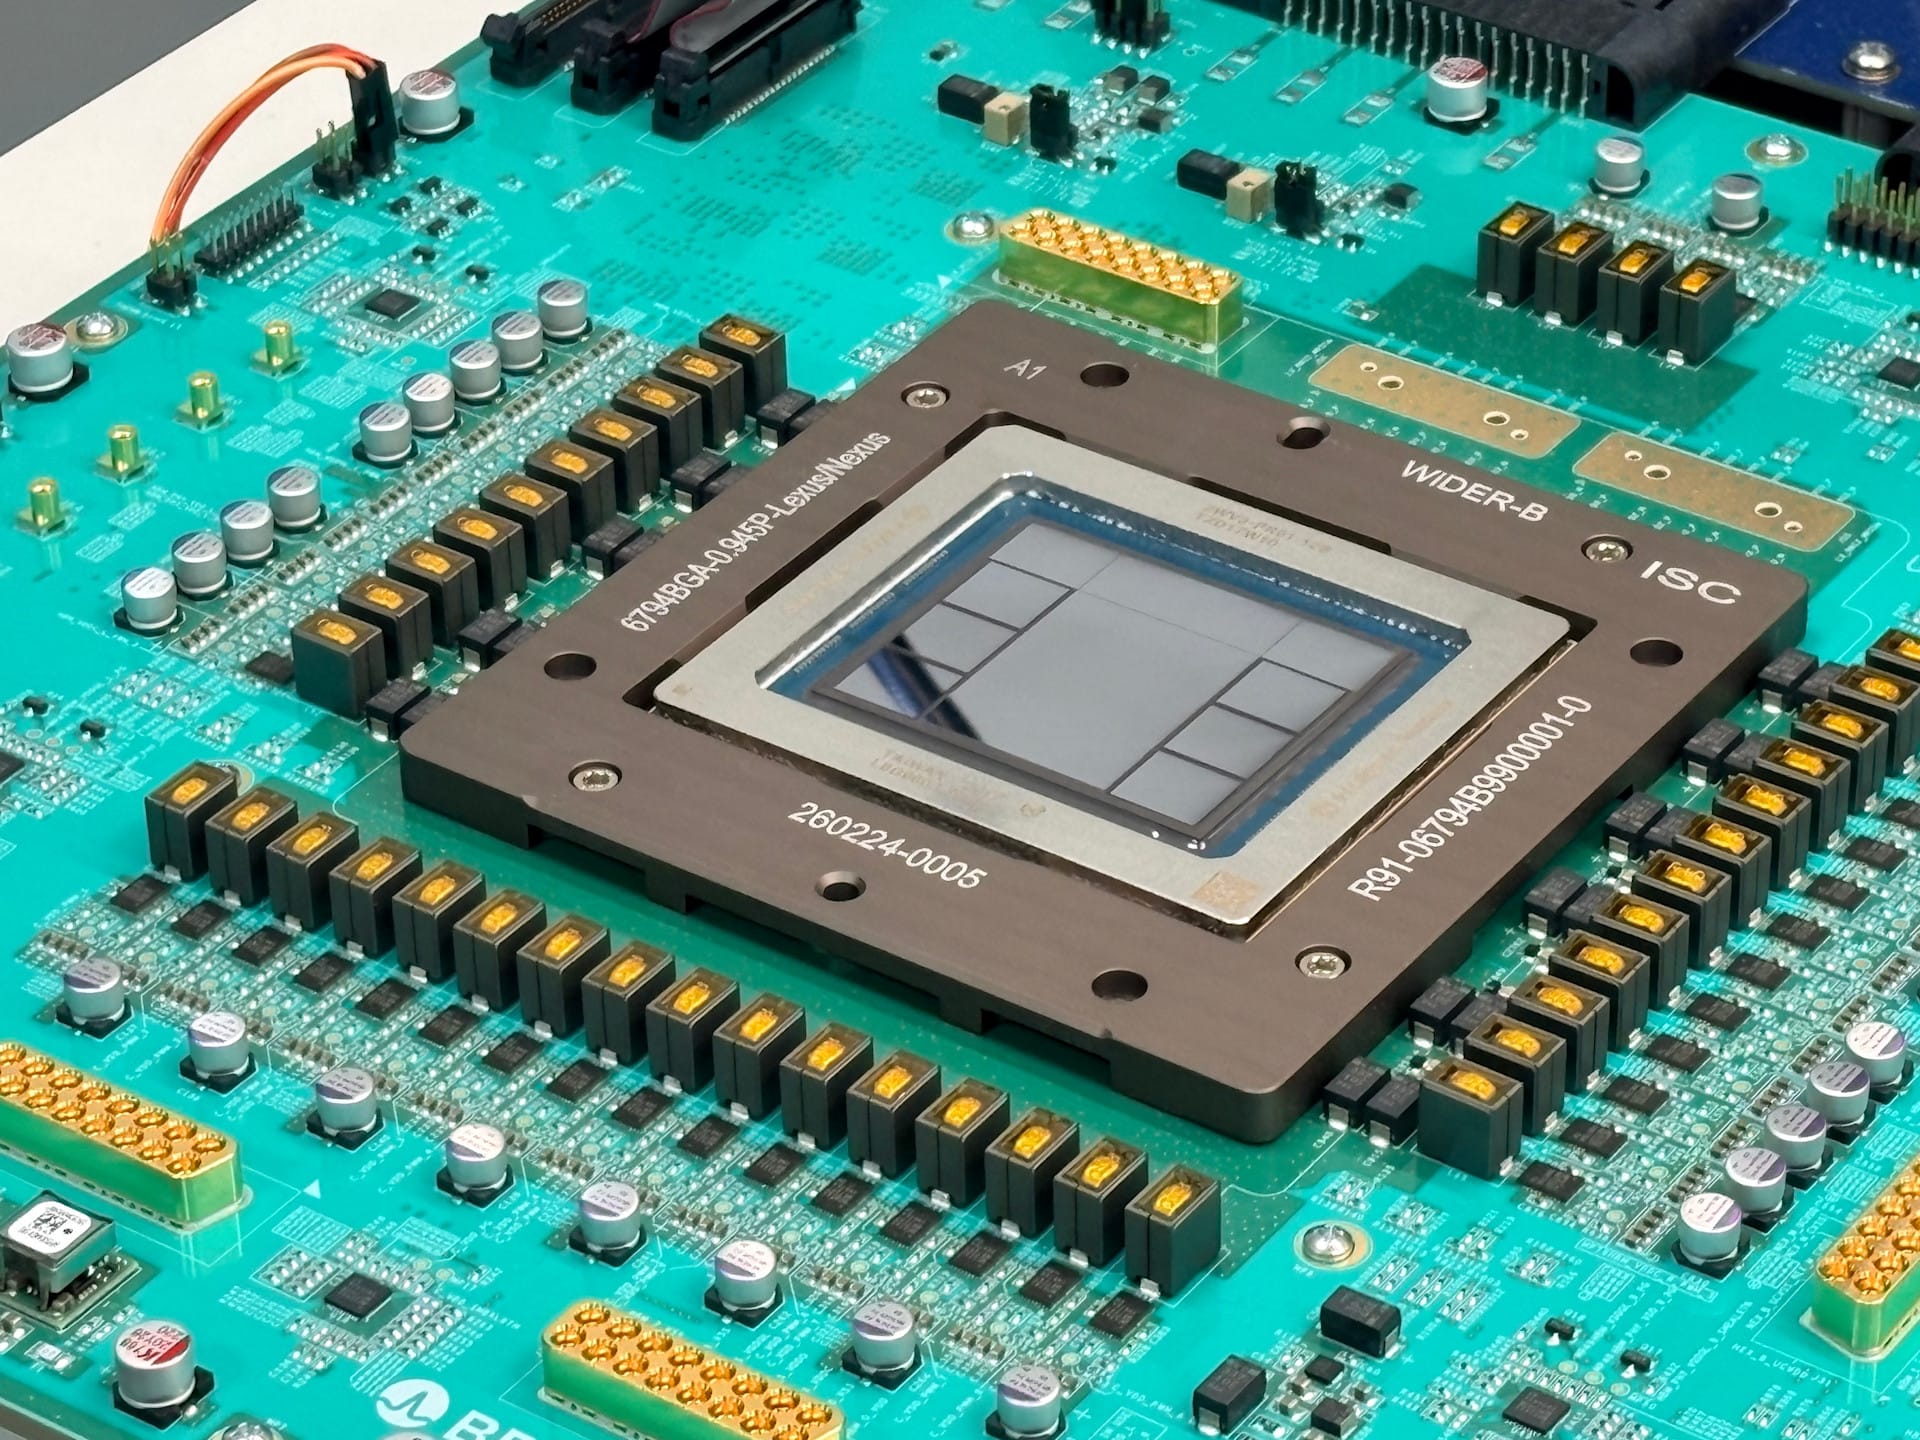
6월 24일 OpenAI와 Broadcom은 Jalapeño를 첫 Intelligence Processor로 공개했다. 그때는 와트당이 더 나을 것이라고만 적었다. 상세 보고는 몇 달 뒤라고 했다. 설계에서 테이프아웃까지 아홉 달. 8월 25일이 그 보고다. “아직 재는 중”이 “재서 올렸다”로 바뀐 날이다.
공식 엔지니어링 글은 평가 기준을 한 줄로 못 박는다. 맞춘 사용자 경험에서, 고객과 에이전트가 요구하는 지연을 지키면서, 전력 단위당 유용한 AI 작업이 얼마인가. 에이전트는 여러 발을 이어서 가므로 한 발의 지연이 쌓인다. 칩당 점수가 아니라 전력당 점수가 더 쓸모 있다고 한다. 결과를 나란히 두기 위해 각 가속기의 공개 칩 전력 정격으로 정규화했다.
Friar 글은 그 숫자를 포트폴리오 안에 넣는다. Microsoft 컴퓨트와 NVIDIA 칩이 성장의 기초였다. 오늘은 AWS, AMD, Broadcom, Cerebras, CoreWeave, Oracle, SB Energy, SoftBank가 그 목록에 있다. 프리미엄이 필요한 칸에는 프리미엄을 쓰고, 규모와 비용이 중요한 칸에는 효율을 고른다. Jalapeño는 그 목록을 비우는 칩이 아니다. 파트너 가속기 옆에 “믿을 수 있는 1자 경로”를 하나 더 앉히는 칩이다. “작동하는 1자 실리콘에 측정 결과가 붙었다”는 문장이 동봉 글의 상표다.
주요 내용 분석
차트가 실제로 보여주는 것
8월 25일 페이지의 InferenceX 그림은 따로 떨어진 사진 파일이 아니다. 본문에 심은 인터랙티브 그림이다. 모델마다 두 장이 붙는다. 첫째 제목은 THROUGHPUT-per-kW FRONTIER. Jalapeño를 파레토 프론티어—한 축을 올리면 다른 축이 반드시 깎이지는 않는 선—에 올려 둔다. 둘째는 PEAK AND MATCHED THROUGHPUT. 피크 mixed TPS/kW, 종단 지연, 최소 TBT, 상대의 이전 최고 TBT에서 처리량을 숫자로 적는다.
캡션은 같다. InferenceX. 명목 8k/1k. STP. 패키지 TDP. TBT는 토큰과 토큰 사이 시간이다. 토큰 지연시간. STP는 캡션이 적는 약어다. 본문이 풀이를 안 주면 이 글도 안 만든다. GPT-OSS 120B 칸의 상대는 GB200 1,200W. DeepSeek R1 670B MXFP4와 Kimi K2.5 1T MXFP4의 상대는 GB300 1,400W. Jalapeño는 세 칸 모두 700W다.
부록이 적는 숫자는 이것이다.
- GPT-OSS 120B. 피크 mixed TPS/kW 85,448 대 44,960(≈1.9×). 종단 지연 1.03초 대 1.80초(≈1.7×). 최소 TBT 0.69ms 대 1.87ms(≈2.7×, 1,459 대 535 tok/s/user). 상대의 이전 TBT에서 처리량 22,935 대 427 mixed/kW(≈53.7×, 535.28 tok/s/user).
- DeepSeek R1 670B. 피크 19,641 대 11,781(≈1.7×). 종단 지연 1.65초 대 5.99초(≈3.6×). 최소 TBT 1.43ms 대 5.90ms(≈4.1×, 700 대 169 tok/s/user). 이전 TBT에서 12,258 대 118(≈104.3×, 169.41 tok/s/user).
- Kimi K2.5 1T. 피크 18,195 대 11,862(≈1.5×). 종단 지연 1.56초 대 5.31초(≈3.4×). 최소 TBT 1.44ms 대 5.48ms(≈3.8×, 694 대 182 tok/s/user). 이전 TBT에서 6,744 대 120(≈56.1×, 182.46 tok/s/user).
53.7×와 104.3×를 전체 성능으로 읽으면 글이 틀린다. 그 칸은 “상대가 이전에 최고로 찍은 TBT에서, 처리량이 얼마나 남느냐”다. 헤드라인의 1.5–1.9×가 피크다. 큰 배율은 맞춘 지점의 배율이다. 본문도 Kimi를 가장 큰 공개 모델로 적고, 피크 와트당 약 1.5배·종단 지연 3.4배를 그 칸의 요약으로 고른다. 내부 프론티어 OpenAI 모델에서는 격차가 더 벌어졌다고 적는다. 그 내부 숫자는 안 준다.
한 칩이 두 병목을 같이 맡는다
언어 모델 추론은 단계가 갈린다. 프롬프트를 읽는 prefill은 연산이 병목이다. 토큰을 한 알씩 뽑는 decode는 메모리 대역이 병목이다. 코어와 칩 사이로 상태가 움직이면 통신 지연이 생기고, 기다리는 연산 유닛이 논다. 한쪽 단계에 강한 시스템이 다른 단계에서 그 이득을 잃는 이유라고 공식은 적는다. Jalapeño는 데이터 이동을 줄이도록 설계했다. KV 캐시 같은 모델 상태를 로컬에 두고, 단계마다 연산·메모리·네트워크 조합을 켠다. 네트워크를 구조의 일부로 둔다. 큰 도메인 안에서 요청 전체가 한 연결 시스템에 머물게 한다. prefill과 decode를 한 칩이 같이 잘하고, 둘의 비중이 바뀌어도 적응하는 가속기라고 적는다. 에이전트 워크로드의 정의에 가깝다고 한다.
AI가 칩을 설계하는 데 쓰였고, 칩은 AI가 프로그래밍하기 쉽게 생겼다고 한다. 초기 설계에서 테이프아웃까지 아홉 달. 산술 회로 최적화에도 AI가 들어갔다. Codex와 GPT-Astra로, 원래 생산 계획에 없던 오픈 웨이트 모델 세 개를 두 달 안에 고성능으로 올렸다. 고른 GPT-OSS 어텐션·전문가 혼합 블록에서 AI가 짠 구현이 사람 전문가가 짠 구현보다 1.5–1.8배 빨랐다. 그 숫자는 고른 블록이지 모델 전체가 아니라고 본문이 못 박는다.
| 칸 | Jalapeño가 숫자로 앉힌 것 | 아직 파트너 실리콘인 것 |
|---|---|---|
| 역할 | 추론 전용 1세대 자체 설계 칩. 학습 칩이 아니다 | 학습은 파트너. 추론도 NVIDIA 등 가속기를 계속 쓴다고 공식은 적는다 |
| 벤치 | InferenceX. GPT-OSS 120B, DeepSeek R1 670B, Kimi K2.5 1T. STP, 명목 8k/1k | 비교 시스템은 차트 라벨이 GB200·GB300. 공식 본문은 “선도 상용 AI 시스템” |
| 피크 처리량/kW | 85,448 대 44,960(≈1.9×) / 19,641 대 11,781(≈1.7×) / 18,195 대 11,862(≈1.5×) | 정규화 분모는 패키지 TDP. 상대는 1,200W·1,400W |
| 종단 지연 | 1.03초 대 1.80초 / 1.65초 대 5.99초 / 1.56초 대 5.31초 (≈1.7–3.6× 낮음) | 같은 상대 시스템의 측정. 독립 재현 숫자는 이 글에 없다 |
| 전력 | 정격 700W. 시험 워크로드 실측 지속 ≤550W | GB200 1,200W, GB300 1,400W 패키지 TDP |
| 배포 | 올해 말 자사 컴퓨트 인프라 투입 계획. Gen 2는 개발이 깊고, Gen 3는 형태를 잡는 중 | Microsoft, NVIDIA, AWS, AMD, Broadcom, Cerebras, CoreWeave, Oracle, SB Energy, SoftBank 포트폴리오 |
| 안 준 것 | 8월 25일 글에 TFLOPS, 공정 노드, HBM 용량·세대는 없다 | 빈칸은 빈칸이다. 이 글이 채우지 않는다 |
표의 빈칸은 빈칸이다. 동봉 글은 DeepSeek R1과 “Kimi K2”로 적는다. 엔지니어링 글은 Kimi K2.5 1T다. 이 글은 각 페이지가 쓴 이름을 그대로 둔다. 내부 프론티어 모델의 격차 숫자, 칩을 팔지 않고 자사 인프라에만 넣는다는 판매 정책, 2027년 양산 스케줄은 8월 25일 두 글이 안 준다. 독립 보도가 그 칸을 채우면, 출처를 달고 따로 적는다.
실사용자 반응
이 글을 확인하는 2026-08-26 오전(한국 시간) 기준, 공식 엔지니어링 글 전용 Hacker News 스레드는 있다. item 49434887. 21포인트, 댓글 0. 살아 있는 방은 그 옆이다. SemiAnalysis 뉴스레터 OpenAI Jalapeño: Better Than Nvidia Blackwell 스레드(item 49434378)가 279포인트, 댓글 192개다. 6월 공개 스레드(item 48663324, TechCrunch)는 831포인트, 댓글 468개였다. 첫 숫자의 무게는 공식 글이 아니라 SemiAnalysis 방에 쌓여 있다.
OfficeChai가 옮긴 SemiAnalysis의 골격은 이렇다. 엔지니어가 OpenAI 랩에 가서 InferenceX를 직접 돌렸다. Jalapeño를 OpenAI 모델 전용 콘솔이 아니라 일반 추론 칩으로 읽는다. Doom을 Codex 프롬프트만으로 이식해 보여 줬다는 일화도 적는다. 저지연 DeepSeek R1에서 유저당 700토큰/초를 넘겼고, 단일 토큰 예측만으로, 추측 디코딩 없이, prefill·decode 칩을 나누지 않고 그 숫자에 닿았다고 한다. 동시에 밑줄이 있다. 원 숫자는 OpenAI 것이다. 현장 확인은 했지만 전체 InferenceX 스위트를 독립으로 다시 돌리지는 않았다. 긴 컨텍스트·멀티턴 에이전트용 AgentX는 아직이다. Blackwell은 이미 한 세대 뒤라는 지적도 있다. 더 가까운 상대는 Rubin이고, 그 칸에서 메가와트당 처리량은 Vera Rubin의 7월 공개 숫자를 앞섰지만 총소유비용 기준 토큰당 비용은 비슷하다고 전한다. SemiAnalysis 원문은 유료 벽 뒤에 있다. 이 글은 그 원문을 열어 재확인하지 못한 칸을 단정으로 쓰지 않는다.
공개 댓글은 그 유보를 바로 받는다. bjourne는 SemiAnalysis가 추측 디코딩의 3–5배 이득을 너무 쉽게 적었다고 본다. 워크로드에 따라 5배가 되기도, 2배 느려지기도 하며 디코드 루프가 훨씬 복잡해진다고 적는다. empath75는 추론의 상품화가 모두가 프론티어를 같은 값에 돌리는 미래가 아니라 석유에 가깝다고 본다. 이 정도 진전이 그 이유라는 문장이다. 규모를 가진 랩만 에너지 가격 근처까지 내릴 수 있다는 읽기다. LarsDu88은 Tesla가 자체 추론 칩을 짓다 전용 칩 회사의 순환을 따라가지 못해 접은 일을 꺼낸다. Cerebras와 NVIDIA 앞에 OpenAI가 같은 함정에 빠질 수 있다고 적는다. 이 글이 그 비유에 점수를 보태지 않는다. 방이 남긴 문장이다.
독립 보도의 결도 같다. Techerati는 숫자를 그대로 옮긴 뒤, 배포 전의 벤더 보고라고 못 박는다. Tom’s Hardware 제목은 700W Jalapeño ASIC이 1,400W NVIDIA 플래그십을 앞선다고 달고, 본문 인용은 Vera Rubin—OpenAI가 2026년 하반기에 배치하기로 한 NVIDIA 쪽 기가와트—과는 비교하지 않았다고 적는다. The Register 링크도 HN에 올라 있다. 3포인트. 공식 글 전용 방은 아직 말이 없다. 말이 있는 방은 SemiAnalysis와 그 유보다.
의미와 시사점
오늘 글이 새로 깐 칸은 가격표가 아니다. 1자 실리콘이 공개 벤치에 숫자를 올렸다는 칸이다. 6월에는 와트당이 나을 것이라고 했다. 8월에는 1.5–1.9배와 1.7–3.6배를 적었다. 비교 축은 칩당이 아니라 킬로와트당이다. 정격 700W, 실측 550W 이하. 상대 차트의 TDP는 1,200W와 1,400W다. 와트당으로 나눈 이유가 그 문장이다.
실무자가 가져갈 경계는 넷이다. 첫째, 53×와 104×를 헤드라인으로 쓰지 않는다. 맞춘 TBT 지점의 처리량이다. 피크는 1.5–1.9배다. 둘째, GB200·GB300 라벨을 NVIDIA 퇴출로 읽지 않는다. 공식은 파트너 가속기를 학습과 추론 모두 계속 쓰겠다고 적는다. Friar 글의 포트폴리오는 더 길다. 셋째, 벤치를 일반화 증명으로 읽되, AgentX와 Rubin 칸은 아직 비어 있다고 본다. SemiAnalysis가 직접 그 빈칸을 적는다. 넷째, AI가 칩을 설계·프로그래밍했다는 문장을 모델 전체 1.5–1.8배로 접지 않는다. 고른 블록의 숫자다. 본문이 그 한계를 먼저 단다.
남는 질문은 배포 속도다. 공식은 연말 자사 인프라 투입을 계획한다. Gen 2는 이미 깊고 Gen 3는 형태를 잡는다. 양산 규모와 외부 판매 여부는 8월 25일 두 글이 안 준다. 칩이 답을 싸게 만드는 일과, 그 칩이 랙에 앉아 청구서를 바꾸는 일은 같은 문장이 아니다. 오늘 앉은 것은 첫 문장이다.
마치며
OpenAI는 8월 25일 Jalapeño의 첫 측정치를 공개했다. InferenceX에서 GPT-OSS 120B의 피크 mixed TPS/kW는 85,448 대 44,960이다. DeepSeek R1은 19,641 대 11,781, Kimi K2.5는 18,195 대 11,862다. 종단 지연은 각각 1.03초, 1.65초, 1.56초. 정격 700와트, 실측 지속 550와트 이하. 연말 자사 인프라에 넣겠다고 한다. NVIDIA와 다른 파트너는 그대로 쓴다.
남의 칩만 쓰던 집이 아니다. 남의 칩을 버리겠다는 집도 아니다. 공개 벤치에 숫자가 붙은 1자 실리콘이, 파트너 가속기 옆에 앉았다. 확인할 다음 칸은 헤드라인 배율이 아니다. 연말에 실제로 랙에 들어가는지, AgentX와 Rubin 칸이 채워지는지, 와트당이 토큰당 청구서로 옮기는지다.
출처
- OpenAI 엔지니어링 글 (2026-08-25): Jalapeño’s first results show industry-leading speed and efficiency in AI inference
- OpenAI 회사 글, Sarah Friar (2026-08-25): The full stack behind abundant intelligence
- OpenAI·Broadcom 6월 공개: OpenAI and Broadcom unveil LLM-optimized inference chip
- SemiAnalysis: OpenAI Jalapeño: Better Than Nvidia Blackwell
- Techerati, Rebecca Uffindell: OpenAI says Jalapeño delivers up to 1.9x more AI work per watt
- OfficeChai: OpenAI's New Jalapeno Chip Beats NVIDIA's Blackwell On Some Parameters, Company Says
- Tom’s Hardware: OpenAI’s 700W Jalapeño ASIC outpaces 1,400W Nvidia flagship GPU
- Hacker News 공식 글: item 49434887 · SemiAnalysis 스레드: item 49434378
이 글은 AI가 작성하여 자동 발행된 콘텐츠입니다.