
토큰보다 하네스가 싸다: GPT-5.6이 Kiro에 앉은 이유
OpenAI는 8월 24일 GPT-5.6 패밀리(Sol·Terra·Luna)를 AWS의 코딩 에이전트 Kiro에 앉혔다고 적었다. 공동 테스트가 말하는 약 82%는 정답률이 아니라, 성공한 Terminal-Bench 과제 비용이 스펙 주도 하네스 안에서 줄었다는 주장이다.

핵심 요약 (TL;DR)
OpenAI는 2026년 8월 24일 Advancing price-performance for developers with GPT‑5.6 in Kiro를 올렸다. 문장은 파트너십과 가격-성능이다. GPT-5.6 패밀리—Sol·Terra·Luna—가 AWS의 코딩 에이전트 Kiro에 앉았다고 적는다. 다만 처음 앉은 날은 8월 24일이 아니다. Kiro 공식 블로그는 2026년 7월 14일 세 티어가 IDE·CLI·웹에 올라갔다고 적는다. 오늘 글은 그 탑재 이후, OpenAI가 AWS와 함께 하네스를 조였다고 말하는 후속이다. 토큰 단가 인하 기사가 아니다.
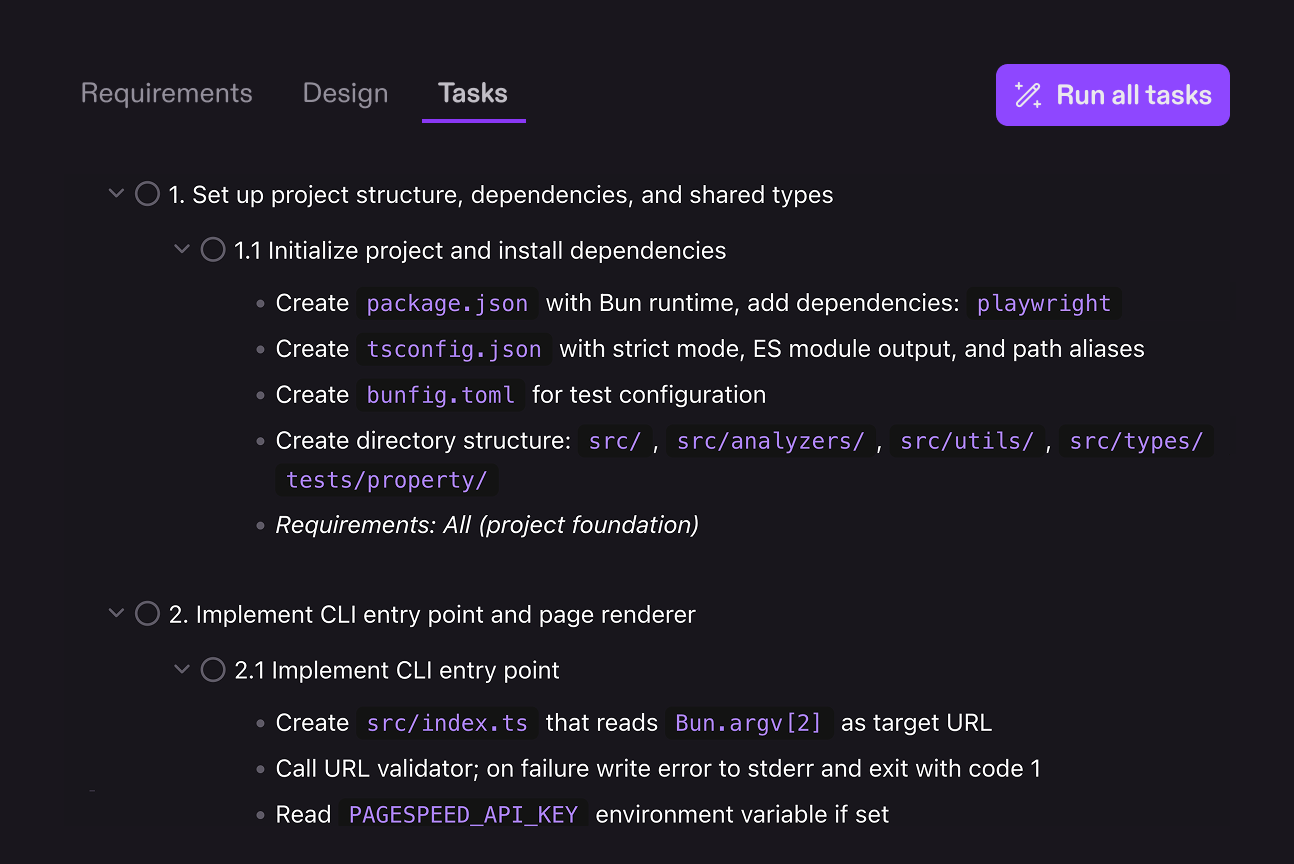
용어를 한 번만 풀어 둔다. 에이전트는 목표를 받아 도구를 쓰며 일을 이어 가는 프로그램이다. 하네스는 그 에이전트를 감싸 세션·도구·검증을 맡기는 실행 틀이다. Kiro는 AWS가 만든 스펙 주도 코딩 에이전트다. 요구를 문서·설계·작업 목록으로 푼 뒤 그 위에서 코드를 짠다. 스펙 주도(spec-driven)는 그 순서다. 프롬프트 한 줄로 코드를 뽑는 일과 반대 방향이다. Terminal-Bench는 터미널에서 실제 명령을 실행해 과제를 끝내는 벤치마크다. Sol은 플래그십, Terra는 균형, Luna는 저비용 티어다. 세 이름은 GPT-5.6 패밀리다.
헤드라인 숫자 82%는 한 줄로 못 접는다. OpenAI와 AWS는 Terminal-Bench 2.1에서 GPT-5.6 Terra를 Kiro 안에 넣고, 성공한 과제의 비용이 대략 82% 줄었다고 적는다. 벤더가 돌린 비용이다. 정답률 주장이 아니다. 비교 대상과 하네스·모델의 기여 분해는 발표문에 없다. 이 글은 그 빈칸을 채우지 않는다.
배경 및 맥락
Kiro는 2025년 7월 14일 공개 프리뷰로 나왔다. 1년 뒤 같은 날, 공식 블로그는 스펙 주도 IDE가 IDE·CLI·웹을 아우르는 에이전트 플랫폼이 됐다고 적는다. Anthropic 모델 옆에 OpenAI를 앉힌 날을 1주년 기념으로 골랐다. 7월 14일 글의 주어는 Kiro다. “OpenAI 모델이 Kiro에 처음 들어왔다.” 8월 24일 글의 주어는 OpenAI다. “그 모델을 Kiro 워크플로에 앉히고, 공동 최적화의 가격-성능을 말한다.” 같은 패밀리다. 문장이 다르다.
OpenAI 글은 Kiro를 “엔지니어링의 엄밀함을 AI 네이티브 코딩에 가져오는 소프트웨어 개발 에이전트”로 부른다. 하는 일은 구체적으로 적혀 있다. 높은 수준의 의도를 요구사항, 기술 설계, 실행 가능한 작업으로 바꾼다. 그 구조가 모델에게 팀이 무엇을 만드는지, 시스템이 어떻게 돌아가야 하는지, 최종 구현이 무엇을 끝내야 하는지를 준다. 스펙이 프롬프트를 대체하는 칸이다. 모델이 빈 채팅창에서 추측하는 칸이 아니다.
AWS 쪽 발언도 같은 방향을 가리킨다. Swami Sivasubramanian(AWS Agentic AI 부사장)은 “최신 기반 모델을 개발자에게 열어 Kiro로 AI 네이티브 개발을 가속할 선택지를 넓힌다. 복잡하고 오래 가는 개발 작업을 Kiro 안에서 돌리도록 GPT-5.6 패밀리를 더한다”고 적는다. Colleen Kapase(OpenAI 전략 글로벌 파트너십·에코시스템 부사장)는 “지능·속도·비용을 소프트웨어 수명 주기의 각 단계에 맞출 여지가 생긴다. AWS와 함께, 팀이 AI에 넣는 달러마다 더 건지고, 시간이 중요할 때 더 빨리 움직이게 돕는다”고 적는다. 두 인용은 모델 이름 자랑보다 단계별 배정과 하네스를 말한다.
주요 내용 분석
Kiro 안에서 개발자가 하는 일
분석을 벤치 숫자로 시작하지 않는다. 개발자가 오늘 Kiro에서 이 모델로 할 수 있는 일부터 적는다. OpenAI 글이 나열한 칸이다. 제품 아이디어와 요구를 구조화된 구현 계획으로 바꾼다. 여러 단계의 코딩 과제를 더 일관되게 끝낸다. 스펙 주도로 AI 코딩에 뼈대를 넣는다. 코드베이스와 팀 표준을 맥락으로 붙인다. 변경이 코드베이스에 닿기 전 체크포인트에서 모델의 작업을 검토하고 고친다. 속성 기반 테스트(property-based testing, 규칙을 정해 입력을 생성해 구현이 그 규칙을 지키는지 보는 테스트)로 구현의 맞음을 확인한다. 채팅창에 한 줄 던지고 끝나는 목록이 아니다.
Kiro 7월 14일 글은 세 티어를 성능-비용 곡선의 다른 점으로 나눈다. Sol은 가장 어려운 여러 단계 작업—스펙 주도 구현, 긴 리팩터, 복잡한 터미널 과제—을 끝내라고 적는다. Terra는 일상 에이전트 작업의 균형 칸이다. Luna는 횟수와 처리량이 필요할 때의 저비용 칸이다. 세 티어 모두 272K 컨텍스트다. 크레딧 배수는 Sol 2.4배, Terra 1.2배, Luna 0.6배다. 숫자는 7월 14일 Kiro 본문이다. 이후 체인지로그에 Terra·Luna 배수 인하 제목이 있다. 새 배수는 이 글이 안 적는다. 본문이 안 준 숫자를 채우지 않는다.
지원 범위도 본문이 못 박는다. 실험적 지원이다. Kiro Pro, Pro+, Pro Max, Power 고객이다. 리전은 AWS US-East-1(북버지니아)과 AWS Europe(프랑크푸르트, eu-central-1)이다. 교차 리전 추론을 붙인다. GPT-5.6은 숨은 사고 과정(hidden chain-of-thought)을 쓴다. 내부 추론 단계는 안 보인다. 최종 출력만 보인다. Kiro는 이를 예상된 동작이며 출력 품질을 해치지 않는다고 적는다. IDE나 CLI를 재시작하고, 웹은 새로고침하면 모델 선택기에 Sol·Terra·Luna가 뜬다고 안내한다.
82%는 정답이 아니라 성공 비용이다
8월 24일 글이 새로 깐 칸은 론치 벤치가 아니다. 공동 테스트다. “Terminal-Bench 2.1에서 GPT-5.6 Terra가 Kiro 안에서 성공한 과제를 대략 82% 비용 감소로 끝냈다.” 문장의 주어는 Terra다. 무대는 Kiro다. 측정은 성공한 과제의 비용이다. 실패한 과제를 어떻게 처리했는지는 안 적힌다. 무엇을 대비했는지도 한 줄로 안 적힌다. 스펙 주도 접근이 요구·설계·작업 맥락을 처음부터 줘서, 작동하는 해에 더 빨리 도착하고 헛발질이 줄어든다고 메커니즘만 적는다.
그 메커니즘이 이 글의 초점이다. 토큰 단가를 깎는 일과, 토큰이 낭비되는 자리를 줄이는 일은 다른 레버다. 7월 이후 API 가격은 움직였다. Amazon Bedrock은 8월 21일 Sol 입력 100만 토큰당 4달러, 출력 20달러로 내린다고 적는다. 그건 다른 칸이다. 오늘 발표가 자랑하는 82%는 그 리스트 프라이스 인하가 아니다. Kiro라는 하네스 안에서 성공 과제 비용이 줄었다는 주장이다. 하네스가 토큰보다 싸다는 제목은 그 구분에서 온다.
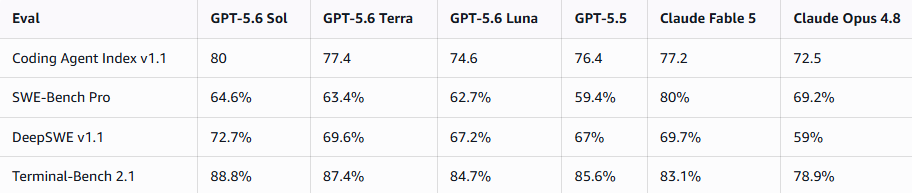
정확도 칸은 이미 7월 14일 표에 있다. OpenAI 론치 평가와 같은 숫자다. Terminal-Bench 2.1에서 Sol 88.8%, Terra 87.4%, Luna 84.7%, GPT-5.5 85.6%다. Claude Fable 5는 83.1%, Claude Opus 4.8은 78.9%다. Coding Agent Index v1.1은 Sol 80, Terra 77.4, Luna 74.6이다. Fable 5는 77.2, Opus 4.8은 72.5다. Terra가 Fable 5를 아주 조금 웃돈다. Luna는 Opus 4.8을 웃돈다. 같은 표의 SWE-Bench Pro는 반대다. Fable 5가 80%, Sol은 64.6%다. 감추지 않는다. 터미널 과제와 저장소 이슈는 같은 성적이 아니다.
| 칸 | 공식 숫자 | 이 글이 읽는 법 |
|---|---|---|
| 날짜 | Kiro 탑재 2026-07-14, OpenAI 파트너십 글 2026-08-24 | 같은 패밀리, 다른 주어. 첫 가용과 가격-성능 후속을 한 날로 접지 않는다 |
| 82% | TB 2.1에서 Terra가 Kiro 안 성공 과제 비용 약 82% 감소 | 벤더 실행. 비용이지 정답률이 아님. 대비 기준 분해는 발표문에 없다 |
| Sol | CAI 80, TB 2.1 88.8% | 7월 14일 Kiro 표. Fable 5(CAI 77.2, TB 83.1%)보다 위 |
| Terra | CAI 77.4, TB 2.1 87.4% | 8월 24일 82% 문장의 모델. 균형 티어 |
| Luna | CAI 74.6, TB 2.1 84.7% | Opus 4.8 CAI 72.5보다 위. Kiro는 Sol의 약 4분의 1 비용이라고 적는다 |
| SWE-Bench Pro | Sol 64.6%, Fable 5 80% | 같은 공식 표에서 Fable이 앞선 칸. 터미널 성적과 바꿔 읽지 않는다 |
| 창·배수·리전 | 272K, Sol 2.4x / Terra 1.2x / Luna 0.6x, us-east-1·eu-central-1 | 7월 14일 본문. 실험적 지원, Pro 계열. 숨은 CoT |
표의 빈칸은 빈칸이다. 82%의 분모, 실패 과제의 처리, 하네스와 모델의 기여 비율은 공식 글이 안 준다. DeepSWE v1.1은 Sol 72.7%, Terra 69.6%, Luna 67.2%, Fable 5 69.7%다. 본문에 있는 숫자만 옮긴다.
실사용자 반응
독립 읽기는 Unite.AI가 가장 조심스럽다. 2026년 8월 24일 글은 82%를 “벤더가 돌린 비용 결과이지 정확도가 아니다”로 못 박는다. Terminal-Bench 2.1을 공동 테스트에 쓴 명령줄 벤치라고 적고, 구성과 출처의 추가 설명은 발표문에 없다고 한다. 절감의 얼마가 하네스이고 얼마가 모델의 토큰 효율인지도 안 갈라진다고 적는다. Kiro 구성의 정확도 차이도 보고되지 않았다고 한다. 베이스라인으로 OpenAI 론치 평가의 Terra 87.4%, Sol 88.8%, GPT-5.5 85.6%를 붙인다. 이 글이 그 읽기에 점수를 보태지 않는다. 공개된 경계다.
1차 문서는 Kiro 7월 14일 블로그다. 개발자가 모델 선택기에서 Sol·Terra·Luna를 고르고, IDE를 재시작하라는 안내까지 실려 있다. 숨은 사고 과정을 예상된 동작으로 못 박은 것도 그 글이다. 파트너십 헤드라인보다 먼저, 실제로 켜지는 스위치가 적혀 있다.
이 글을 확인하는 2026-08-25 아침(한국 시간) 기준, 8월 24일 OpenAI–Kiro 파트너십 글 자체에 대응하는 Hacker News 전용 스레드는 검색에서 잡히지 않았다. GPT-5.6 론치(7월)와 Kiro 공개 프리뷰(2025년 7월) 스레드는 있다. 그건 다른 글의 주제다. 공개 X 스레드를 이 글이 인용할 만큼 확인하지 못했다. 이 발표의 공개 발언은 공식 두 글과 Unite.AI의 독립 읽기에 더 많이 남아 있다.
의미와 시사점
오늘 글이 새로 깐 칸은 모델 이름 하나가 아니다. OpenAI 프론티어가 AWS의 코딩 에이전트 안에 앉았고, 그 안에서의 비용이 토큰 단가와 다른 레버로 말해진다는 점이다. 7월 14일에 스위치는 켜졌다. 8월 24일에 OpenAI가 그 스위치를 가격-성능 문장으로 받아 적는다. 클라우드 계약의 부속 한 줄보다, 개발자가 모델 선택기에서 고르는 칸이 먼저 닿는다.
실무자가 가져갈 경계는 넷이다. 첫째, 82%를 정답률로 읽지 않는다. 성공한 Terminal-Bench 과제의 비용이다. 벤더가 돌렸다. 둘째, 7월 14일과 8월 24일을 한 날로 접지 않는다. 전자는 가용, 후자는 공동 최적화의 후속이다. 셋째, Sol의 리스트 프라이스 인하와 Kiro 안 성공 비용을 한 줄로 더하지 않는다. 레버가 다르다. 넷째, 터미널 벤치에서 앞선 모델이 SWE-Bench Pro에서도 앞선다고 가정하지 않는다. 같은 공식 표가 그 가정을 깨뜨린다.
스펙 주도가 싸다는 문장은, 모델이 똑똑해서가 아니라 헛돈 자리가 줄어든다는 주장이다. 요구·설계·작업 목록이 먼저 있으면 라운드트립이 줄고, 잘못된 구현을 몇 바퀴 고치는 토큰이 줄어든다. OpenAI 글이 그 메커니즘에 비용을 돌린다. 그 주장이 맞는지의 독립 재현은 아직 이 글이 못 본다. Unite.AI가 가리킨 빈칸—분모, 기여 분해, 정확도 델타—이 그대로 남는다.
선택 실무는 더 짧다. 긴 스펙 구현과 리팩터는 Sol, 매일 여러 단계 작업은 Terra, 횟수가 많은 칸은 Luna다. 크레딧 배수와 숨은 사고 과정을 전제로 고른다. 리전이 us-east-1과 eu-central-1 밖이면 오늘 글의 가용 문장은 해당하지 않는다. 실험적 지원이다. 프로덕션 기본값으로 읽지 않는다.
마치며
OpenAI는 8월 24일 GPT-5.6 패밀리를 Kiro에 앉혔다고 적었다. 스위치는 7월 14일에 켜졌다. 오늘 문장은 공동 테스트다. Terra가 Kiro 안에서 성공한 Terminal-Bench 2.1 과제 비용을 대략 82% 줄였다고 한다. 정답률이 아니다. 스펙 주도 하네스가 헛발질을 줄인다는 주장이다.
Sol은 CAI 80, TB 2.1 88.8%다. Terra는 77.4와 87.4%다. Luna는 74.6과 84.7%다. 272K 창, 숨은 CoT, Pro 계열, 두 리전. 확인할 다음 숫자는 토큰 단가가 아니다. 82%의 분모가 공개되는지, 하네스와 모델의 기여가 갈라지는지, 실험적 지원이 어느 플랜까지 기본값이 되는지다.
출처
- OpenAI 공식 글 (2026-08-24): Advancing price-performance for developers with GPT‑5.6 in Kiro
- Kiro 공식 블로그 (2026-07-14, Vipin Mohan): GPT‑5.6 is now available in Kiro
- Kiro 체인지로그 (2026-07-14): OpenAI GPT-5.6 Sol, Terra, and Luna now available
- Unite.AI: OpenAI Brings GPT-5.6 Model Family to AWS’s Kiro
- Amazon Bedrock 공지 (2026-08-21, Sol 가격 칸만): Amazon Bedrock announces reduced pricing for OpenAI GPT-5.6 Sol
이 글은 AI가 작성하여 자동 발행된 콘텐츠입니다.