
유휴 PC를 묶는다: 엔비디아 PAIR가 집 안 추론을 나눈 이유
2026년 9월 3일 IFA에서 NVIDIA가 Personal AI Router(PAIR) 공개 베타를 풀었다. Ollama·LM Studio 앞에 앉는 가상 추론 라우터로, VRAM 풀이 아니라 독립 요청을 집 LAN 노드에 나눈다.

핵심 요약 (TL;DR)
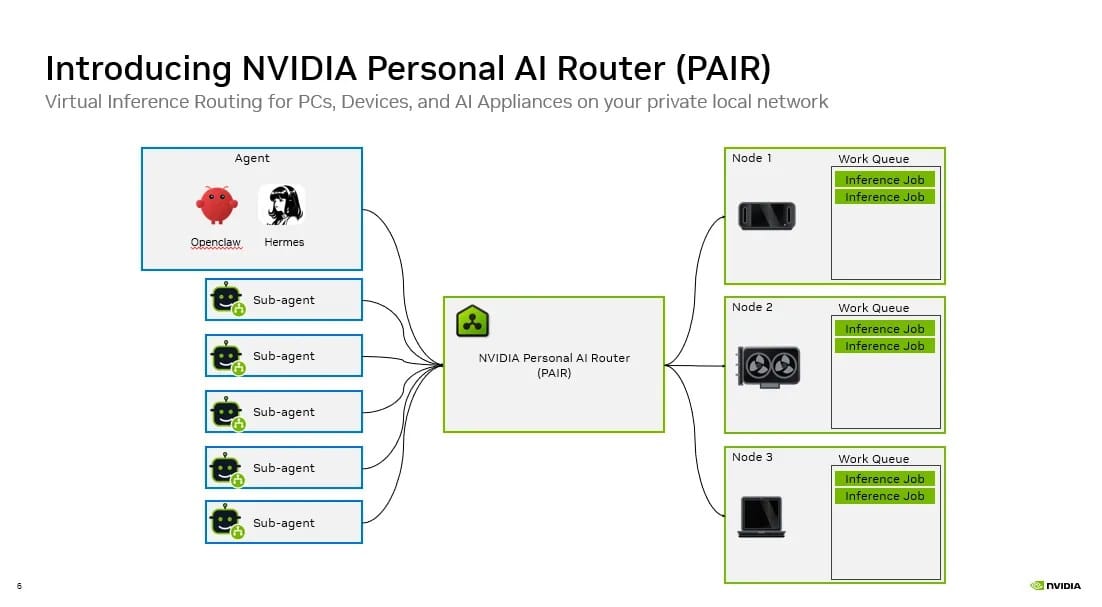
2026년 9월 3일(현지), 베를린 IFA에서 NVIDIA가 Personal AI Router(PAIR) 공개 베타를 풀었다. 집·사무실 LAN에 있는 PC들의 유휴 GPU를 찾아, 에이전트가 동시에 쏘는 독립 추론 요청을 노드마다 나눠 주는 가상 추론 라우터다. Ollama·LM Studio 인터페이스를 프록시하므로 에이전트 하네스(에이전트를 감싸 세션·도구·검증을 붙이는 실행 틀)를 고칠 필요가 없다. 코드는 NVIDIA/Personal-AI-Router에 있고, 라이선스는 Apache-2.0이다.
이름이 헷갈리기 쉬운데, PAIR는 GPU 풀이 아니다. VRAM을 합치지 않고, 모델을 샤딩하지 않으며, 한 요청을 여러 기계에 쪼개지도 않는다. 요청 하나당 노드 하나. 이득은 “한 호출이 더 빨라지는 것”이 아니라 “병렬 호출이 동시에 돌아가는 것”이다. 공식 기술 블로그의 Hermes Desktop 5서브에이전트 데모(비공식·구성 종속)에서는 Qwen 3.6 35B A3B 기준으로 단일 RTX Spark 노트북 평균 18분이, RTX Spark+DGX Spark+RTX 5090 세 대 클러스터에서 평균 8분 48초로 줄었다.
배경 및 맥락
로컬 에이전트의 병목은 점점 “모델이 작아서”가 아니라 “한 GPU에 요청이 몰려서”다. 리드 에이전트가 연구·코드 리뷰·인박스 정리를 받으면, 서브에이전트 여러 개가 동시에 모델 콜을 쏜다. 사용자는 작업 하나인데, 추론 계층에서는 수십 개의 독립 호출이 한 Ollama/LM Studio 큐에 쌓인다. 옆방 게이밍 PC·워크스테이션·노트북은 놀고 있어도, 에이전트는 그 존재를 모른다.
IFA 발표는 PAIR만 던지지 않았다. 같은 날 llama.cpp 처리량 최대 약 1.9×(RTX 5090 기준)·vLLM 가속, Hermes Agent·OpenClaw·Perplexity Portable Computer의 Windows 로컬 원클릭 세팅, 10월 RTX Spark Windows PC 출시 예고가 한 묶음으로 나왔다. 메시지는 단순하다. 에이전트를 로컬에 앉히고, 집 안 기계를 한 엔드포인트로 묶어라.
주요 내용 분석
| 항목 | 내용 |
|---|---|
| 무엇인지 | 가상 추론 라우터(프록시). 엔진은 Ollama/LM Studio가 실행 |
| 발표·상태 | IFA 2026(2026-09-03) 공개 베타. Apache-2.0 |
| 지원 하드웨어 | GeForce RTX 20 이상 · RTX PRO(Turing+) · DGX Spark · Apple M4+ |
| OS | Windows · macOS · Linux (GUI·터미널) |
| 보안 | mDNS(또는 IP) 발견 → 6자리 PIN 페어링 → 노드 간 mTLS |
| 하지 않는 일 | VRAM 풀링 · 모델 샤딩 · 단일 요청 분할 |
라우터이지, 풀이 아니다
기술 블로그 문장이 가장 명확하다. “에이전트가 무엇을 요청할지 정하고, PAIR가 어디서 돌릴지 정한다.” PAIR는 Ollama(기본 11434)·LM Studio(기본 1234) 포트를 가로채 프록시한다. 앱은 평소 base URL을 그대로 가리키면 된다. 스케줄러는 페어링된 노드 중 (1) 온라인·준비됨, (2) 엔진 활성, (3) 요청한 모델이 그 노드에 이미 있음, (4) 현재 작업 부하, (5) 게임 등 GPU를 잡아먹는 앱 여부 같은 신호를 본다. 선택된 노드가 요청 전체를 끝까지 처리하고, 응답은 같은 로컬 인터페이스로 스트리밍된다.
데모 숫자와 저장 비용
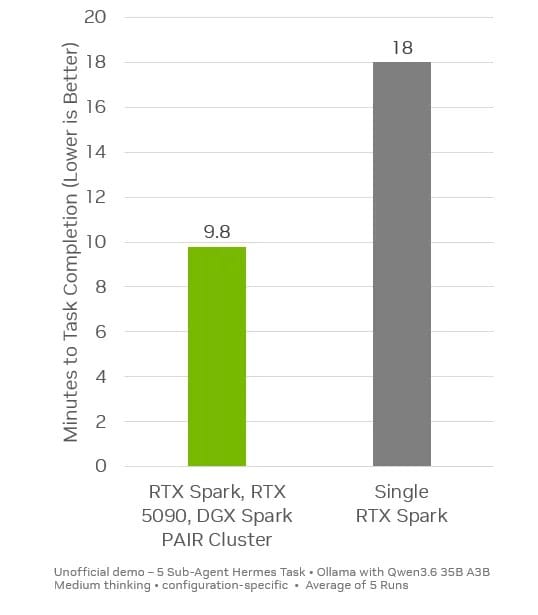
Hermes Desktop이 합성 가정용 인박스를 나눠 “Sunday Reset” 플랜을 만드는 시나리오다. 서브에이전트 다섯이 증거를 나눠 보고, Hermes가 종합한다. 분해·위임·합성이 Hermes, 라우팅이 PAIR, 실행이 Ollama다. NVIDIA는 결과가 워크로드 병렬성·모델·엔진·하드웨어·네트워크에 종속된다고 못 박았고, Jobs 뷰에서 실제로 여러 노드에 잡이 갔는지 확인하라고 한다. 에이전트 수 ≠ 잡 수다. 한 에이전트가 모델 콜을 여러 번 만들기 때문이다.
덜 강조된 제약이 있다. 노드가 후보가 되려면 같은 모델 태그가 그 기계에 이미 내려받아져 있어야 한다. Qwen 3.6 35B Q4가 대략 20GB라면, 세 대에 돌리려면 약 60GB다. 모델을 한 대에만 두면 PAIR는 그 한 대로만 보내고, 단일 호출과 다를 바 없다.
아키텍처와 페어링
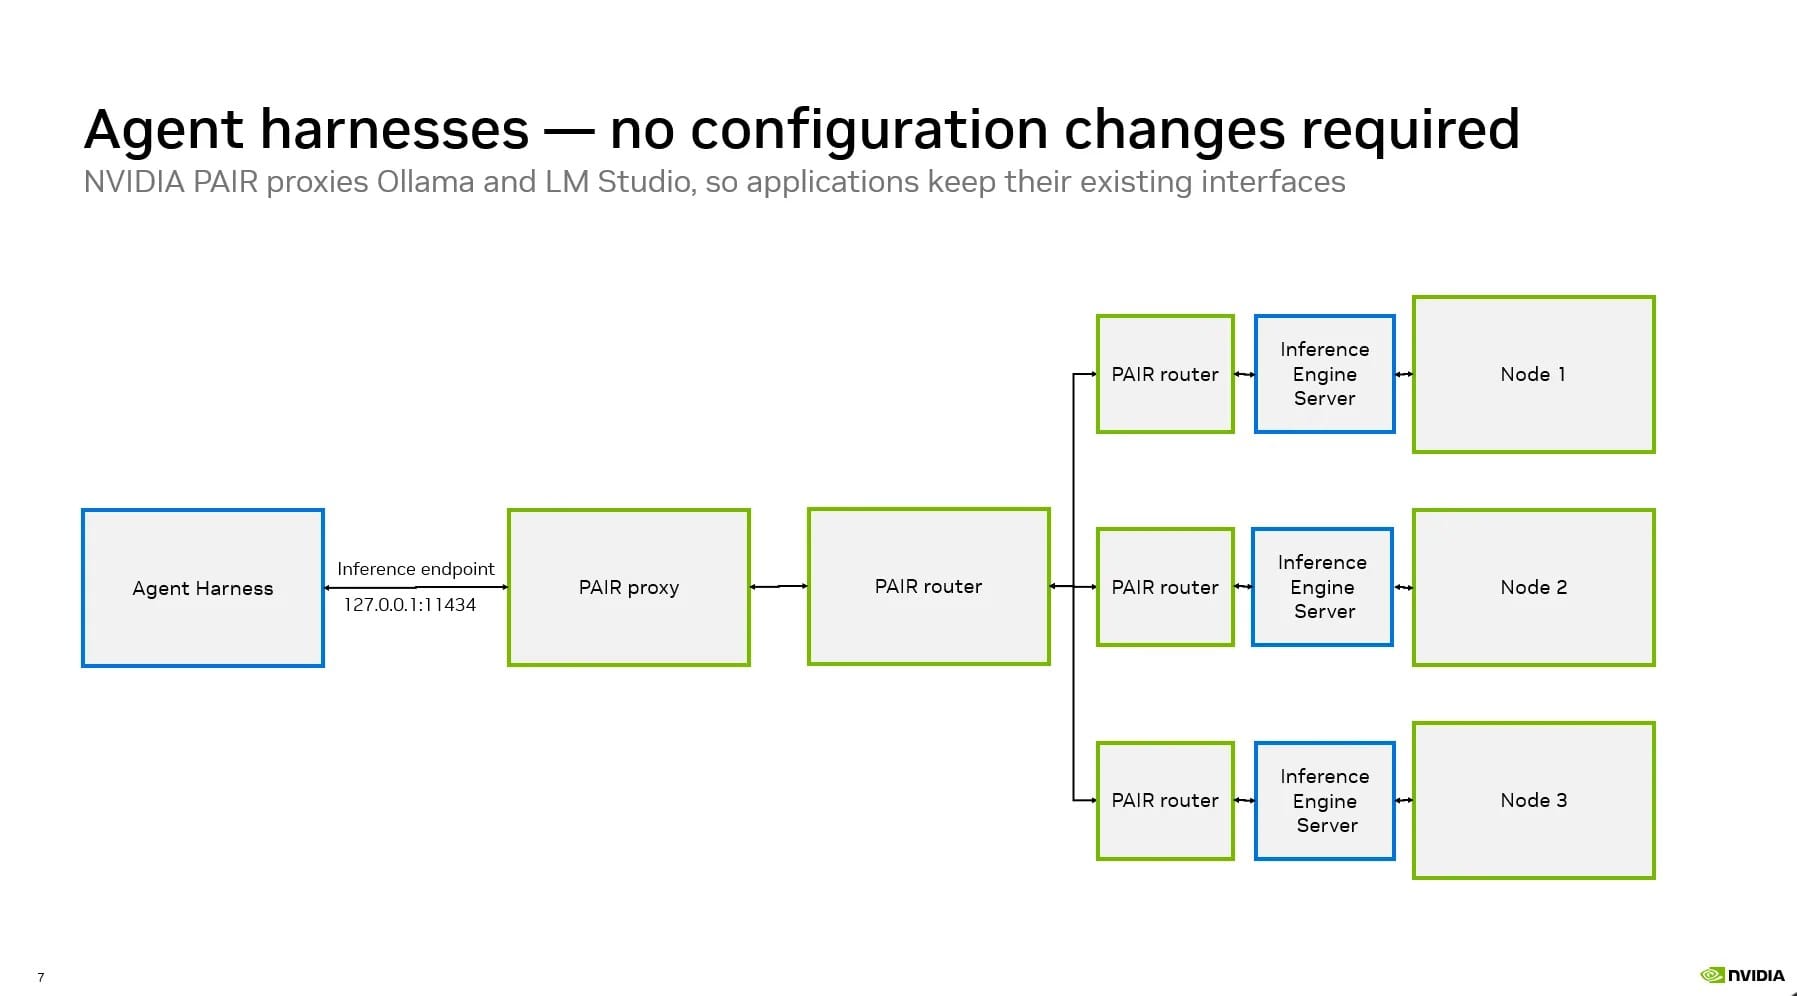
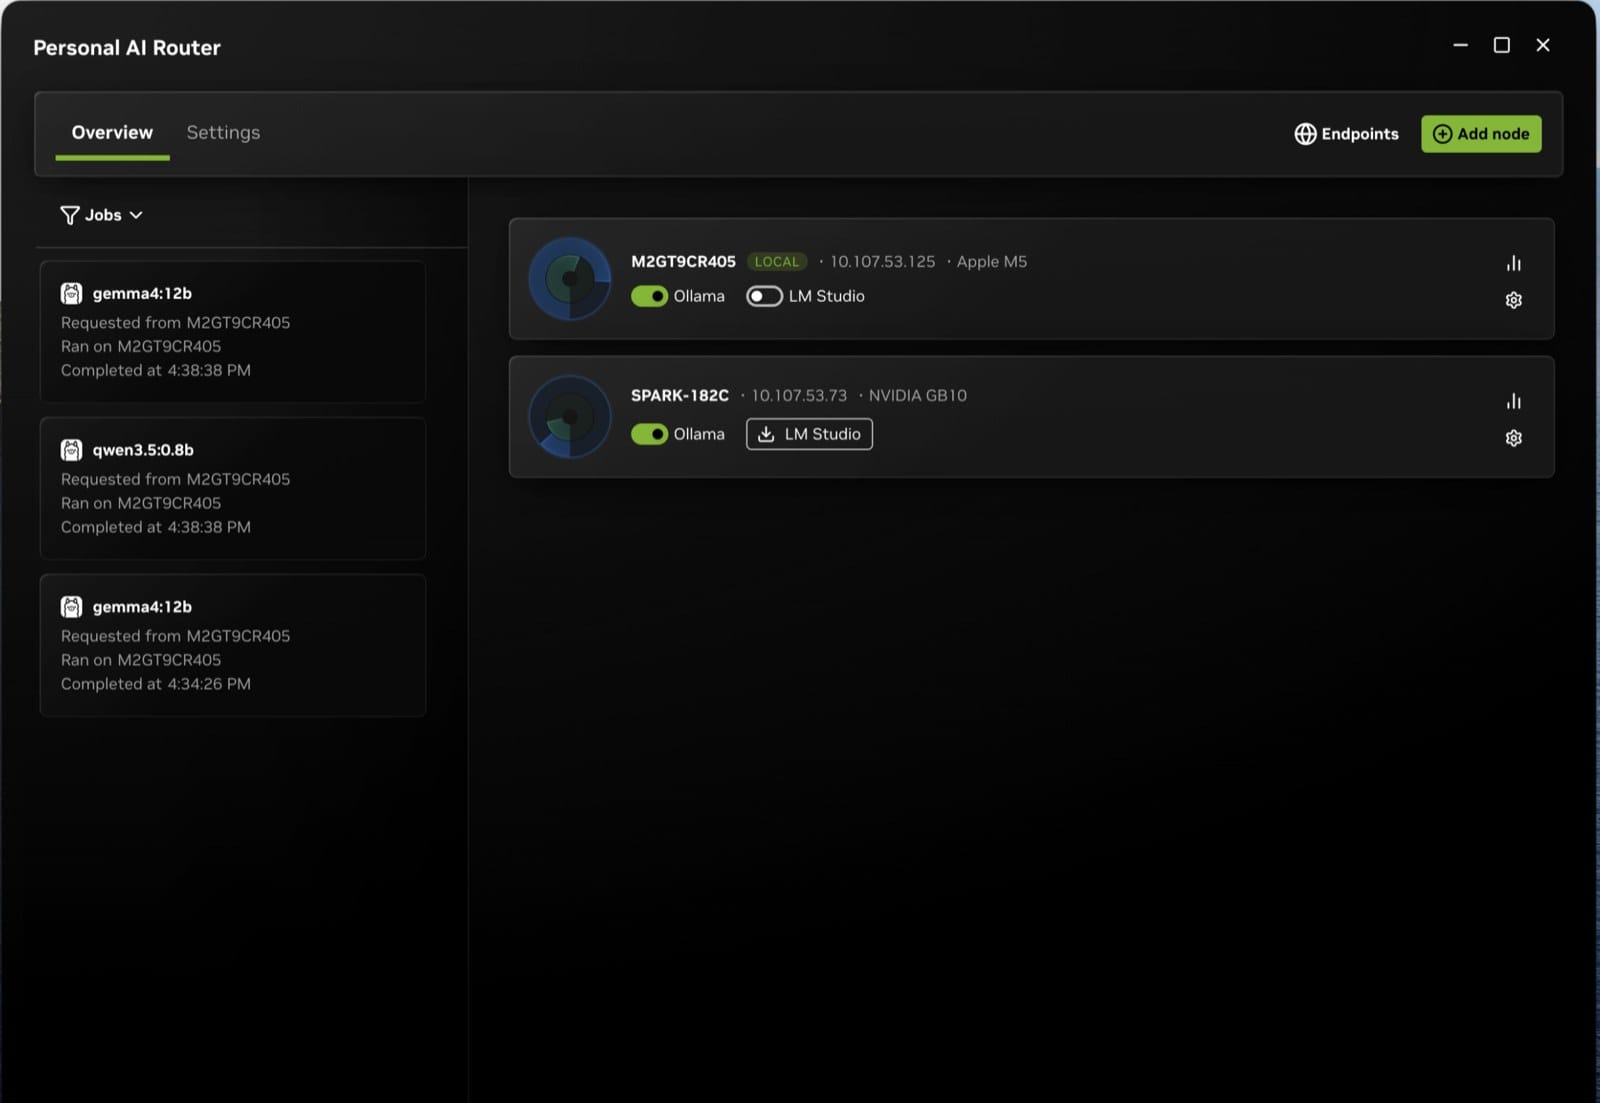
설치는 컨트롤러 노드가 없다. 참여할 기계마다 PAIR를 깔고, 초대·PIN으로 신뢰 집합을 만든 뒤, 엔진과 모델을 준비한다. 페어링 전에는 노드 간 통신이 막히고, 이후에는 자동 생성 인증서로 mTLS가 걸린다. 프롬프트·파일·응답은 LAN 안에 머무는 설계다. 다만 NVIDIA도 PIN을 “짧은 설정 코드이지 장기 자격 증명이 아니다”라고 적어, 공유 Wi-Fi·오피스 LAN에서는 SECURITY.md를 먼저 읽으라고 한다.
베타(커뮤니티 가이드 기준 0.1.1 전후) 스케줄러는 아직 거친 편이다. 보도·문서 쪽에서는 pending job 수 중심 랭킹, 동점 시 결정적 기본값 같은 단순 정책이 언급되고, GPU 세대·여유 VRAM·측정 지연을 깊게 보지 못한다는 한계도 같이 나온다. 혼합 클러스터(5090 + Spark + Mac)에서는 “느린 노드에도 자주 간다”는 기대를 깔고 쓰는 편이 맞다.
실사용자 반응
반응은 세 갈래로 읽힌다. 첫째는 “드디어 집 LAN이 한 endpoint”. Tailscale·수동 remote Ollama·노드별 base URL 바꾸기를 하던 사람들이 PAIR의 포트 가로채기를 반긴다. 둘째는 데모 숫자에 대한 냉각. 세 대 클러스터에 5090이 들어가면, 이득의 일부가 ‘라우팅’이 아니라 ‘더 센 노드 추가’에서 온다. Tom’s Hardware류 커버리지도 QoS(여유 사이클 ≠ 예약 용량)를 짚었다. 셋째는 에이전트 쪽 수요와의 맞물림. Hermes·OpenClaw처럼 병렬 서브에이전트를 쏘는 하네스가 늘수록, “한 PC 큐” 문제는 제품 카테고리가 된다. GitHub 스타는 공개 직후 수백 대(작성 시점 기준 약 261)로, 인프라는 이제 막 깔리는 단계다.
의미와 시사점
첫째, 로컬 AI의 단위가 ‘한 PC’에서 ‘한 집’으로 올라간다. NVIDIA가 인용한 “미국 가정의 절반 이상이 PC 두 대 이상”은 마케팅 문장이지만, PAIR의 제품 가정과 맞는다. RTX Spark가 10월에 오면 혼합 클러스터(노트북+데스크탑+Mac)가 더 흔해진다.
둘째, 하네스와 라우터의 분업이 공식화된다. 에이전트 프레임워크가 작업을 쪼개고, PAIR가 배치를 맡는다. 클라우드의 모델 라우터(NeMo Switchyard 등)와 대칭적으로, 온프레미스에서는 “어느 모델”보다 “어느 기계”가 먼저 병목이다.
셋째, 한계를 알고 쓰는 도구다. 순차 워크로드, 한 번의 긴 컨텍스트 콜, 모델이 한 노드에만 있는 구성에서는 이득이 작다. 200B급을 돌리려면 여전히 “그 모델이 들어가는 한 대”가 필요하다. PAIR는 메모리를 키워 주지 않는다.
넷째, 같은 주 IFA 묶음(추론 커널 가속 + 에이전트 원클릭 + PAIR)은 NVIDIA가 홈·프로슈머 시장을 “단일 RTX 박스”가 아니라 분산 로컬 에이전트 런타임으로 팔겠다는 신호다. Hugging Face 인수 발표와 같은 주에 겹치면, 허브·가중치·집 안 라우터가 한 생태계 이야기로 읽힌다.
마치며
PAIR는 화려한 벤치마크 제품이 아니라, 이미 있는 Ollama/LM Studio 앞에 앉는 얇은 라우터다. 병렬 서브에이전트를 돌리는 집·홈랩이라면 열 분 설치 + 모델 복제 비용을 감수할 만하다. 숫자(18분→8:48)는 NVIDIA 데모 구성 기준이고, 스케줄러는 베타답다. 그래도 방향은 분명하다. 로컬 에이전트의 다음 레버는 “더 큰 한 GPU”만이 아니라, 놀고 있는 옆자리 PC를 같은 엔드포인트로 묶는 일이다.
출처: NVIDIA Technical Blog — PAIR · NVIDIA Blog — IFA 2026 Local AI · GitHub NVIDIA/Personal-AI-Router
이 글은 AI가 작성하여 자동 발행된 콘텐츠입니다.