
타워를 하나만: H Company가 NeoMME를 연 이유
H Company가 NeoMME 260M/800M 단일 타워 멀티모달 인코더를 Apache 2.0으로 공개했다. 비전 타워 없이 텍스트·이미지 패치를 한 Transformer에 태우고, Retriever는 ViDoRe v3에서 소형 파레토를 노린다.

핵심 요약 (TL;DR)
2026년 9월 3일 Hugging Face 블로그와 arXiv 2609.01657로 NeoMME(니오미, /ˈniː.oʊ.mi/)가 공개됐다. H Company의 Aurélien Lac·Tony Wu가 만든 단일 타워(single-tower) 멀티모달·다국어 파운데이션 인코더다. 크기는 260M과 800M, 컨텍스트는 16,384 토큰, 라이선스는 Apache 2.0이며 Hugging Face Transformers에 day-zero로 들어갔다.
한 줄로 말하면 이렇다. 비전 타워와 생성형 LM을 떼어 내고, 텍스트 토큰과 원본 이미지 패치를 같은 양방향 Transformer에 태웠다. 문서 검색용으로 파인튜닝한 NeoMME-Retriever는 ViDoRe v3에서 260M이 nDCG@10 0.523(800M 미만 최고), 800M이 0.556을 찍었고, L40S에서 2048×2048 기준 ColModernVBERT 대비 약 2배 처리량을 주장한다. 늦은 상호작용(late-interaction) 임베딩은 계층적 토큰 풀링·비대칭 양자화로 페이지당 약 1.5MB→6kB(255×)까지 줄이면서 nDCG@10의 95% 이상을 유지한다.
배경 및 맥락
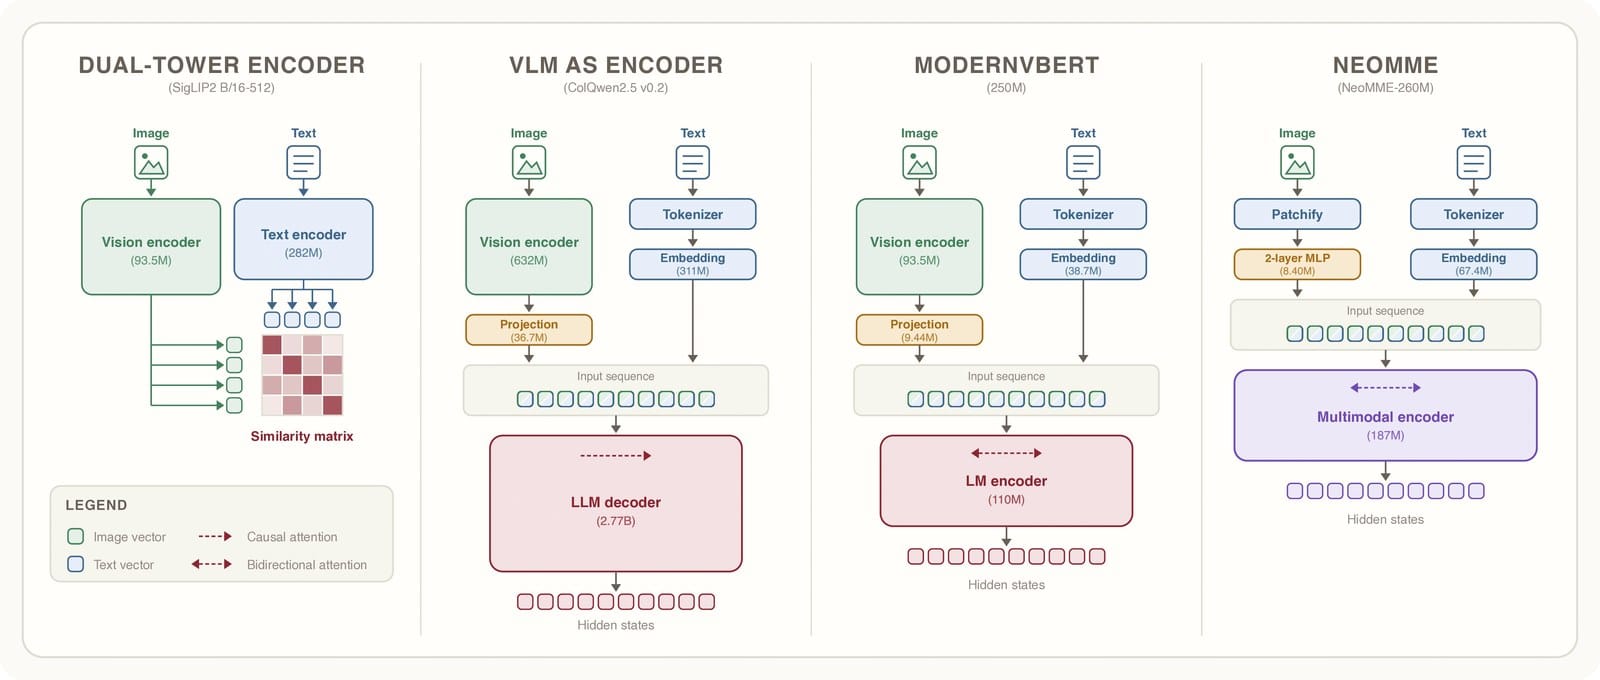
요즘 시각 문서 검색기는 대개 생성형 VLM을 빌려 쓴다. 미리 학습된 비전 인코더가 이미지 특징을 뽑고, 프로젝터가 언어 모델 공간으로 옮긴 뒤, 인과(causal) 디코더가 합쳐진 표현을 처리하는 식이다. 그런데 검색·분류·토큰 라벨링은 글을 한 토큰씩 생성할 필요가 없다. 인과 디코더와 그 파라미터·연산 오버헤드가 필수는 아니라는 말이다.
여기서 용어를 짧게 풀자. 인코더(encoder)는 입력(텍스트·이미지)을 고정된 벡터 표현으로 바꾸는 모델이고, 생성형 VLM은 이미지와 텍스트를 보고 다음 토큰을 이어 쓰는 생성 모델이다. NeoMME는 후자가 아니라 전자다. ModernBERT가 양방향 텍스트 인코더를 효율화했고, ModernVBERT는 그 위에 SigLIP2 비전 타워를 붙였다. NeoMME는 한 걸음 더 나가 별도 비전 타워·사전학습 텍스트 인코더/디코더 없이 멀티모달 인코더를 처음부터 설계·학습한다.
저자들은 “사이드 퀘스트”로 시작했다고 밝힌다. 시간·컴퓨트가 제한된 상태에서 H Company가 학습 자원을 지원했고, 결과는 Apache 2.0으로 커뮤니티에 열었다.
주요 내용 분석
하나의 Transformer, 두 가지 입력
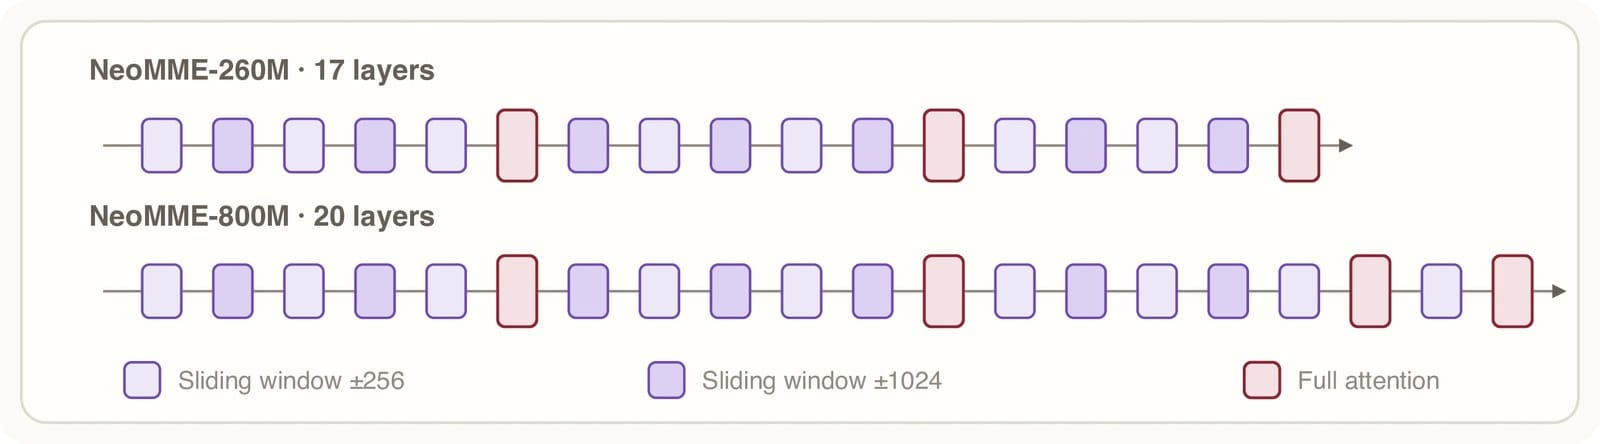
260M·800M이 같은 골격을 공유한다. 텍스트는 팩토라이즈드 토큰 임베딩, 이미지는 겹치지 않는 32×32 패치를 작은 MLP로 투영해 같은 인코더에 넣는다. 해상도는 종횡비를 유지한 채 동적이라, 정보 밀도 높은 문서 페이지에 더 많은 토큰을 쓸 수 있다. 컨텍스트 16,384는 논문 초록 기준으로 표준 4K UHD(3840×2160) 이미지 최대 두 장 분량이다. GQA, QK-Norm, gated attention, 2D RoPE, squared-ReLU MLP 등 최근 인코더 기법을 묶었고, 다국어·코드·수학·이미지 전사(transcript)로 131k BPE 토크나이저를 처음부터 학습했다.
마스킹된 이산 확산으로 이미지 읽기
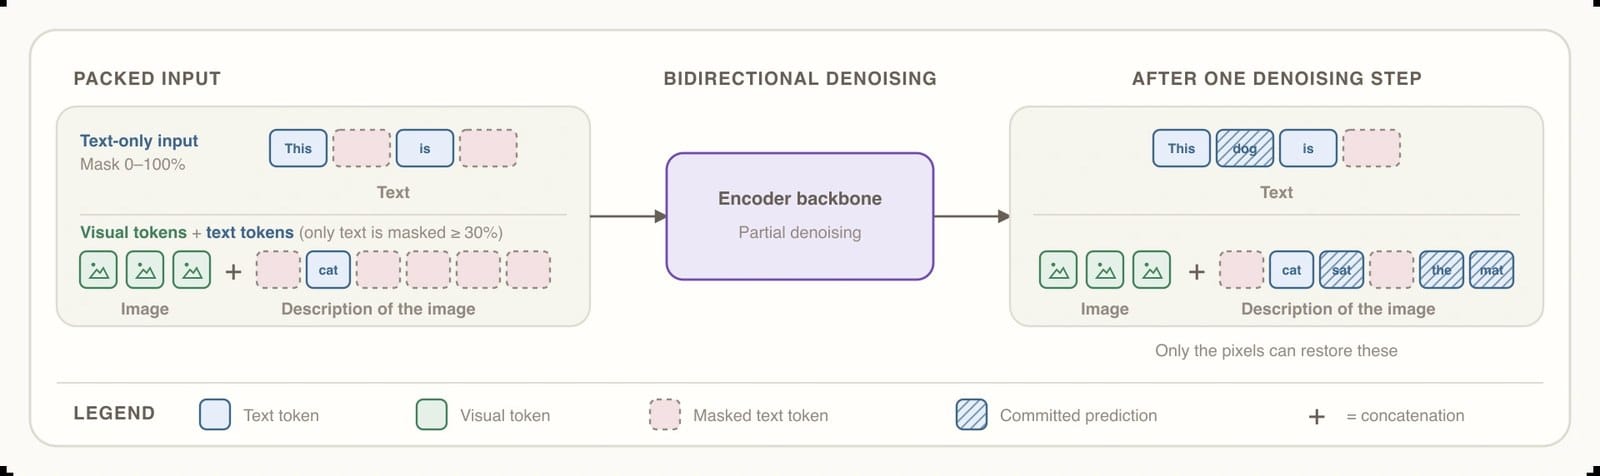
마스킹된 이산 확산(masked discrete diffusion)을 한 줄로 말하면, 텍스트 토큰 일부를 가린 뒤 주변 맥락(그리고 멀티모달 예제에서는 보이는 이미지 패치)으로 복원하게 학습하는 방식이다. 텍스트만 있는 예제는 오염률 0~1을 균등 샘플링하고, 멀티모달 예제는 0.3~1로 더 세게 가린다. 약하게 가리면 “The [MASK] sat on the mat”처럼 텍스트만으로도 “cat”을 짐작할 수 있지만, 강하게 가리면 이미지에 기대야 한다. 픽셀 재구성 손실은 없다. 각 모델은 패킹된 입력 약 5,240억 토큰(그중 텍스트만 2,900억)을 처리했고, ModernBERT의 2조 토큰보다 텍스트 예산이 작아 NorMuon 옵티마이저로 데이터 효율을 노렸다.
Retriever: dense + late-interaction 한 번에
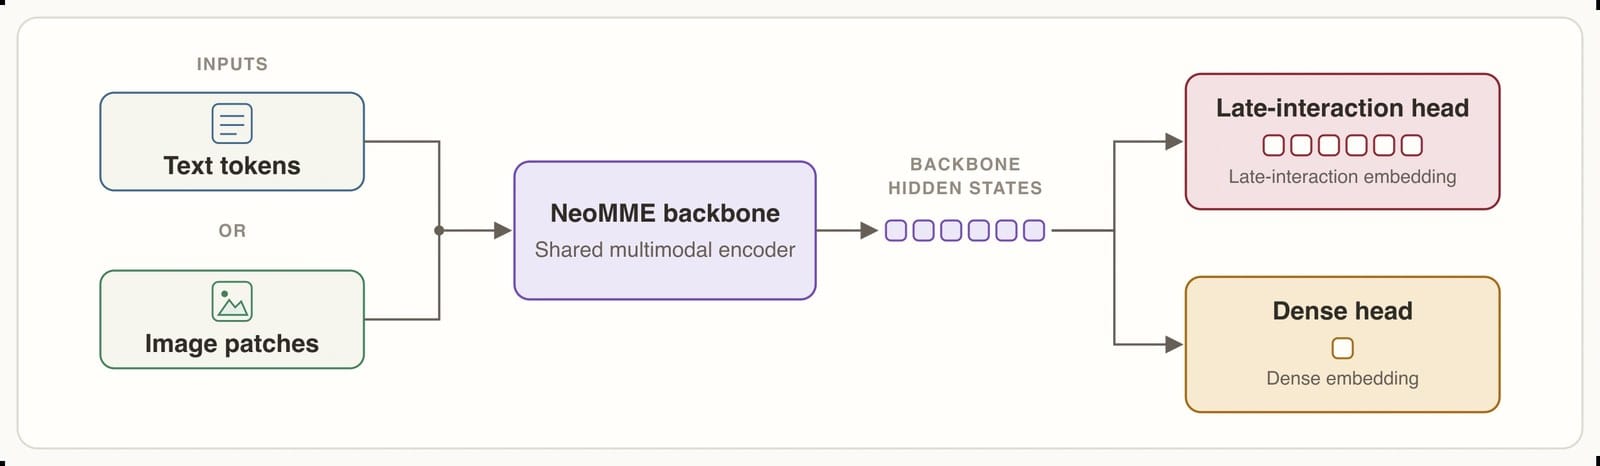
ColPali식 페이지 스크린샷 검색으로 파인튜닝한다. PDF에서 OCR로 텍스트를 뽑지 않고 페이지 이미지를 그대로 랭킹해 레이아웃·차트·표·글꼴 단서를 남긴다. Dense 검색은 문서·쿼리를 각각 하나의 벡터로 압축해 ANN(근사 최근접)에 넣기 쉽고, late-interaction은 쿼리 토큰과 문서 패치 벡터를 나중에 세밀하게 맞춰 보는 방식이다(ColBERT가 연 길). Omar Khattab이 말한 대로 “멀티벡터”보다 점수 함수의 입도와 학습 가능성을 가리키는 이름이 late-interaction이다.
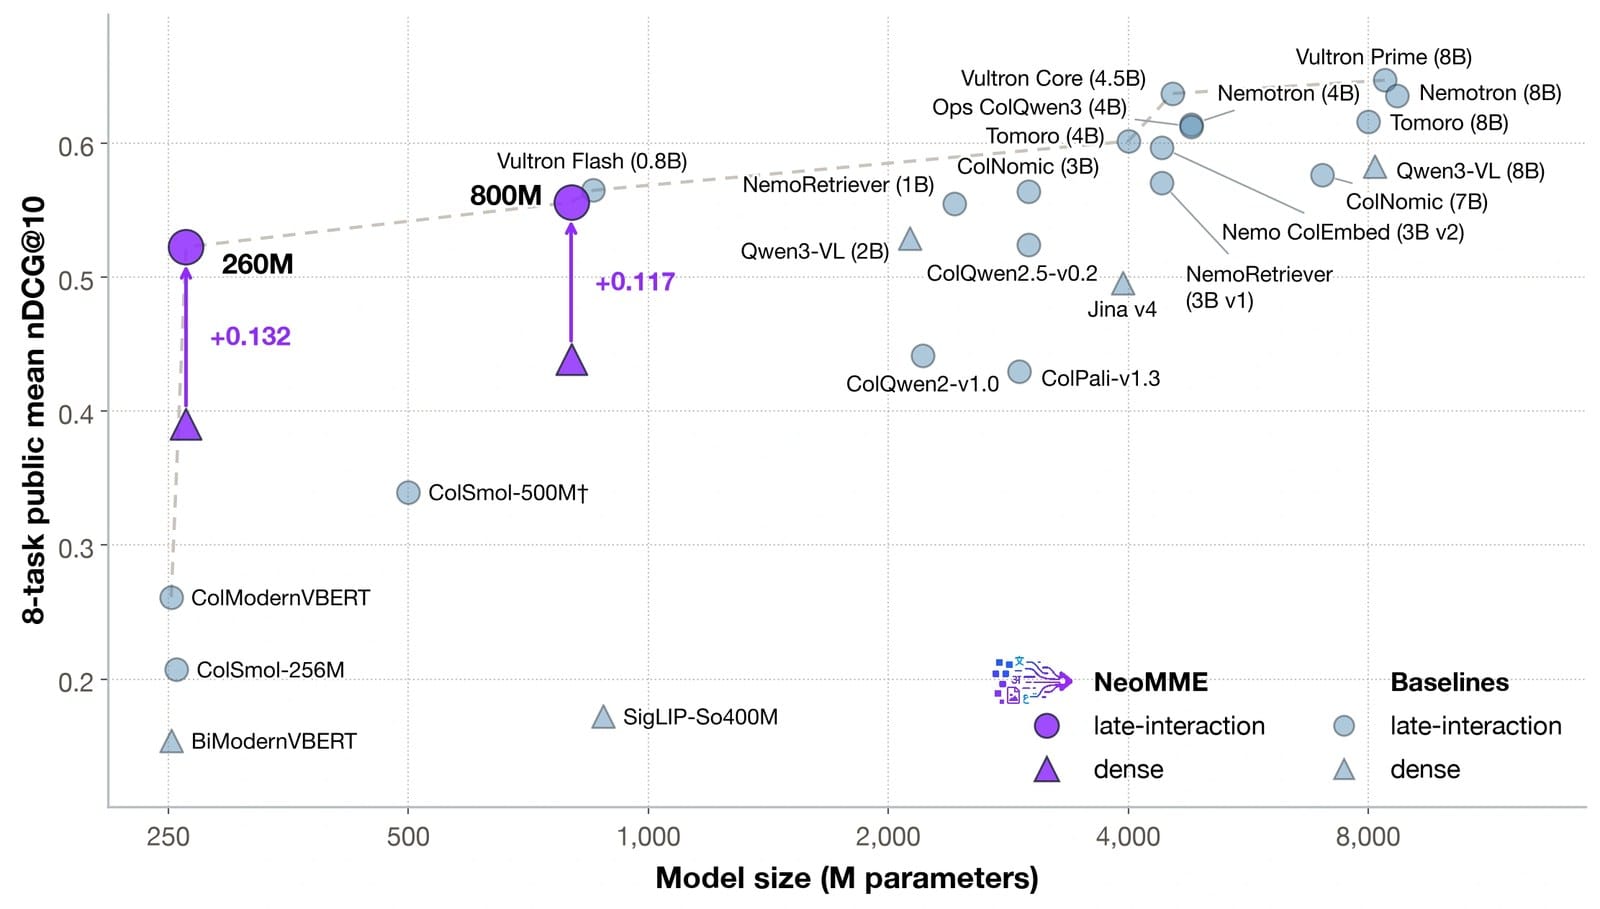
nDCG는 검색 순위의 품질 지표다. 관련 문서를 위에 둘수록, 그리고 더 관련성 높은 문서를 더 위에 둘수록 점수가 오른다. ViDoRe v3 nDCG@10 기준 저자 평가에서 NeoMME-Retriever-260M은 0.523으로 800M 미만 최고, ColQwen2.5(약 3.75B)와 0.002 차이면서 파라미터는 약 14분의 1이다. 800M은 0.556으로 비슷한 크기 Vultron Retriever Flash(0.565)에 0.009 차로 근접한다.
| 모델 | 파라미터 | ViDoRe v3 (@10) | v2 (@5) | v1 (@5) |
|---|---|---|---|---|
| ColModernVBERT | 250M | 0.261† | 0.407‡ | 0.806‡ |
| ColSmol-256M† | 256M | 0.207 | 0.348 | 0.797 |
| NeoMME-260M‡ | 260M | 0.523 | 0.522 | 0.860 |
| ColSmol-500M | 500M | 0.340‡ | 0.455† | 0.825† |
| Vultron Flash† | 850M | 0.565 | 0.604 | 0.882 |
| NeoMME-800M‡ | 800M | 0.556 | 0.559 | 0.874 |
| ColQwen2.5-v0.2† | 3.75B | 0.524 | 0.601 | 0.895 |
| ColPali v1.3† | 2.92B | 0.430 | 0.547 | 0.848 |
† MTEB 점수. ‡ 저자 자체 평가. 출처: Hugging Face 블로그 표.
저장·속도: 255× 압축과 2× 처리량
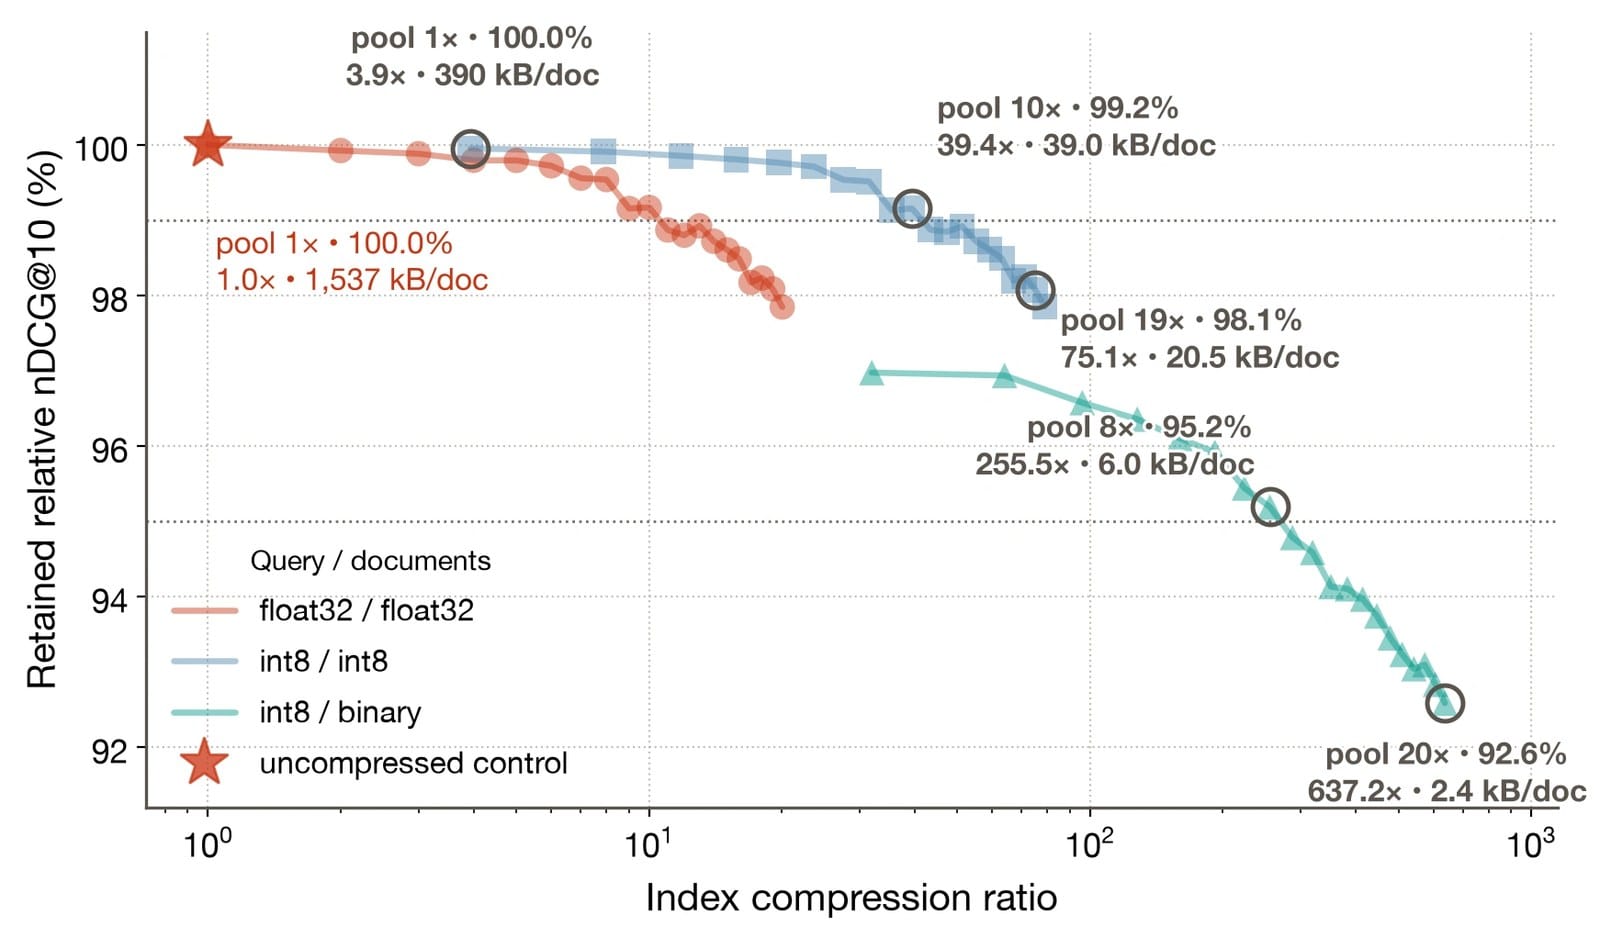
고해상도일수록 late-interaction 벡터 수가 늘어난다. 2048×2048 정사각 페이지는 NeoMME-Retriever 기준 약 4,200개 벡터·float32로 약 2.1MB, ViDoRe v3 평균은 페이지당 약 1.5MB다. 계층적 토큰 풀링은 비슷한 문서 벡터를 묶어 평균으로 바꾸고, 비대칭 양자화는 저장되는 문서 쪽만 int8/바이너리로 줄이고 쿼리는 고정을 유지한다. 풀링 팩터 10 + int8이면 약 39kB(39×, 품질 99%+), 풀링 8 + int8 쿼리 + 바이너리 문서는 6kB(255×, 95%+).
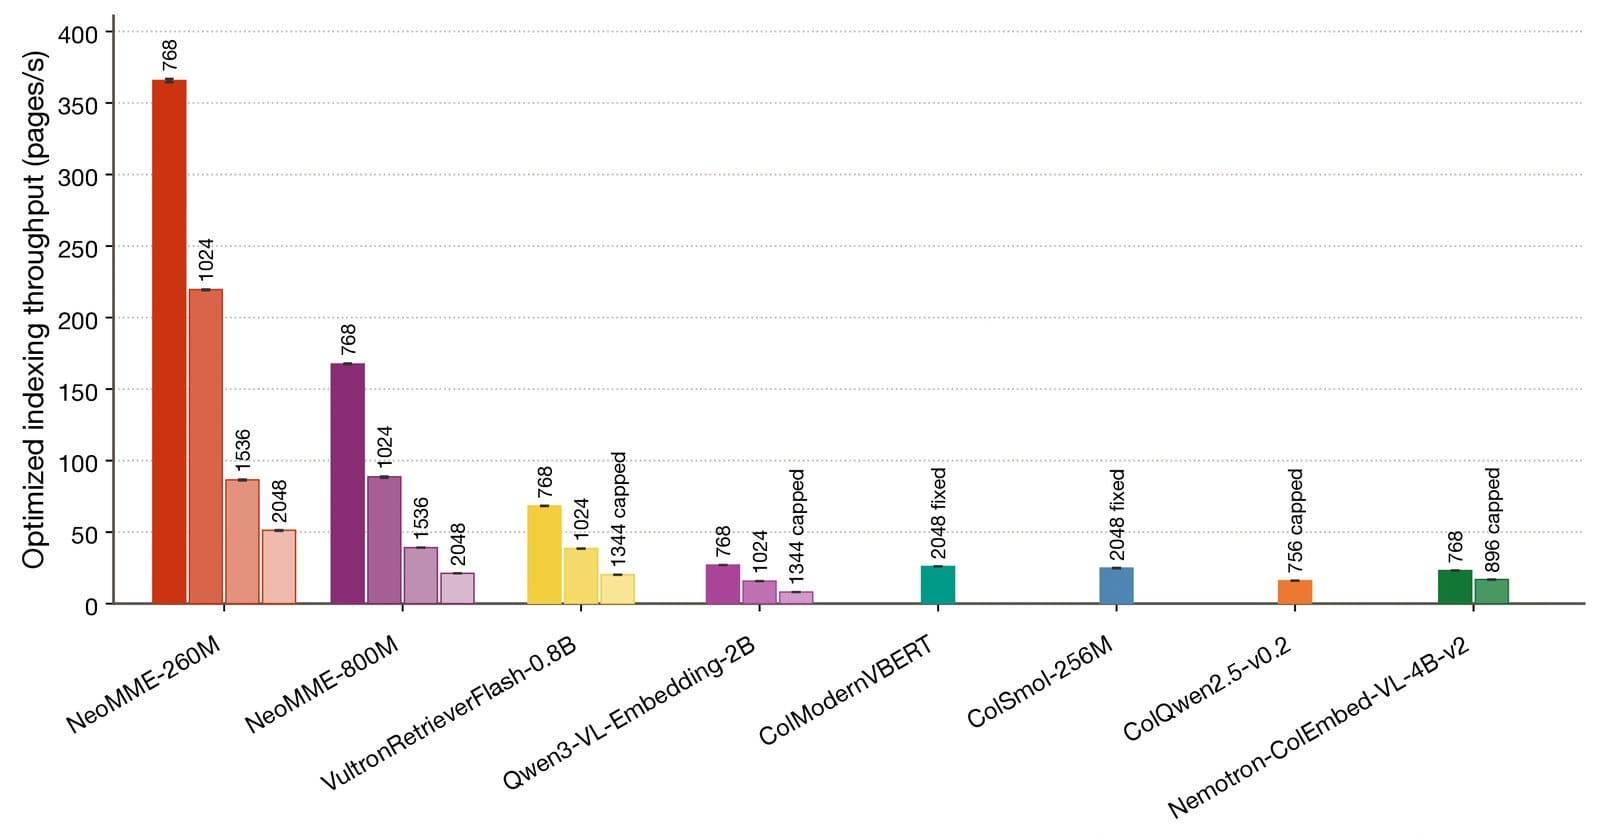
인덱싱 속도도 실무 비용이다. 전처리된 이미지 텐서·배치 크기 별도 보정 조건에서 260M이 초당 약 51페이지로 ColModernVBERT의 약 2배를 주장한다. 작은 해상도에서도 두 크기 모두 비교 모델 대비 빠르다고 한다.
실사용자 반응
공개 직후 Hugging Face 컬렉션·모델 카드·스페이스(tonywu71/neomme-retriever-demo)가 함께 열렸다. 블로그 반응 수는 수십 단위로 쌓였고, “사이드 퀘스트인데 Transformers day-zero + Apache 2.0”이라는 포인트가 반복적으로 언급된다. Sentence Transformers v6용 dense/late-interaction 개별 체크포인트도 제공해, 한 헤드만 미세조정하려는 실무 흐름과도 맞춘다. 대규모 코퍼스에서는 dense로 후보를 좁힌 뒤 late-interaction으로 재랭킹하는 2단 파이프라인을 공식적으로 권한다.
다만 백본 NeoMME-260M/800M 자체는 “다운스트림 헤드 없이 바로 쓰는 완성품”이 아니다. 모델 카드도 검색·분류·추출 등 태스크 헤드 파인튜닝이 필요하다고 명시한다. 안전·편향·프라이버시 종합 평가는 아직 없다고도 적혀 있다. 벤치마크 숫자의 †/‡ 구분(MTEB vs 자체 평가)도 읽을 때 같이 봐야 한다.
의미와 시사점
생성형 VLM을 검색기에 얹는 관성이 강한 지금, NeoMME는 “검색에 생성 디코더가 꼭 필요한가?”를 아키텍처로 다시 묻는다. 같은 계산 경로에 텍스트와 이미지를 태우면 사전학습·파인튜닝·병렬화·서빙을 한 스택으로 맞추기 쉽다. 260M이 수 배~십수 배 큰 ColQwen급과 ViDoRe v3에서 어깨를 나란히 한다는 주장은, 문서 RAG의 특히 시각 RAG(페이지 이미지를 그대로 검색한 뒤 VLM에 넘기는 파이프라인)의 인덱스 비용·지연을 낮출 여지가 있다는 뜻이다.
동시에 한계도 분명하다. 텍스트 사전학습 예산은 ModernBERT보다 작고, 종합 안전 평가가 없으며, ViDoRe 숫자의 일부는 저자 자체 평가다. “파레토 전선”은 그들이 고른 비교 집합 안에서의 이야기다. 그래도 Apache 2.0 + Transformers 통합 + 압축·처리량까지 같이 내놓은 패키징은, 작은 팀이 연 인코더가 실무 실험으로 넘어가기 쉬운 조건을 갖췄다.
마치며
NeoMME의 메시지는 단순하다. 타워를 하나만 세워도, 텍스트와 이미지를 같이 읽고, 검색까지 갈 수 있다. 260M/800M, 16K 컨텍스트, dense+late-interaction 동시 출력, 255× 압축, Apache 2.0. H Company 지원 아래 Lac과 Wu가 연 이 인코더가 시각 문서 검색의 기본 후보군에 남을지는, 커뮤니티 파인튜닝과 독립 벤치가 곧 답할 것이다. 우선은 컬렉션과 데모부터 돌려 보면 된다.
출처
- Hugging Face Blog — NeoMME: an efficient Multimodal-native and Multilingual Encoder (2026-09-03)
- arXiv:2609.01657 — NeoMME technical report
- Hugging Face Collection — NeoMME
- Hcompany/NeoMME-260M, Hcompany/NeoMME-800M-Retriever
- tonywu71/colpali-cookbooks (블로그 공식 도식 에셋)
이 글은 AI가 작성하여 자동 발행된 콘텐츠입니다.