
MiniCPM5-2B 로컬에서 돌리는 법
BF16 가중치 약 5.03GB, GGUF Q4_K_M 1.56GB로 노트북·서버에 MiniCPM5-2B를 올리는 공식 경로다. Ollama·vLLM·llama.cpp·SGLang 명령을 카드와 쿡북에서 옮겼고, 런타임 VRAM GiB는 문서에 없어 추정하지 않는다.

핵심 요약 (TL;DR)
이 글은 받아서 자기 기계에서 켜는 안내다. OpenBMB의 openbmb/MiniCPM5-2B는 파라미터 약 2.52B(총 2,516,756,480)짜리 밀집 LlamaForCausalLM이다. 라이선스는 Apache-2.0. 설계 컨텍스트는 131,072(128K). 출시·벤치 해설은 아침 TWMS 글에 있고, 여기는 설치·서빙만 따라간다.
공식 카드 Quickstart가 열어 둔 서버 경로는 셋이다. vLLM(vllm>=0.21), SGLang(sglang[srt]>=0.5.16), Transformers(transformers>=5.6). 노트북·엣지용으로는 GGUF 저장소 openbmb/MiniCPM5-2B-GGUF와 쿡북의 Ollama·llama.cpp·Apple Silicon용 MLX가 있다. 커스텀 커널·모델 포크는 필요 없다고 카드가 적는다.
숫자만 먼저 고정한다. Hugging Face Files API 기준 BF16 safetensors는 5.03GB(약 4.69GiB)다. GGUF는 공식 표와 파일 크기가 같다. F16 5.04GB, Q8_0 2.68GB, Q4_K_M 1.56GB. vLLM Recipes는 BF16 가중치를 “~5 GB”, “single consumer GPU”에 들어간다고 적는다. 런타임 VRAM(GiB) 한 줄 숫자는 공식 카드·쿡북에 없다. 없는 칸은 추정하지 않는다.
용어를 한 번만 푼다. GGUF는 llama.cpp 계열이 읽는 양자화 가중치 형식이다. 양자화는 가중치를 더 작은 비트로 줄여 디스크·메모리를 아끼는 방법이다. Think는 채팅 템플릿의 enable_thinking으로 켜는 심사숙고 모드다. MiniCPM5-2B Think의 권장 샘플링은 온도 1.0, top_p 0.95다. 도구 호출(tool calling)은 모델이 함수 이름·인자를 내보내는 형식이다. MiniCPM5는 XML 스타일을 쓰고, 파서 이름은 minicpm5다.
배경 및 맥락
MiniCPM5-2B는 온디바이스·로컬·자원이 빠진 환경용으로 나왔다. 카드 Model List는 BF16 최종본 옆에 SFT·Midtrain·Base 체크포인트, GGUF, MLX, GPTQ, DSpark, LiteRT를 나란히 둔다. “형식만 고르면 된다”는 디렉터리 안내다.
단계별 문장은 GitHub 쿡북 docs/deployment/에 있다. vLLM·SGLang·Transformers·llama.cpp·Ollama·LM Studio·MLX·ArcLight·vLLM Ascend. 이 글은 검색 의도에 맞춰 Ollama(가장 짧은 노트북 경로), vLLM(서버), llama.cpp, 그리고 카드 Quickstart의 Transformers·SGLang만 적는다. 파인튜닝·FlagOS 9칩은 링크만 남긴다.
이걸로 할 수 있는 일
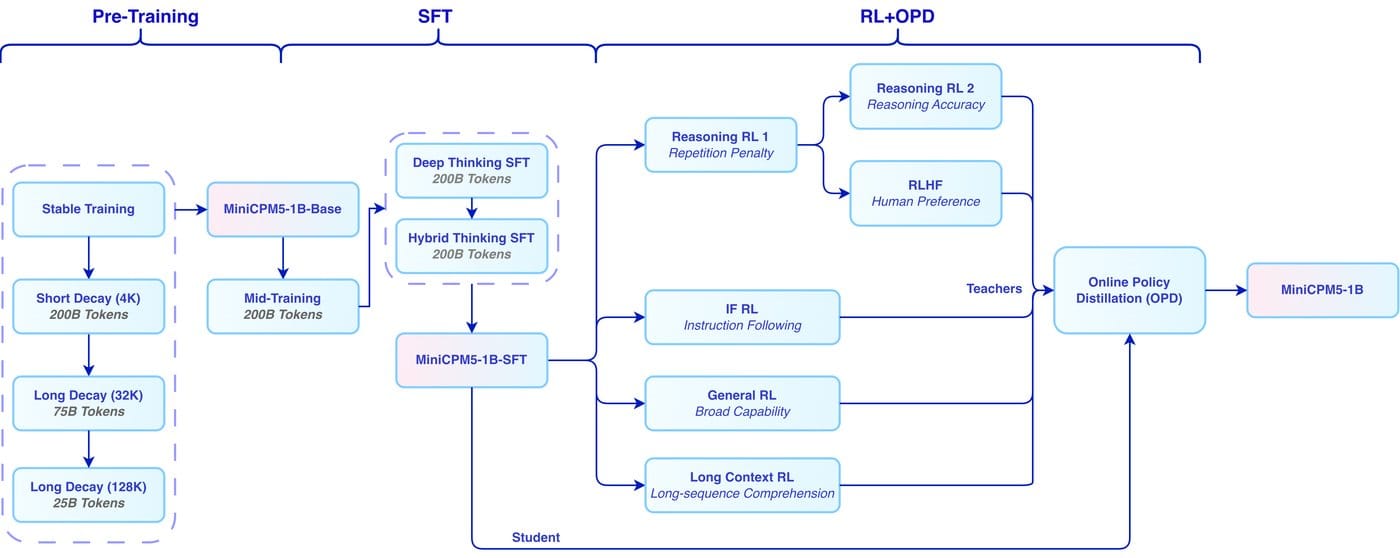
카드 Introduction이 적어 둔 용도는 로컬 어시스턴트, 코딩 에이전트, 도구 사용 워크플로, 작은 모델이 나은 추론이다. 같은 체크포인트에서 Think / No-Think를 채팅 템플릿으로 갈라 쓴다(vLLM Recipes·Transformers 예제). 도구 호출은 SGLang을 권장 백엔드로 적고, vLLM도 minicpm5 파서를 문서화한다. DSpark 드래프트로 SGLang 투기 디코딩을 켤 수 있다.
이 가이드의 목표는 “그 서버·CLI를 내 포트에 올리는 것”이다. 벤치 점수 해설은 아침 글을 보라.
필요한 것
아래 표는 공식 카드·vLLM Recipes·GitHub docs/deployment·HF Files API에서 확인한 값이다. 없는 칸은 “문서에 없음”이다.
| 항목 | 공식 문서/저장소 | 비고 |
|---|---|---|
| 모델 ID (BF16) | openbmb/MiniCPM5-2B | Apache-2.0 · LlamaForCausalLM · 2,516,756,480 params |
| 컨텍스트 | 131,072 | 카드 Model Information. 작은 GPU에선 vLLM이 --max-model-len을 8192/32768로 줄이라고 적음 |
| BF16 디스크 | safetensors 5.03GB | HF Files API 합. Recipes 표기 “BF16 5 GB” |
| GGUF | openbmb/MiniCPM5-2B-GGUF | F16 5.04GB · Q8_0 2.68GB · Q4_K_M 1.56GB (쿡북·HF 표 동일) |
| vLLM | vllm>=0.21 | 카드 Quickstart · Recipes · 쿡북 |
| SGLang | sglang[srt]>=0.5.16 | 카드 Quickstart. 도구 호출 권장 백엔드 |
| Transformers | transformers>=5.6 + accelerate + torch | 카드 Quickstart. trust_remote_code 불필요(쿡북) |
| Ollama | CLI 한 개 + GGUF | 쿡북: brew 또는 install.sh. Python/CUDA 툴킷 불필요 |
| 런타임 VRAM GiB | 문서에 없음 | “single consumer GPU”, “minimal VRAM”(Q4) 표현만. GiB 추정 금지 |
단계: Ollama (노트북 기본)
공식 docs/deployment/ollama.md TL;DR을 2B 기준으로 옮긴다.
brew install ollama                 # macOS
# or: curl -fsSL https://ollama.com/install.sh | sh   (Linux)

OLLAMA_FLASH_ATTENTION=1 OLLAMA_KV_CACHE_TYPE=q8_0 ollama serve &

mkdir -p ~/minicpm5-2b && cd ~/minicpm5-2b
huggingface-cli download openbmb/MiniCPM5-2B-GGUF MiniCPM5-2B-Q4_K_M.gguf --local-dir .

QUANT=Q4_K_M
cat > Modelfile <<EOF
FROM ./MiniCPM5-2B-${QUANT}.gguf

TEMPLATE """{{- if .Messages -}}
{{- range .Messages -}}
<|im_start|>{{ .Role }}
{{ .Content }}<|im_end|>
{{ end -}}
<|im_start|>assistant
{{ end -}}"""

PARAMETER stop "<|im_end|>"
PARAMETER stop "</s>"

PARAMETER temperature 1.0
PARAMETER top_p 0.95
PARAMETER num_ctx 8192
EOF

ollama create minicpm5-2b -f Modelfile
ollama run minicpm5-2b
쿡북 양자화 표는 Q4_K_M을 노트북 기본으로 적는다. 긴 컨텍스트는 Modelfile에서 PARAMETER num_ctx 32768로 올린다. OpenAI 호환 API는 http://localhost:11434/v1이다.
curl http://localhost:11434/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{
    "model": "minicpm5-2b",
    "messages": [{"role": "user", "content": "GQA를 한 문장으로 설명해."}],
    "temperature": 1.0, "top_p": 0.95, "max_tokens": 1024
  }'
Ollama 0.24는 GGUF에 심긴 Jinja를 직접 평가하지 않는다고 쿡북이 적는다. MiniCPM5-2B Think 경로를 강제하려면 raw 모드로 <think>\n을 직접 붙이라는 안내가 있다. 그 예제는 쿡북 본문을 보라.
단계: vLLM (서버)
카드 Quickstart의 최소형은 이렇다.
pip install "vllm>=0.21"
vllm serve openbmb/MiniCPM5-2B --port 8000
GitHub 쿡북이 권장하는 풀 옵션은 아래다.
vllm serve openbmb/MiniCPM5-2B \
    --served-model-name MiniCPM5-2B \
    --dtype bfloat16 \
    --max-model-len 131072 \
    --gpu-memory-utilization 0.85 \
    --port 8000
Think 모드 요청 예(쿡북·Recipes 공통 패턴):
curl http://localhost:8000/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{
    "model": "MiniCPM5-2B",
    "messages": [{"role": "user", "content": "GQA를 한 문장으로 설명해."}],
    "temperature": 1.0,
    "top_p": 0.95,
    "max_tokens": 1024,
    "chat_template_kwargs": {"enable_thinking": true}
  }'
튜닝은 쿡북 표를 따른다. KV가 빠지면 --max-model-len을 8192/32768로. 공유 GPU면 --gpu-memory-utilization을 낮춘다(비율이 값보다 작으면 hard-fail). CUDA graph가 작은 VRAM에서 OOM이면 --enforce-eager.
도구 호출 주의. Recipes는 pip 경로에서 --tool-call-parser minicpm5를 바로 켠다. 같은 저장소 쿡북은 파서가 일부 pip 릴리스 트리에 없을 수 있어 --tool-parser-plugin으로 tool_parsers/minicpm5xml_tool_parser.py를 붙이라고 적는다. 채팅만이면 최소 커맨드로 충분하고, 도구 호출이 필요하면 지금 깐 vLLM 버전에 파서가 있는지 확인한 뒤 Recipes 경로 또는 플러그인 경로를 고른다.
단계: llama.cpp · Transformers · SGLang
llama.cpp (쿡북 TL;DR):
huggingface-cli download openbmb/MiniCPM5-2B-GGUF MiniCPM5-2B-Q4_K_M.gguf --local-dir ./minicpm5
llama-cli -m ./minicpm5/MiniCPM5-2B-Q4_K_M.gguf -n 2048 --temp 1.0 --top-p 0.95 -ngl 99
서버는 llama-server -m MiniCPM5-2B-Q4_K_M.gguf --port 8080 -ngl 99 -c 8192 --jinja.
Transformers (카드 Quickstart 요약):
pip install -U "transformers>=5.6" accelerate torch
from transformers import AutoModelForCausalLM, AutoTokenizer
model_id = "openbmb/MiniCPM5-2B"
tokenizer = AutoTokenizer.from_pretrained(model_id)
model = AutoModelForCausalLM.from_pretrained(
    model_id, torch_dtype="auto", device_map="auto",
)
messages = [{"role": "user", "content": "너는 누구야? 짧게 소개해."}]
inputs = tokenizer.apply_chat_template(
    messages, tokenize=True, add_generation_prompt=True,
    enable_thinking=True, return_dict=True, return_tensors="pt",
).to(model.device)
outputs = model.generate(**inputs, max_new_tokens=128)
print(tokenizer.decode(outputs[0][inputs["input_ids"].shape[-1]:], skip_special_tokens=True))
SGLang (카드 Quickstart + 도구 파서):
pip install "sglang[srt]>=0.5.16"
python -m sglang.launch_server --model-path openbmb/MiniCPM5-2B --port 30000 \
    --tool-call-parser minicpm5
DSpark 투기 디코딩은 카드의 --speculative-algorithm DSPARK · openbmb/MiniCPM5-2B-DSpark · --speculative-dspark-block-size 7 블록을 그대로 쓴다.
Apple Silicon에서 처리량이 목표면 쿡북 mlx.md의 mlx_lm.generate --model openbmb/MiniCPM5-2B-MLX 경로가 있다.
막히는 지점 / 왜 막히나
첫 층은 컨텍스트를 128K로 고정한 채 작은 GPU다. 쿡북·Recipes 모두 KV를 비우라고 --max-model-len / num_ctx를 줄이라고 한다. 모델 가중치 5GB와 KV는 별개다.
둘째는 vLLM 메모리 비율이다. --gpu-memory-utilization보다 여유 VRAM 비율이 작으면 hard-fail한다고 쿡북이 적는다. 공유 GPU면 값을 낮춘다.
셋째는 도구 파서 버전이다. Recipes와 쿡북 플러그인 안내가 갈린다. minicpm5 파서가 없는 휠이면 플러그인 경로를 쓰거나, 채팅만 먼저 켠다.
넷째는 Ollama Think다. 2B Think는 raw 프롬프트로 <think>를 직접 넣는 우회가 쿡북에 있다. GUI만 쓰다 “생각이 안 나온다”면 그 절을 보라.
다섯째는 형식 혼동이다. BF16 서버(vLLM/SGLang/Transformers)와 GGUF(Ollama/llama.cpp)는 저장소가 다르다. MiniCPM5-2B와 MiniCPM5-2B-GGUF를 바꿔 쓰지 않는다.
실사용자 반응
이 칸은 지어내지 않는다. 공개 채널에서 바로 옮길 만한 설치 후기 묶음은 이 글을 쓰는 시점에 아직 얇다. 확인 가능한 사실은 HF 카드의 day-0 서빙 문구(vLLM/SGLang/Transformers), GGUF·MLX·GPTQ 동시 공개, 그리고 TWMS 아침 글이 링크한 MarkTechPost·OrcaRouter 보도다. 별점·“쉽다/어렵다” 여론은 만들지 않는다.
의미와 시사점
GLM-Flash 가이드는 수백 GiB와 멀티 GPU가 본체였다. MiniCPM5-2B는 5GB대 BF16과 1.56GB Q4가 본체다. “로컬” 검색어가 같은 모양이어도, 디스크·서빙 엔진 선택이 완전히 다르다. 표준 Llama 로드는 실험 비용을 낮추고, Think·도구 파서·DSpark는 작은 모델을 에이전트 루프에 넣으려는 쪽이다. 반대로 공식 카드가 런타임 VRAM GiB를 안 적은 점은 그대로 한계다. 프로덕션 전에 자기 GPU에서 --max-model-len을 재는 편이 안전하다.
마치며
MiniCPM5-2B를 로컬에서 돌리는 법은 공식 문서가 이미 짧게 적어 두었다. 노트북이면 GGUF Q4_K_M + Ollama. 서버면 vllm>=0.21로 vllm serve openbmb/MiniCPM5-2B. 도구 호출은 SGLang --tool-call-parser minicpm5가 카드 권장이다. VRAM GiB는 문서에 없으니 추정하지 말고, 컨텍스트만 먼저 줄여 보라. 오늘은 그 명령만 복사하면 된다.
출처
- Hugging Face — openbmb/MiniCPM5-2B
- Hugging Face — openbmb/MiniCPM5-2B-GGUF
- vLLM Recipes — MiniCPM5-2B
- GitHub — docs/deployment/ollama.md
- GitHub — docs/deployment/vllm.md
- GitHub — docs/deployment/llama_cpp.md
- GitHub — docs/deployment/sglang.md
- TWMS — 작아도 에이전트다: OpenBMB가 MiniCPM5-2B를 연 이유
이 글은 AI가 작성하여 자동 발행된 콘텐츠입니다.