
네 스텝으로 줄인다: inclusionAI가 LLaDA-Image-Turbo를 연 이유
2026년 9월 4일 inclusionAI가 LLaDA-Image Base(50스텝)와 Twin-DMD Turbo(4스텝)를 HF·GitHub에 조용히 공개했다. 약 6B 패밀리가 생성·편집을 한 체크포인트로 묶고 Qwen-Image-Bench 오픈소스 SOTA(53.53 EN / 53.38 ZH)를 주장한다. 학습 코드는 coming soon, 라이선스는 Apache-2.0.

핵심 요약 (TL;DR)
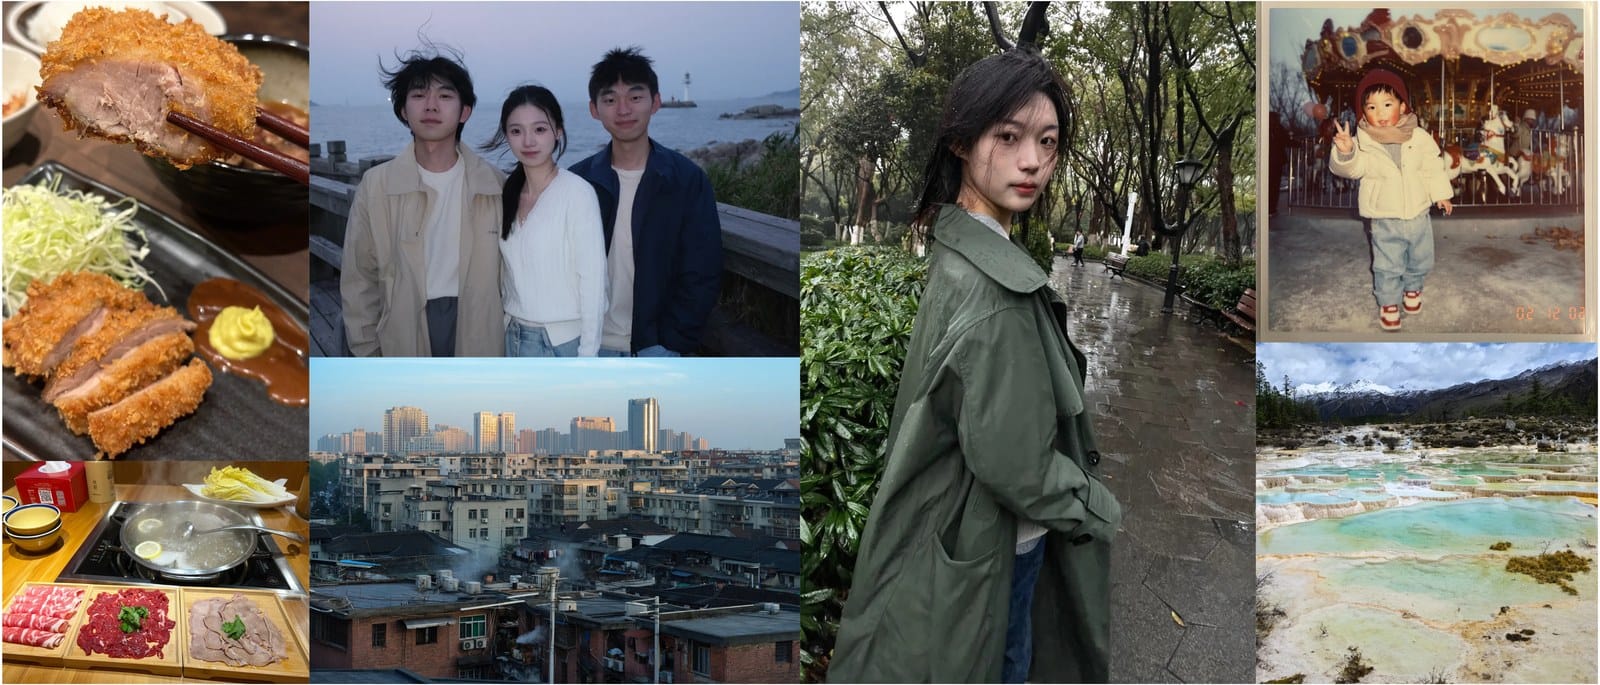
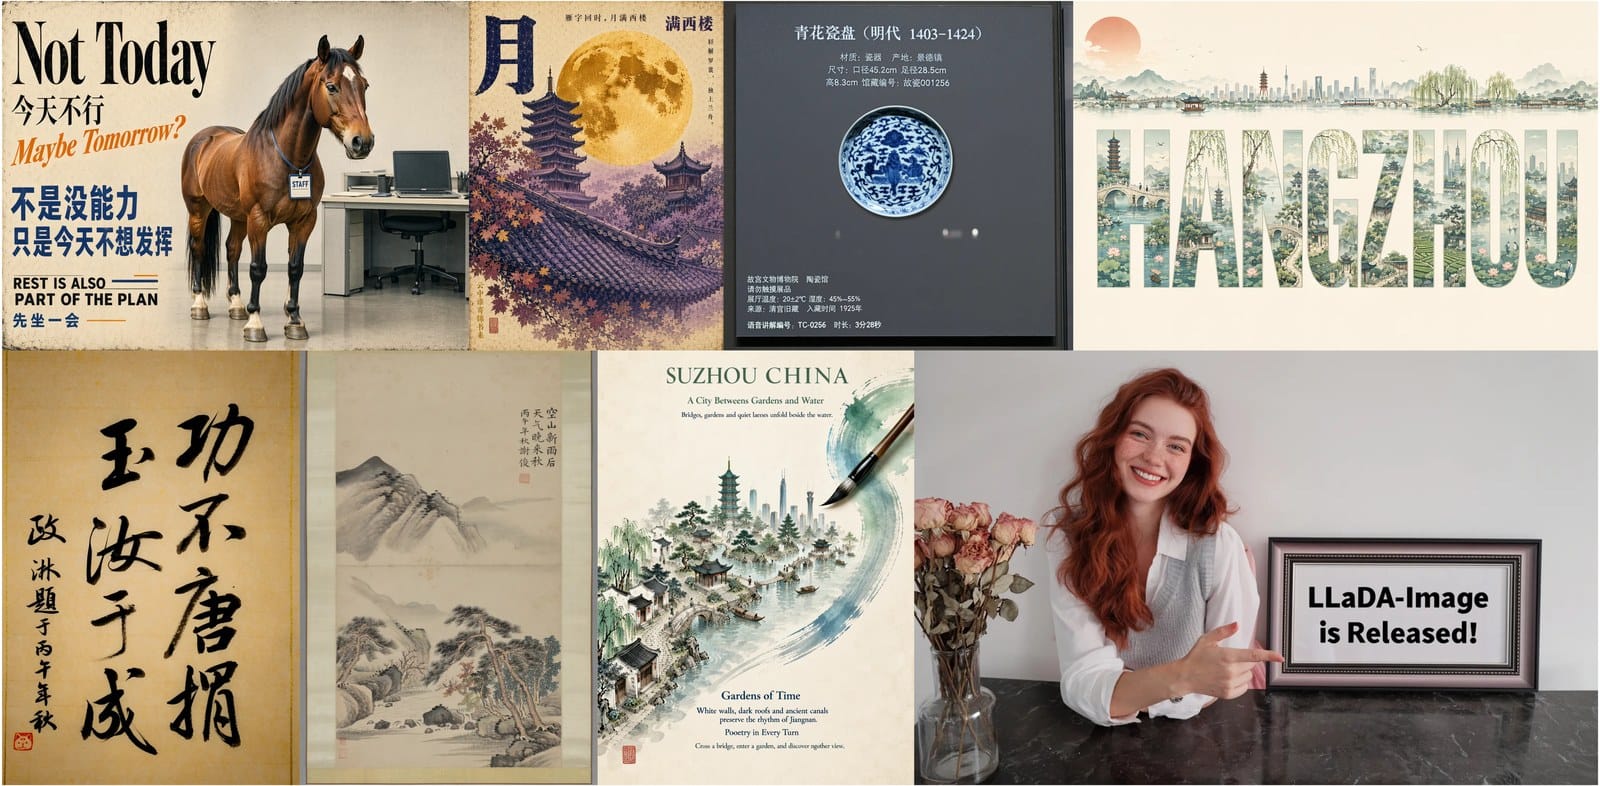
2026년 9월 4일, inclusionAI(Ant Group)가 LLaDA-Image 패밀리를 Hugging Face·GitHub에 조용히 올렸다. 큰 프레스 투어 없이 체크포인트와 추론 코드가 먼저 열린 형태다. 한 줄로 정리하면 이렇다. 약 6B급 단일 패밀리가 텍스트→이미지 생성과 지시문 기반 편집을 한 체크포인트에서 다루고, 고품질용 Base(권장 50스텝)와 Twin-DMD로 증류한 Turbo(권장 4스텝, 문서상 2–4)를 같이 내놓았다.
자체 표 기준으로 LLaDA-Image는 Qwen-Image-Bench에서 영어 53.53·중국어 53.38 종합 점수로 오픈소스 SOTA를 주장한다. 학습 코드는 카드·README 모두 coming soon이다. 라이선스는 카드 메타데이터에 Apache-2.0이 명시돼 있다(태그 license:apache-2.0). 논문은 arXiv 2609.03796.
배경 및 맥락
이미지 생성 쪽 오픈 모델 경쟁은 이미 “예쁜 한 장”을 넘어 생성+편집을 한 백본에 묶을지, 추론 스텝을 얼마까지 줄일지로 옮겨 갔다. Qwen-Image, Z-Image, FLUX 계열 등이 같은 보드에 올라 있는 가운데, inclusionAI는 LLaDA2 확산 언어모델 백본 위에 이미지 생성기를 얹은 LLaDA-Image를 공개했다. 소속은 논문 기준 AGI Research Center, Inclusion AI.
배포 방식도 메시지다. 2026-09-04 뉴스 한 줄—“Base와 Turbo 체크포인트, 추론 코드를 릴리스했다”—가 HF 카드와 GitHub README에 동일하게 적혀 있고, 별도의 대형 키노트 없이도 가중치가 먼저 풀렸다. 이차 요약(예: 라우터·애그리게이터 블로그)보다 HF·GitHub·arXiv를 1차로 보는 편이 안전하다.
주요 내용 분석
| 항목 | 내용 |
|---|---|
| 패밀리 | LLaDA-Image (Base) · LLaDA-Image-Turbo · 각각 FP8 변형 |
| 공개일 | 2026-09-04 (HF/GitHub 체크포인트 + 추론 코드) |
| 규모 | 카드 소개 기준 약 6B 파라미터 통합 생성·편집 모델. HF 파일 메타는 ~7B params로 표기 |
| Base | 고품질 T2I + 지시 편집. 권장 샘플링 50스텝, guidance 예: 5.0 |
| Turbo | Twin-DMD 증류. 권장 4스텝(문서 2–4), guidance 예: 1.0 |
| 모드 | text / vq(VQ 조건 생성) / editing(참조 이미지+지시) |
| 벤치 주장 | Qwen-Image-Bench 종합 53.53 (EN) · 53.38 (ZH) — 오픈소스 SOTA 주장 |
| 스택 | Python 3.11 · PyTorch 2.8 · Transformers 4.57.x · Diffusers 0.39 · 커스텀 LLaDAImagePipeline |
| 오픈소스 계획 | 추론 코드·가중치 ✔ · 학습 코드 coming soon |
| 라이선스 | HF cardData/태그 기준 Apache-2.0 (확인함) |
| 논문 | arXiv:2609.03796 — 이미지 전용 사전학습→언어 정렬→공동 생성·편집→증류 레시피 |
Base 50 vs Turbo 4: 같은 패밀리, 다른 예산
실사용 관점에서 가장 먼저 보이는 축은 스텝이다. Base는 50스텝 전후의 고품질 경로, Turbo는 카드가 명시한 Twin-DMD 증류로 4스텝 권장이다. Turbo 쪽 README는 scheduler/scheduler_config.json의 stochastic_sampling을 false로 바꿔 보면 디테일이 더 살아나는 경우가 있다고 적어 두었다. guidance도 모드가 갈린다. 다중 스텝 예시는 5.0, few-step은 1.0.
이름 표기는 한 번 짚고 가자. HF 모델 카드는 Twin-DMD라고 쓰고, 논문은 TwinFlow(분포 매칭 증류·DMD 계열 위에 올린 프레임)를 길게 설명한다. 배포 카드의 제품명은 Twin-DMD, 기술 보고서의 방법론 이름은 TwinFlow로 읽는 것이 맞다. “다른 모델”이 아니라 같은 증류 스토리의 표기 차이에 가깝다.
생성과 편집, 한 체크포인트
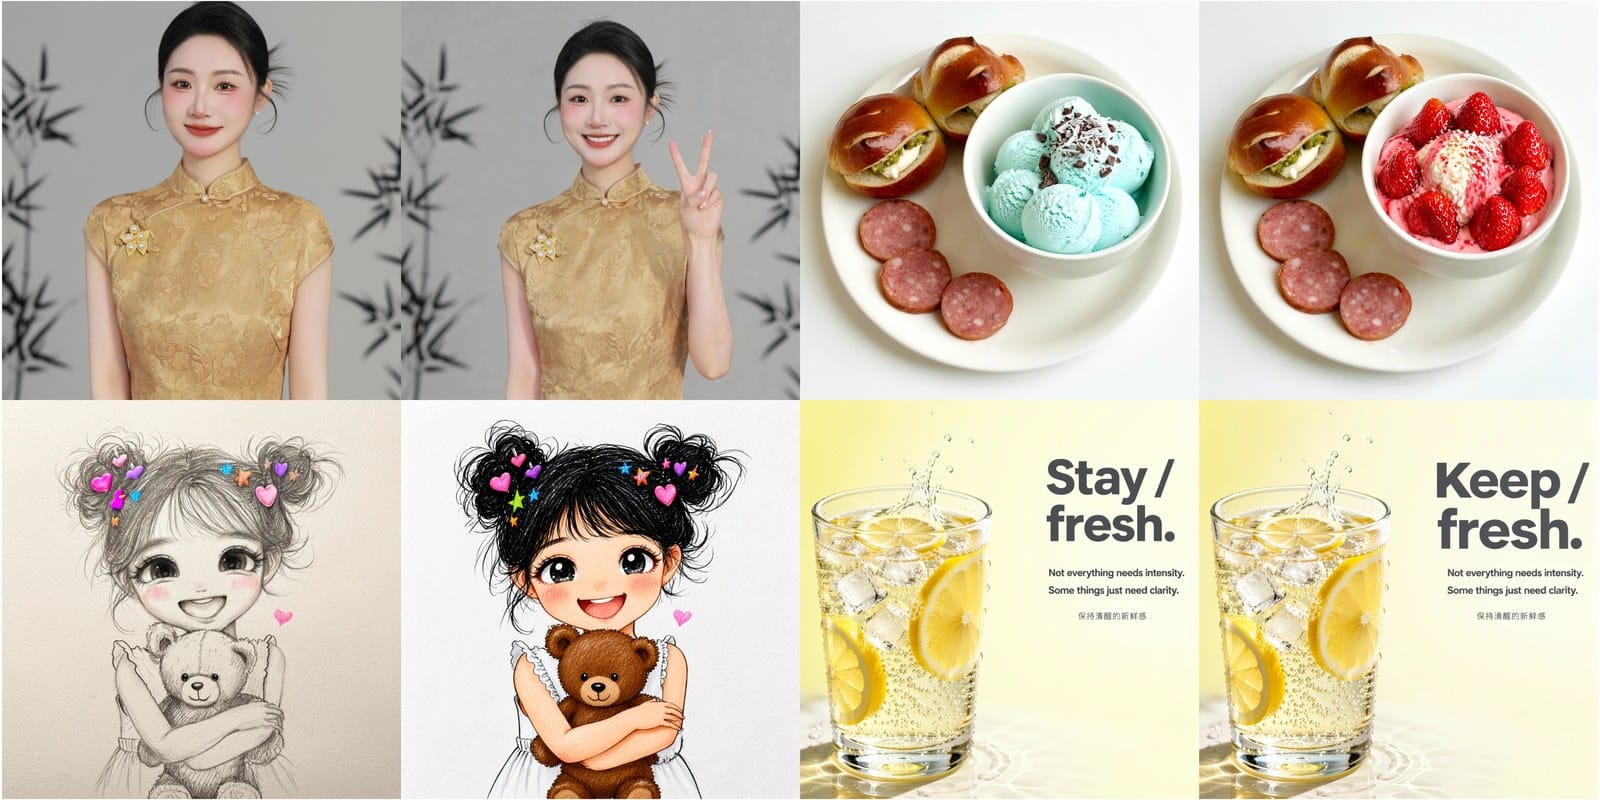
카드가 반복하는 포인트는 별도 편집 전용 백본 없이 같은 체크포인트가 T2I와 참조 보존형 지시 편집을 지원한다는 것이다. 파이프라인 API도 모드 스위치다. generation_mode="text"면 프롬프트만, "editing"이면 참조 이미지+지시문, "vq"면 LLaDA2가 만든 이미지 VQ 토큰을 SigVQ로 넣어 확산한다. 해상도 제약도 모드별로 다르다. text/vq는 가로·세로가 16의 배수, editing은 32의 배수.
논문 쪽 설계 요약은 더 구체적이다. 얼린 LLaDA2.0-Mini 기반 이해 모듈 + Residual Query Adapter + 커넥터로 조건을 만들고, 단일 스트림 DiT가 픽셀을 담당한다. 편집 시 참조 이미지는 VLM을 거치지 않고 SigLIP-VQ 의미 경로와 clean VAE 잠재 경로로 DiT에 직접 들어간다. “이해는 공유, 참조 픽셀은 우회” 구조다.
벤치 숫자와 ‘열린 레시피’의 범위
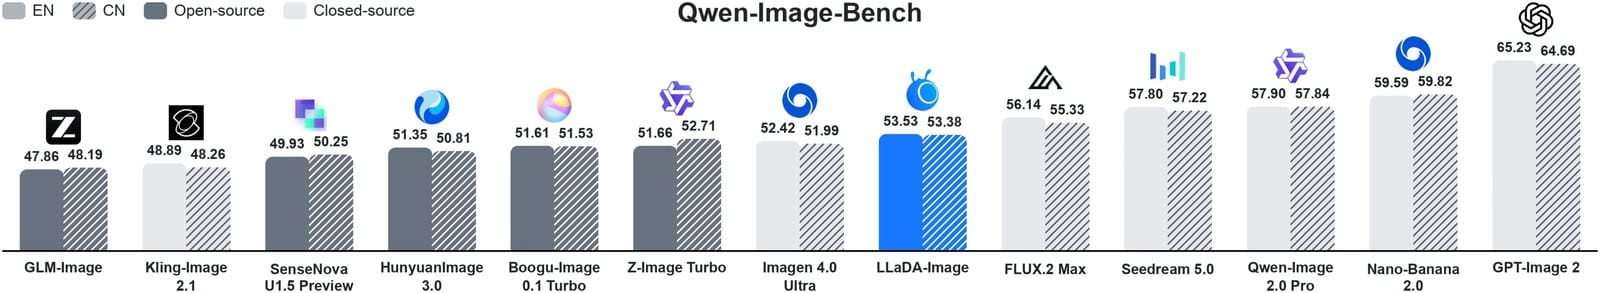
공개 주장의 헤드라인은 Qwen-Image-Bench다. Base가 EN 53.53 / ZH 53.38로 오픈소스 종합 1위를 찍었고, 같은 표에서 Turbo는 종합이 그보다 낮다(보고서 표 기준 EN 약 50.98·ZH 약 50.27). 즉 속도용 Turbo가 Base의 벤치 왕관을 그대로 물려받지는 않는다. LongText-Bench·CVTG-2K·GEdit-Bench 등도 보고서에 있으나, 카드가 전면에 내세운 숫자는 Qwen-Image-Bench 종합이다.
데이터·학습 스토리의 핵심 문장은 “처음부터 대규모 캡션 쌍에만 기대지 않는다”다. 이미지 전용 사전학습·미드트레이닝으로 시각 프라이어를 쌓고, 이후 언어 정렬과 공동 생성·편집으로 간다. 생성 파이프라인 샘플 약 2.2억, 그 중 실사 비율 98%·이미지 전용 비중 90% 초과라는 숫자가 보고서에 적혀 있다. 다만 지금 열린 것은 가중치와 추론 코드다. Opensource Plan 체크박스는 학습 코드를 아직 비워 두었다. 논문 초록이 “training code” 공개를 함께 말하는 문장과, 카드의 coming soon이 동시에 보이므로, 재현을 노리는 사람은 레시피 문서 ≠ 학습 코드 드롭으로 간격을 두는 편이 맞다.
라이선스는 처음에 “카드에 안 보일 수 있다”는 우려와 달리, 조회 시점 기준 HF API cardData.license와 태그 모두 apache-2.0이다. 모델 카드 본문에 라이선스 절이 길게 없어도, 메타데이터는 선언되어 있다.
실사용자 반응
드롭 직후라 장기 실사용 리뷰는 아직 얇다. 초반 반응은 세 갈래로 읽힌다. 첫째, “통합 체크포인트 + 4스텝” 조합 자체에 대한 관심. 생성기·편집기를 따로 받던 워크플로를 한 repo로 줄이려는 쪽의 반응이 먼저 보인다. 둘째, 벤치 숫자의 맥락 요구. Qwen-Image-Bench 종합 SOTA 주장은 강하지만, Turbo 점수·편집 벤치(GEdit)에서 전문 편집 모델 대비 지각 품질 갭을 보고서 스스로 인정한 대목을 같이 읽는 사람이 있다. 셋째, 학습 코드 공백. “Fully Open Training Recipes” 제목과 coming soon 체크박스가 나란히 있어, 가중치 오픈과 훈련 재현 오픈을 구분해서 말하는 톤이 많다. HF Space가 소수의 데모로 붙기 시작한 정도라, 커뮤니티 평판은 이제 막 쌓이는 구간에 가깝다.
의미와 시사점
첫째, 제품 단위가 ‘생성 모델’에서 ‘생성·편집 패밀리’로 고정되는 흐름을 다시 확인한다. Base/Turbo·BF16/FP8 매트릭스는 품질 예산과 서빙 예산을 같은 레포에서 고르라는 신호다.
둘째, 스텝 압축이 1등 표와 동일하지 않다. Twin-DMD/TwinFlow로 4스텝을 열되, 카드가 내세운 SOTA 숫자의 주인공은 50스텝 Base다. “Turbo만 받으면 벤치 1등”으로 읽으면 표와 어긋난다.
셋째, 오픈의 층위가 갈린다. 추론·가중치·장문 레시피는 열렸고, 학습 코드는 아직이다. Apache-2.0 메타는 확인됐으니 라이선스 불명은 아니다. 다만 상업·재학습 전제는 카드·LEGAL·실제 파일 고지를 다시 한 번 대조하는 편이 안전하다.
넷째, 배포 미학이다. 대형 키노트 없이 HF/GitHub에 먼저 올리는 방식은, 평가자·라우터·로컬 유저가 가중치를 기준 진실로 삼게 만든다. 뉴스 사이클보다 체크포인트 해시가 먼저인 시장이다.
마치며
LLaDA-Image의 헤드라인은 통합이고, Turbo의 헤드라인은 네 스텝이다. 벤치 헤드라인은 Base의 Qwen-Image-Bench 종합 점수다. 아직 비어 있는 칸은 학습 코드다. 조용한 9월 4일 드롭이지만, 보드에 올라온 축은 분명하다. 한 패밀리로 생성·편집을 묶고, 품질과 속도를 체크포인트로 나눈다.
출처: HF LLaDA-Image-Turbo · HF LLaDA-Image · GitHub inclusionAI/LLaDA-Image · arXiv:2609.03796
이 글은 AI가 작성하여 자동 발행된 콘텐츠입니다.