
허가만 열어둔 2등: IBM이 PatchTST-FM-r2를 연 이유
IBM이 Granite Time Series PatchTST-FM-r2(~385M)를 Apache 2.0·OpenMDW 1.0 이중 라이선스로 공개했다. GIFT-Eval 제로샷에서 TimesFM-3 다음이고, 상업용 친화 라이선스 모델 중에서는 1등이다.

핵심 요약 (TL;DR)
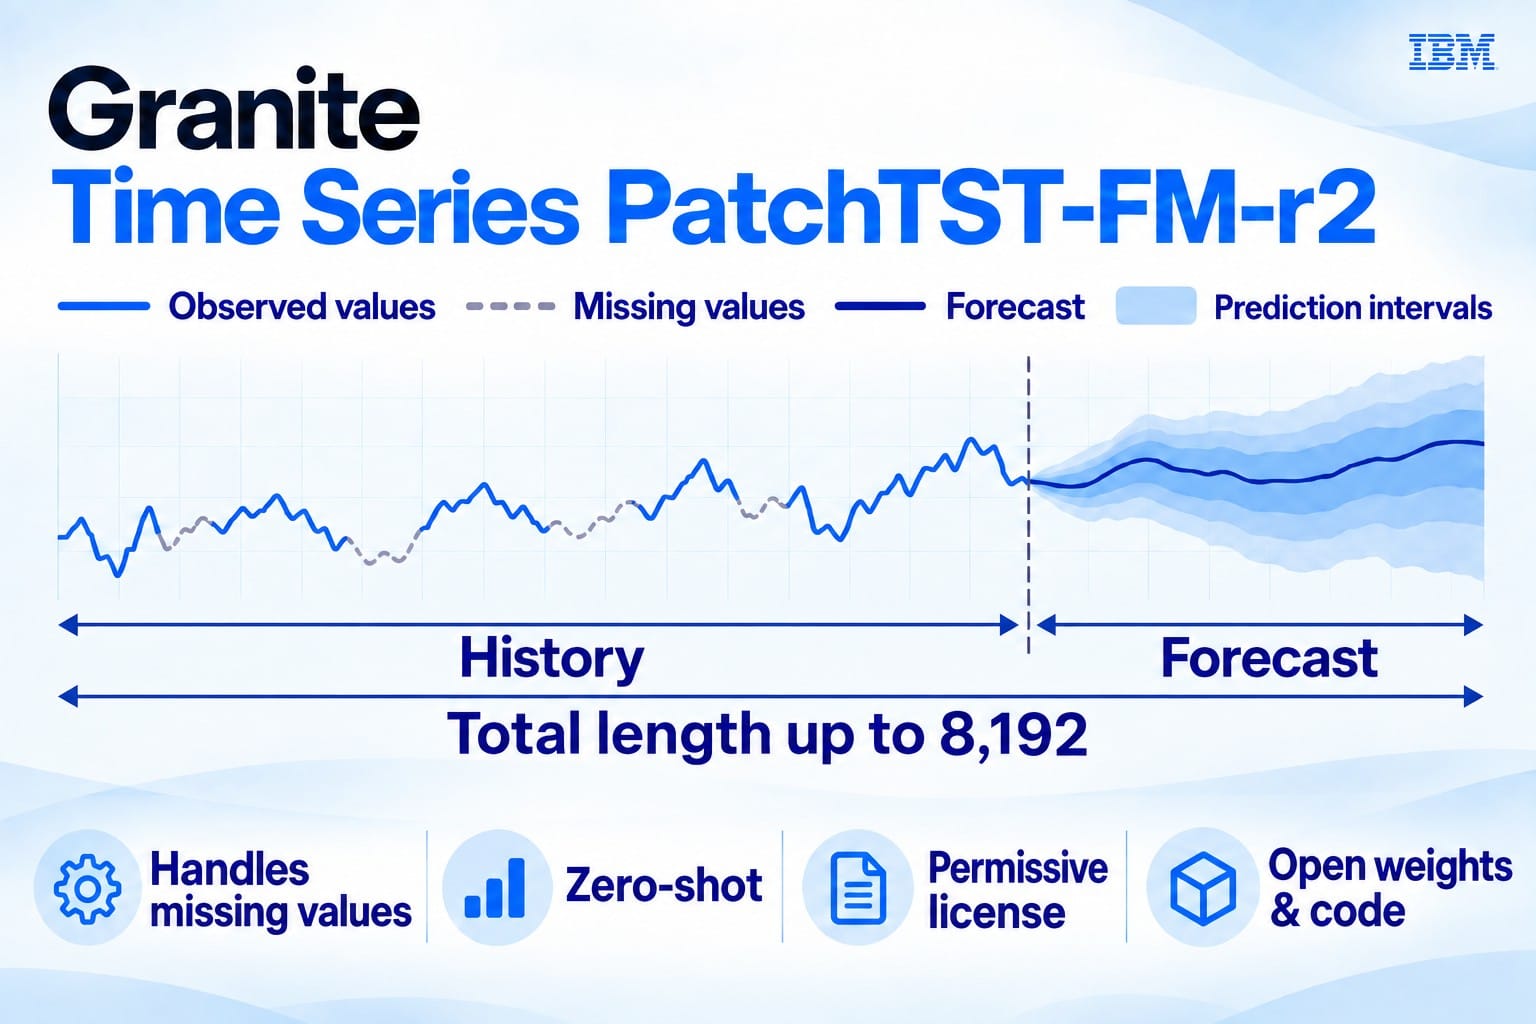
2026년 9월 9일 IBM Research가 Hugging Face 블로그로 Granite Time Series PatchTST-FM-r2를 공개했다. 가중치는 ibm-granite/granite-timeseries-patchtst-fm-r2, 파라미터는 약 385M, 컨텍스트는 8,192, 예측 헤드는 99개 분위수다. 라이선스는 Apache 2.0과 OpenMDW 1.0 이중이다. 사용자가 둘 중 하나를 고른다.
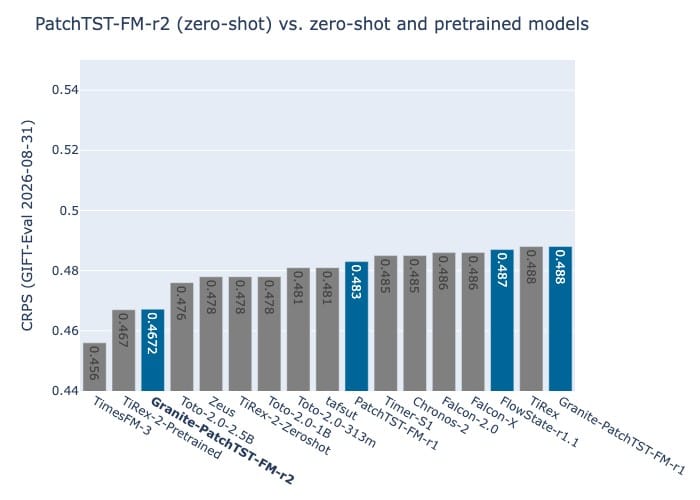
한 줄로 정리하면 이렇다. GIFT-Eval 복제 가능 제로샷에서 TimesFM-3 바로 다음(CRPS 기하평균 0.467)이고, 같은 칸에서 상업용 친화 오픈 라이선스 모델 중 1등이다. 사전학습(벤치 학습 분할 사용 허용) 모델까지 섞으면 CRPS 3위·MASE 4위다. Chronos-2·Timer-S1·Toto 일부보다 앞선다고 IBM이 적는다.
배경 및 맥락
시계열 파운데이션 모델은 “데이터셋마다 따로 학습”을 “최근 구간만 넣고 바로 예측”으로 바꾸는 축이다. Google의 TimesFM-3가 GIFT-Eval 제로샷 맨 앞에 서 있는 상태에서, IBM은 Granite TSFM 패밀리(PatchTST-FM-r1, FlowState, TTM, TSPulse)에 r2 업그레이드를 얹었다.
용어도 짧게 푼다. 제로샷은 평가 데이터셋용 미세조정 없이 맞히는 설정이다. GIFT-Eval은 다양한 주기·도메인의 시계열 예측 벤치다. CRPS는 확률 예측의 연속 순위 확률 점수, MASE는 스케일 보정 절대오차다. 둘 다 낮을수록 좋다. Conformer는 음성에서 쓰이던 블록으로, 멀티헤드 어텐션 옆에 시간 합성곱을 끼워 짧은 구간과 긴 구간을 나눠 본다.
IBM이 공식 글에서 반복하는 메시지는 단순하다. 점수가 비슷해도 라이선스가 막히면 프로덕션에 못 넣는다. PatchTST-FM-r2는 그 칸을 채우려고 나왔다.
주요 내용 분석
| 항목 | 내용 |
|---|---|
| 공개일 | 2026-09-09 (Hugging Face 블로그) |
| 주체 | IBM Research / Granite TSFM |
| 모델 ID | ibm-granite/granite-timeseries-patchtst-fm-r2 |
| 규모 | ~385M 파라미터 · 히든 1024 · 블록 30(r1은 20) |
| 패치 | 길이 16 · 스트라이드 8(50% 겹침) · Hamming 가중 · overlap-add 추론 |
| 컨텍스트 | 최대 8,192 |
| 출력 | 점 예측 + 99분위 확률 헤드 · 결측 대치(imputation) 지원 |
| 아키텍처 | Conformer 블록(어텐션+시간 합성곱, 커널 3·5 교차) |
| 라이선스 | Apache 2.0 또는 OpenMDW 1.0 (사용자 선택) |
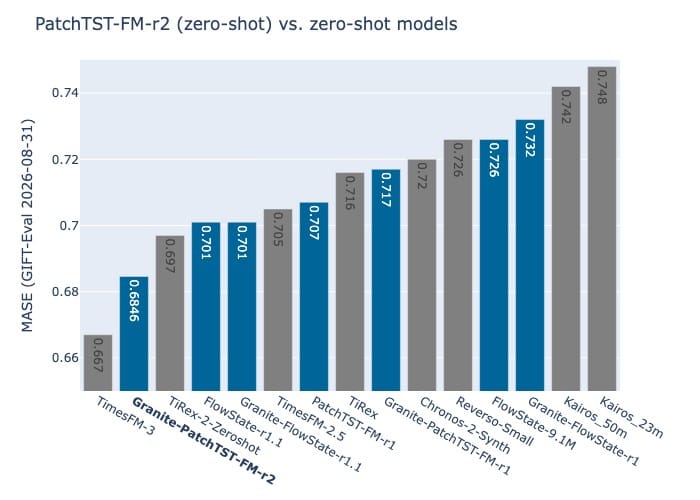
| 벤치 (제로샷·복제 가능) | CRPS 기하평균 0.467 · MASE 0.6846 · TimesFM-3 다음 · 퍼미시브 라이선스 1위 (2026-09-08 기준 블로그) |
| 서빙 | granite-tsfm>=0.3.9 · HF Pipeline · Confluent Cloud Early Access(스트리밍) |
GIFT-Eval 숫자 읽기
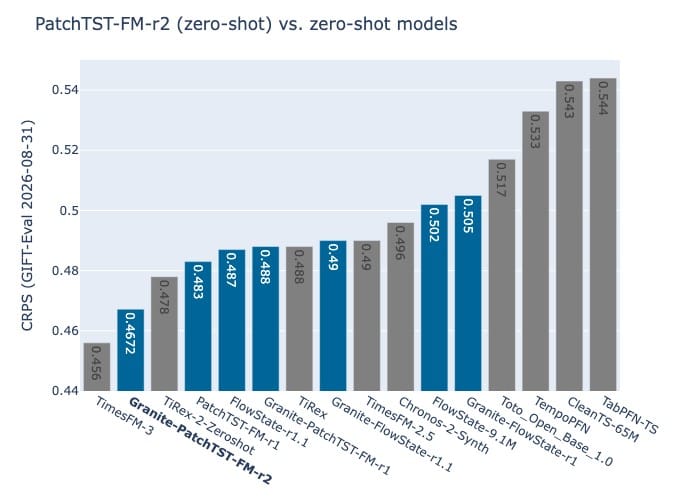
모델 카드 기준(2026-08-31 스냅샷) 제로샷·복제 가능·테스트 누수 제외 필터에서 PatchTST-FM-r2는 CRPS 0.4672로 TimesFM-3(0.456) 바로 뒤다. r1(0.483~0.488대)보다 명확히 올랐다. IBM 블로그는 9월 8일 시점에도 같은 순서를 유지한다고 적는다.
사전학습 허용 모델까지 넣으면 그림이 복잡해진다. TiRex-2-Pretrained·Toto 대형·Falcon 계열이 끼어든다. 그래도 r2는 CRPS 상위권에 남고, 공식 글은 Chronos-2·Timer-S1·Toto 변형 일부를 앞선다고 못 박는다.
r1에서 무엇이 바뀌었나
r2의 핵심은 “더 큰 트랜스포머”가 아니라 짧은 구간을 합성곱에 맡기고, 어텐션을 먼 관계에 쓰게 한 Conformer다. 블록 수는 20→30, 패치는 50% 겹침+Hamming 가중+overlap-add로 경계 들뜸을 줄인다. 결측 대치와 99분위 헤드는 “점 하나만 찍는 모델”이 아니라 불확실성·빈칸이 있는 실무 파이프라인용이라는 신호다.
학습 데이터도 문서화돼 있다. GiftEvalPretrain 일부, KernelSynth 변형 합성, Chronos식 TSMixup(단 GIFT-Eval 평가셋 제외), CauKer 합성 약 50만 시퀀스(길이 4,096). 벤치 학습 분할을 얼마나 봤는지가 논쟁인 분야에서, IBM은 “무엇을 넣었는지”를 카드에 남겼다.
코드 경로는 짧다.
pip install "granite-tsfm>=0.3.9"
# PatchTSTFMForPrediction.from_pretrained(
#   "ibm-granite/granite-timeseries-patchtst-fm-r2")
# + TimeSeriesForecastingPipeline
공식 예제는 ETTh1의 HUFL을 컨텍스트 512·예측 64·분위 0.1/0.5/0.9로 돌린다. 미세조정 없이 최근 구간만 넣는다.
실사용자 반응
공개 직후 반응은 세 갈래다. 첫째, “TimesFM-3를 못 이겼다” — CRPS 절대 1위는 여전히 Google 쪽이다. 둘째, “그래도 쓸 수 있는 라이선스” — Apache/OpenMDW 이중은 사내 법무가 통과시키기 쉬운 쪽이다. 셋째, 스트리밍 — IBM·Confluent Early Access가 PatchTST-FM-r1·FlowState·TTM·TSPulse를 Flink 경로에 올려 두었고, r2는 그 포트폴리오의 점수 업그레이드로 읽힌다.
모델 카드도 한계를 숨기지 않는다. GIFT-Eval 순위는 필터(제로샷·복제 코드·테스트 누수)에 민감하고, r2 결과는 벤치 쪽 PR pending으로 적혀 있다. 리더보드 스크린샷 한 장으로 “업계 1위”를 외치면 안 되는 이유다.
의미와 시사점
첫 번째, 시계열 파운데이션 경쟁이 ‘점수’와 ‘라이선스’ 두 축으로 갈라졌다. TimesFM-3가 제로샷 꼭대기를 지키면, IBM은 “퍼미시브 라이선스 최고” 칸을 가져가겠다는 전략이다. 두 번째, Conformer·겹침 패치·분위 헤드처럼 음성·신호처리에서 검증된 부품을 시계열에 다시 꽂는 흐름이 이어진다. 세 번째, 문서화된 사전학습 코퍼스가 엔터프라이즈 도입의 실제 병목(거버넌스)을 겨냥한다. 점수가 비슷하면 감사가 이긴다.
마치며
PatchTST-FM-r2의 메시지는 짧다. 절대 1위 트로피가 아니라, 법무가 통과시키는 2등이다. 385M, 8K 컨텍스트, 99분위, Apache/OpenMDW, GIFT-Eval 제로샷에서 TimesFM-3 다음. 수요·전력·트래픽·텔레메트리처럼 “매일 다시 학습하기 싫은” 시계열에, 일단 넣고 볼 만한 열린 가중치가 하나 더 생겼다.
출처
- Hugging Face Blog — IBM releases SOTA Granite Time Series PatchTST-FM-r2 (2026-09-09)
- Hugging Face — ibm-granite/granite-timeseries-patchtst-fm-r2
- GitHub — ibm-granite/granite-tsfm
- arXiv 2602.06909 — Revisiting the Generic Transformer…
이 글은 AI가 작성하여 자동 발행된 콘텐츠입니다.