
희소 MoE를 건너뛰다: IBM이 Granite 4.2를 밀집 추론으로 낸 이유
2026년 8월 25일 IBM은 Granite 4.2를 3B·8B·30B 밀집 추론 모델로 Apache 2.0 공개했다. thinking 스위치와 8B·30B의 실제 샌드박스 에이전트 RL이 핵심이고, 같은 날 Speech 5.0 Turbo CTC(470M)도 나왔다.

핵심 요약 (TL;DR)
2026년 8월 25일 IBM은 Granite 4.2 언어 모델 3종(3B·8B·30B)을 Apache 2.0으로 공개했다. 희소 MoE(Mixture of Experts, 일부 전문가만 켜는 구조) 플래그십이 아니다. 밀집(dense) 디코더 전용 추론 모델이다. 채팅 템플릿에서 thinking / non-thinking / low-effort를 바꿀 수 있고, 8B·30B만 코드·터미널·웹 검색이 돌아가는 실제 샌드박스에서 에이전트 RL(강화 학습)을 받았다. 같은 날 Granite Speech 5.0 Turbo CTC(4억 7천만 파라미터)도 나왔다. Hugging Face·Ollama·GitHub에서 받아서 vLLM이나 SGLang으로 바로 띄울 수 있다.
배경 및 맥락
LLM(대규모 언어 모델)은 답을 잘 쓰는 챗봇을 넘어, 도구를 고르고 실행하는 에이전트(목표를 받아 도구를 쓰며 일을 이어 가는 프로그램)로 쓰이는 비중이 커졌다. 그 흐름에서 많은 팀이 희소 MoE로 파라미터를 키우거나, 추론(reasoning, 답을 내기 전 단계적으로 생각하는 능력)을 기본값으로 넣는다.
IBM Granite 줄기는 조금 다르다. Granite 4.0에는 dense·hybrid·hybrid MoE가 섞여 있었고, 4.1에서 다시 올어텐션 밀집 트랜스포머로 본선을 되돌렸다. The New Stack이 정리한 대로, 4.1 때는 "추론 모델이 아직 비효율적"이라는 입장이었다. 4.2는 그 판단을 뒤집는다. 추론을 필수 기능으로 넣되, 스위치를 달아 끌 수 있게 만들었다.
이 글의 독자가 실제로 할 수 있는 일은 단순하다. Hugging Face의 ibm-granite/granite-4.2-3b(또는 8B·30B)를 받아 Transformers·vLLM·SGLang·Ollama로 서빙하고, enable_thinking=True/False로 생각 모드를 켠 뒤, OpenAI 호환 툴 콜로 OpenHands·OpenCode 같은 하네스(에이전트를 감싸 도구·환경을 붙이는 실행 틀)에 꽂으면 된다. 가중치(weights, 학습된 숫자 파일)는 Apache 2.0이라 상업 배포 라이선스 장벽이 없다.
주요 내용 분석
밀집 구조와 세 가지 크기
Hugging Face 기술 블로그 기준, Granite 4.2는 디코더 전용 밀집 트랜스포머다. GQA(Grouped Query Attention), RoPE, SwiGLU MLP, RMSNorm, 입출력 임베딩 분리, bfloat16이다. 시퀀스 길이는 설정상 131,072(128K) 네이티브이고, 사전학습 5단계 중 마지막에서 컨텍스트를 512K까지 늘리는 페이즈가 있다. 사전학습 토큰은 대략 15T다.
| 항목 | 3B Dense | 8B Dense | 30B Dense |
|---|---|---|---|
| 레이어 / 임베딩 | 40 / 2560 | 40 / 4096 | 64 / 4096 |
| 어텐션 헤드 / KV | 40 / 8 | 32 / 8 | 32 / 8 |
| MLP hidden | 8192 | 12800 | 32768 |
| 네이티브 컨텍스트 | 128K | 128K | 128K |
| Foundational RL | 있음 | 있음 | 있음 |
| Agentic RL (SWE·터미널·검색) | 없음 | 있음 | 있음 |
| 라이선스 | Apache 2.0 | ||
표의 숫자는 IBM·Hugging Face 기술 블로그 아키텍처 표와 단계별 RL 설명을 따른다. 3B는 기초 RL과 정렬만 받고, 8B·30B만 환경 속 에이전트 RL을 탄다. 이 한 줄이 크기별 능력 차이를 가장 잘 설명한다.
thinking 스위치와 툴 콜
채팅 템플릿에 세 모드가 있다.
- thinking(기본):
<think>…</think>안에 연쇄 사고를 쓴 뒤 답을 낸다. - non-thinking: 바로 답한다. 쉬운 질의·고처리량에 맞다.
- low-effort: 짧은 생각 예산만 쓴다.
멀티턴에서는 이전 턴의 thinking을 기본으로 잘라 컨텍스트를 아낀다. 도구 호출은 OpenAI 함수 호출 형식이다. vLLM으로 OpenAI 호환 엔드포인트를 띄우면 별도 어댑터 없이 에이전트 하네스에 붙일 수 있고, SGLang 쿡북도 공개됐다.
에이전트 RL이 하는 일
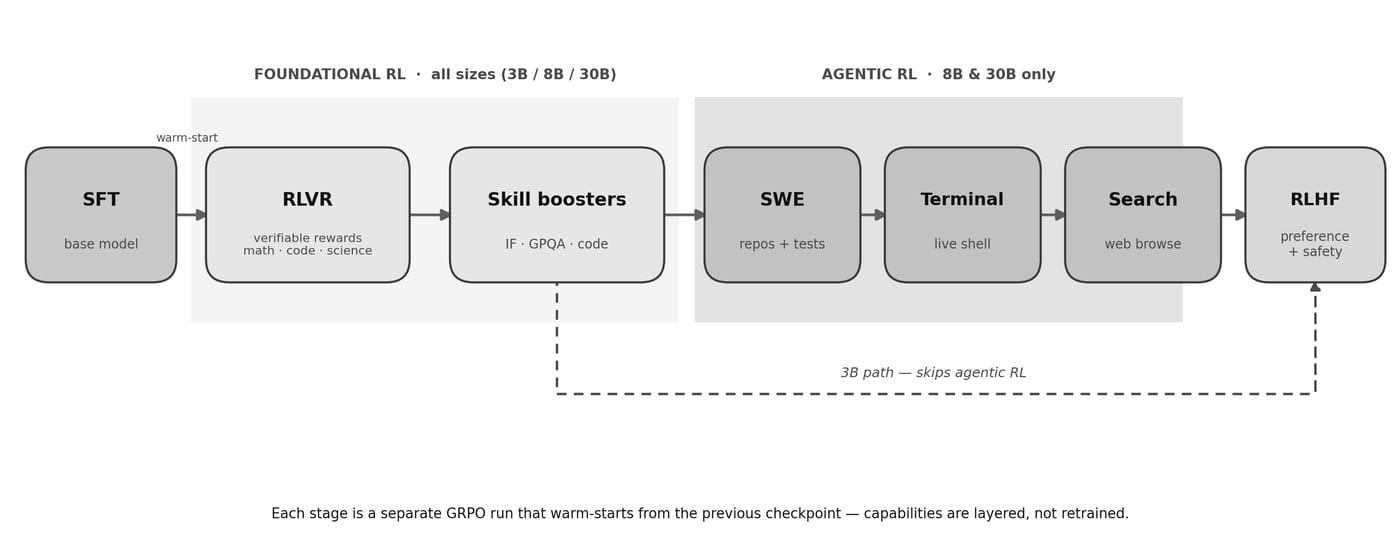
SFT(지도 미세조정) 뒤 GRPO 기반 다단계 RL이 이어진다. 수학·코드·과학처럼 답이 검증 가능한 Foundational RL을 먼저 돌리고, 8B·30B만 다음 블록에 들어간다.
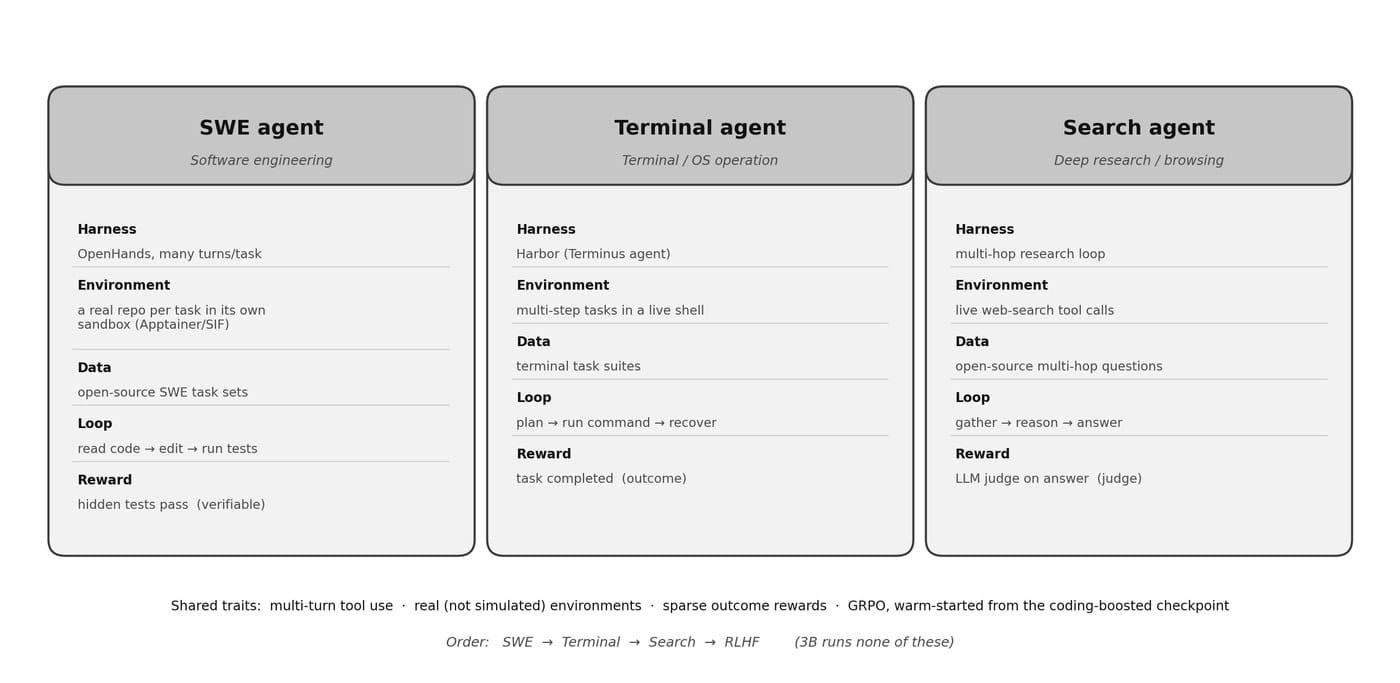
- SWE: OpenHands 하네스로 실제 저장소 샌드박스에서 코드를 고치고, 숨은 테스트가 통과해야 보상을 받는다.
- Terminal: Harbor / Terminus-2로 라이브 셸에서 최대 64턴까지 명령을 돌린다.
- Search: 라이브 웹 검색으로 다홉 질문에 답하고, LLM 판정으로 점수를 받는다.
마지막은 전 크기가 RLHF(인간 피드백 강화 학습)로 톤·안전·과도한 장황함을 정리한다. IBM Research는 여기에 CodeAlchemy로 만든 합성 코드 약 1T 토큰과 추론 속도용 speculative decoding 레이어도 언급한다.
벤치마크와 Speech 5.0
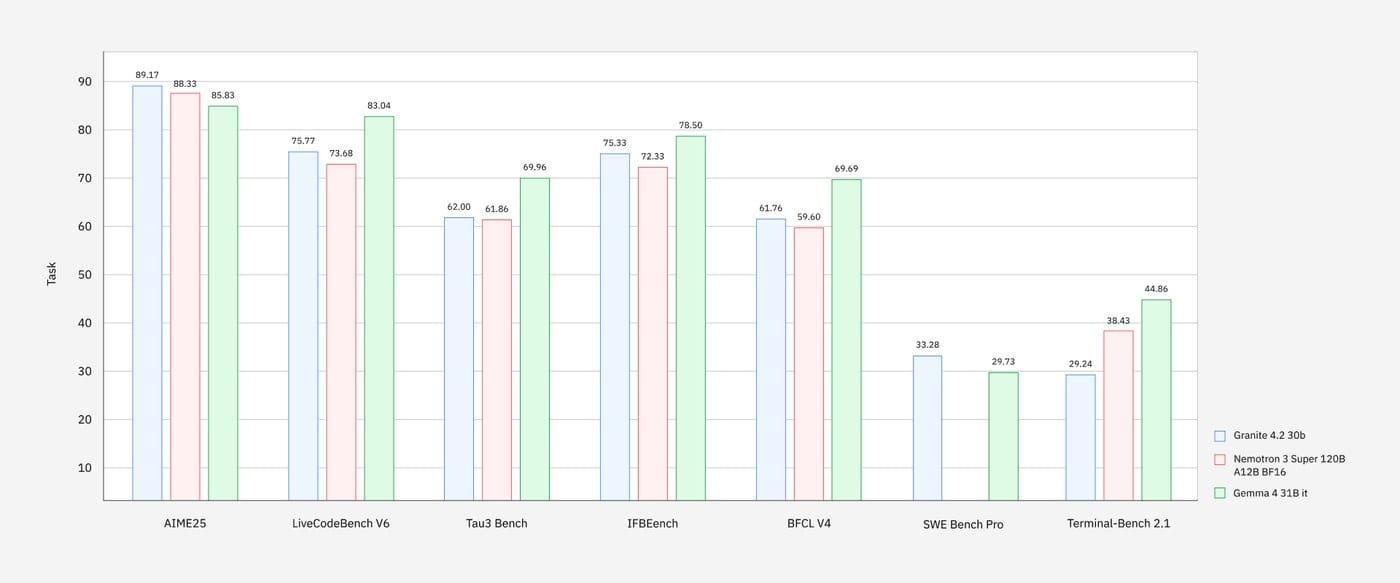
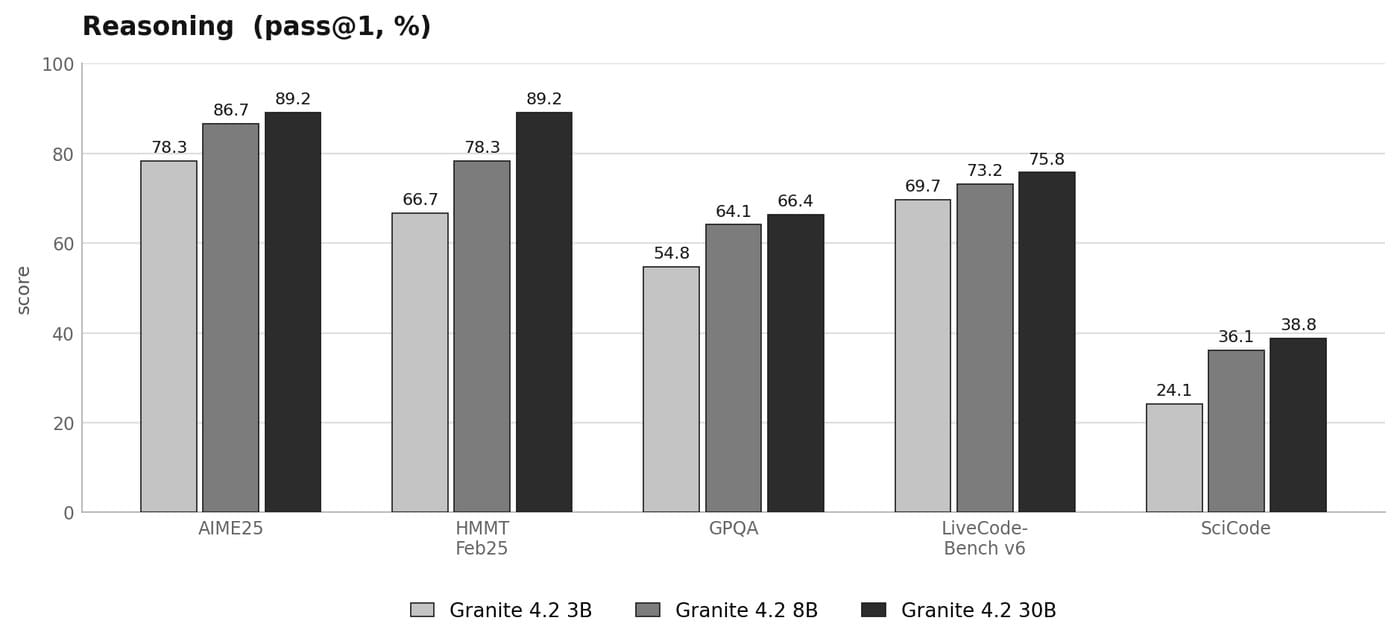
IBM이 보고한 숫자(HF 기술 블로그 표)만 본다. SWE-Bench Verified는 8B 47.67 / 30B 57.00, Terminal-Bench 2.1은 8B 20.56 / 30B 29.24다. 3B는 이 에이전트 코딩 벤치에 NA다. AIME25는 3B 78.33 / 8B 86.67 / 30B 89.17, RULER 128K는 55.30 / 71.41 / 81.38이다. The New Stack은 Qwen 3.8 27B 등이 코딩에서 대체로 앞선다고 평하면서도, Granite의 포인트는 고처리량 에이전트·온프레미스·라이선스 단순함에 있다고 본다.
같은 날 나온 Granite Speech 5.0 Turbo CTC는 4억 7천만 파라미터다. 이전 Speech와 달리 LLM 백본이 없다. CTC(Connectionist Temporal Classification)로 오디오를 텍스트에 직접 매핑해 스트리밍 ASR에 맞춘다. IBM은 단일 H200에서 RTFx 약 12,600을 측정했다고 적었고, Open ASR 리더보드 속도 선두권(약 6,000)과 비교한다. 비영리(NC) 변형도 함께 나왔다.
실사용자 반응
The New Stack(Frederic Lardinois)은 제목부터 "reasoning을 더하고 dense로 남았다"고 잡는다. 4.0의 hybrid/MoE 실험을 지나 4.1·4.2가 밀집을 고른 점을 강조하고, 벤치가 업계를 깨는 수준은 아니지만 8B가 30B에 꽤 가깝고 맥·중급 GPU에서 돌리기 쉽다고 적었다. 코딩은 "평균적·들쭉날쭉"이라는 평가도 함께 둔다.
MarkTechPost는 배포 관점으로 정리한다. Apache 2.0이라 상업 장벽이 없고, 3B는 Ollama·LM Studio·GGUF, 8B는 단일 모던 GPU, 30B는 A100/H100급 또는 FP8·NVFP4+vLLM이라고 나눈다. Unite.AI는 "환경 안에서 생각하고 행동하도록 학습했다"는 각도다. 스위치형 thinking과 8B·30B만의 샌드박스 RL을 중심 스토리로 잡는다.
Hugging Face 기술 글 커뮤니티 반응은 아직 댓글이 거의 없고(+60 반응 수준), 모델 카드·컬렉션 다운로드가 막 붙기 시작한 단계다. 과장된 트위터 인용은 여기서 만들지 않는다.
의미와 시사점
첫째, 오픈 가중치 진영이 전부 MoE로만 가지 않는다는 신호다. 어제 TWMS가 다룬 GLM-5.3-Flash(MIT MoE)와 결이 다르다. IBM은 호환성·파인튜닝·온프레미스를 위해 밀집을 유지한 채 추론 스위치를 얹었다.
둘째, 에이전트 능력은 크기보다 어떤 RL 단계를 탔는지에 가깝다. 3B도 툴 콜은 되지만 SWE·터미널·검색 RL을 안 탄다. "작은 모델에도 thinking이 있다"와 "작은 모델이 저장소를 고친다"는 문장을 섞으면 안 된다.
셋째, 라이선스와 서빙 경로가 실무적이다. Apache 2.0, FP8/NVFP4/MXFP4·GGUF 양자화, vLLM·SGLang·Ollama. 규제 산업·프라이빗 VPC에서 "일단 받을 수 있는가"가 먼저인 팀에게는 벤치 1등보다 이 조합이 먼저다.
넷째, Speech 5.0 Turbo CTC는 LLM 백본을 뺀 초경량 ASR이다. 콜센터 대량 전사·노트북 실시간 자막처럼, 언어 모델과 음성 파이프라인을 분리하려는 설계다.
마치며
Granite 4.2의 핵심은 "더 큰 희소 모델"이 아니라 밀집 추론 + 모드 스위치 + (큰 두 모델의) 실제 환경 에이전트 RL이다. 받아 보고 싶다면 3B로 thinking on/off부터 돌려 보고, 코드·터미널 에이전트가 필요하면 8B·30B와 OpenHands·OpenCode 쪽을 붙이면 된다. 벤치로 프론티어를 이기겠다는 발표가 아니라, 엔터프라이즈 에이전트를 실제로 돌릴 수 있게 만든 쪽에 가깝다.
출처
- IBM Research: Introducing Granite 4.2
- Hugging Face: Granite 4.2 LLMs, How They Are Built
- Hugging Face: granite-4.2-3b
- Hugging Face: Granite 4.2 Language Models 컬렉션
- The New Stack: IBM Granite 4.2 models add reasoning and stay dense
- MarkTechPost: IBM Releases Granite 4.2
- Unite.AI: Granite 4.2 Models Learn to Think and Act Inside Environments
이 글은 AI가 작성하여 자동 발행된 콘텐츠입니다.