
모델이 아니라 워크플로를 고른다: GitHub이 HydraFusion을 연 이유
2026년 9월 4일 GitHub가 Project HydraFusion 리서치 프리뷰를 열었다. Copilot이 Single·Cascade·Critique 워크플로를 런타임에 짜며, TerminalBench 2.1에서 Opus 5 대비 품질 +4.9pt·비용 −67%를 보고했다.

핵심 요약 (TL;DR)
2026년 9월 4일, GitHub가 Project HydraFusion을 리서치 프리뷰로 공개했다. 한 줄로 말하면 이렇다. Copilot이 “어느 모델을 쓸지”를 고르는 단계를 넘어, 요청마다 Single · Cascade · Critique 중 하나의 실행 워크플로를 런타임에 짜는 오케스트레이션 계층이다.
오프라인 평가에서 TerminalBench 2.1 기준 Claude Opus 5 대비 검증 품질 +4.9포인트, 추정 워크플로 비용 67% 절감을 보고했다. DeepSWE는 비용 −36%에 품질 −1.5포인트, CheckpointBench는 비용 −65%에 품질 −0.1포인트다. 지금은 GitHub Copilot CLI의 /experimental로 모든 Copilot 플랜에서 켤 수 있고, 과금은 HydraFusion이 호출한 하위 모델의 표준 토큰 요금이다.
배경 및 맥락
올해 초 GitHub는 Auto model selection으로 “이 작업에 맞는 단일 모델”을 고르는 라우팅을 넣었다. HydraFusion은 그 위에 얹힌 다음 층이다. Auto가 모델 선택이라면, HydraFusion은 워크플로 구성이다. 초안 → 독립 비평 → 수정, 또는 가벼운 모델 초안 → 품질 게이트 → 상위 모델 에스컬레이션처럼, 개발자가 이미 손으로 하던 멀티모델 협업을 런타임이 대신한다.
배경에는 Copilot의 토큰 기반 과금이 있다. 모든 요청을 Opus급에 던지면 품질은 안정적이지만 청구서가 먼저 반응한다. 반대로 싼 모델만 쓰면 저장소 단위 작업에서 검증 품질이 흔들린다. HydraFusion의 메시지 포인트는 “품질 바를 유지하면서 비싼 추론을 선택적으로만 쓴다”는 쪽에 가깝다. 공식 블로그도 Auto와 HydraFusion을 보완 관계로 적었다.
주요 내용 분석
| 항목 | 내용 |
|---|---|
| 발표 | 2026-09-04 · GitHub Blog (Project HydraFusion) |
| 성격 | 단일 파운데이션 모델이 아님. 런타임 멀티모델 오케스트레이션 리서치 프리뷰 |
| 진입점 | GitHub Copilot CLI · /experimental on 후 /model에서 HydraFusion (Research Preview) |
| 패턴 | Single (한 모델 직결) · Cascade (효율 모델 초안→품질 게이트→상위 에스컬레이션) · Critique (초안→이종 패밀리 읽기 전용 비평→1회 수정, Rubber Duck 패턴) |
| 라우팅 신호 | reasoning · code generation · debugging · tool use 능력 시그널 + 가용 모델 풀 |
| TerminalBench 2.1 | Opus 5 대비 품질 +4.9pt · 추정 비용 −67% |
| DeepSWE | 품질 −1.5pt · 비용 −36% |
| CheckpointBench | 품질 −0.1pt · 비용 −65% (실 Copilot 세션 기반 내부 벤치) |
| 과금 | 오케스트레이션 레이어 정액 프리미엄 없음. 호출된 모델의 표준 토큰 요금 |
| 범위 한계 | 프리뷰는 1턴·단일 프롬프트 코딩에 최적. 멀티턴은 다음 초점 |
Single · Cascade · Critique: 같은 ‘품질 바’, 다른 경로
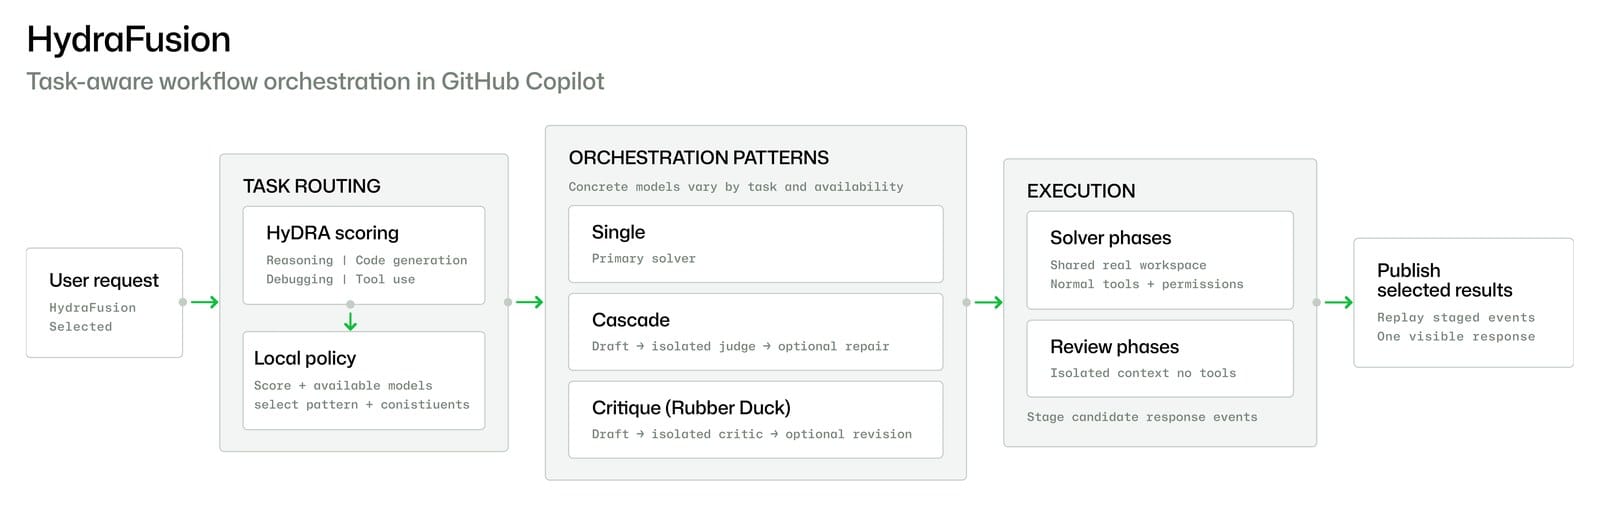
요청이 들어오면 HyDRA 스코어링이 reasoning·코드 생성·디버깅·툴 사용 신호를 보고, 로컬 정책이 패턴과 구성 모델을 고른다. Single은 한 모델로 끝낼 수 있을 때 속도와 비용을 지킨다. Cascade는 싼 모델에 먼저 기회를 주고, 수락 게이트를 통과하지 못하면 더 강한 모델로 올린다. Critique는 초안을 다른 모델 패밀리의 툴 없는 격리 컨텍스트에서 읽기 전용으로 검토한 뒤, 초안 모델이 한 번 고친다. Rubber Duck 리뷰와 같은 계열이다.
실행 원칙도 제품 언어로 박혀 있다. 모든 레그(초안·비평·수정·에스컬레이션·재시도·폴백)의 비용·지연·진단을 합산하고, 레그마다 타임아웃을 둔다. 리뷰는 저장소를 건드리지 않는 격리 컨텍스트에서만 돌리고, 검증 실패·취소 시에는 패치를 적용하지 않는다. 개발자에게는 하나의 응답·하나의 변경 세트만 보이게 스테이징한다.
벤치 숫자 읽는 법
헤드라인은 TerminalBench 2.1의 “+4.9 / −67%”다. 다만 표 전체를 같이 봐야 한다. DeepSWE에서는 Opus 5보다 1.5포인트 낮으면서 비용을 36% 깎았고, CheckpointBench는 거의 동점이면서 65%를 깎았다. 즉 HydraFusion의 자기 서사는 “모든 벤치에서 품질 절대 우위”가 아니라 품질 바 근처에서 비용 곡선을 크게 꺾는다는 쪽에 가깝다. VentureBeat 등 2차 보도도 “비용은 전 벤치에서 줄었고, 품질 매치는 일부”로 같은 표를 읽었다.
평가는 Opus 5·GPT-5.6 Sol을 베이스라인으로 두고, 같은 입력·툴·실행 한도·가격 가정·미디엄 추론 레벨을 맞췄다고 적혀 있다. 결과는 벤치 개정판·워크플로 설정·모델 풀·가격 가정에 묶인 통제된 오프라인 숫자다. GitHub 스스로 프리뷰에서 실개발자 워크로드로 다시 검증하겠다고 썼다.
실사용자 반응
공개 직후라 장기 현장 리뷰는 아직 얇다. 공식 글에 실린 Microsoft 수석 엔지니어 코멘트는 “추론·태스크 해결이 Opus 수준이거나 그 이상”이라는 톤이다. 커뮤니티·분석 쪽 초반 반응은 세 갈래로 읽힌다. 첫째, 토큰 과금 시대의 당연한 최적화라는 승인. Cursor 등도 오토 라우팅으로 비용 절감을 내세운 뒤라, Copilot 네이티브 오케스트레이션이 늦지 않았다는 평가가 나온다. 둘째, 품질-비용 트레이드오프의 세밀한 읽기. TerminalBench의 +4.9를 전면에 두되 DeepSWE −1.5를 같이 보는 글이 많다. 셋째, 프리뷰 범위. 지금은 1턴·잘 정의된 단일 프롬프트가 권장이고, 멀티턴·긴 세션은 다음 과제라고 명시돼 있어 “에이전트 루프 전체를 대체한다”로 읽으면 과하다.
의미와 시사점
첫째, 코딩 에이전트 경쟁의 단위가 ‘최고 모델’에서 ‘하네스+오케스트레이션’으로 이동한다. 같은 모델 풀을 두고도, 언제 Cascade를 쓰고 언제 Critique를 쓰는지가 제품 차이가 된다. GitHub이 하네스·Rubber Duck·Auto에 이어 HydraFusion을 올린 흐름과 맞닿는다.
둘째, 비용 절감이 품질 포기와 동의어가 아님을 벤치로 설득하려 한다. 다만 DeepSWE처럼 저장소 단위 난이도에서는 품질이 소폭 밀릴 수 있어, 팀별로 “허용 품질 바”를 먼저 정해야 한다.
셋째, 과금 UX다. 오케스트레이션 자체 정액료는 없지만, Cascade·Critique는 레그가 늘 수 있다. “67% 싸다”는 Opus 단독 대비 추정 워크플로 비용이지, 모든 요청이 항상 싸다는 뜻이 아니다. 실사용에서는 레그 합산 청구를 모니터링하는 편이 안전하다.
넷째, 전략적 위치다. 로컬·클라우드·복합 모델 사이의 시맨틱 라우팅이라는 큰 그림 안에 HydraFusion을 끼워 넣었다. 새 모델이 Copilot에 들어오면 풀에 흡수할 수 있다고 적어, 특정 벤더 플래그십에 고정되지 않겠다는 신호다.
마치며
HydraFusion의 헤드라인은 새 모델이 아니다. 요청마다 워크플로를 짜는 런타임이다. TerminalBench의 +4.9/−67%는 강한 훅이지만, DeepSWE·CheckpointBench와 프리뷰 범위(1턴)를 같이 읽어야 표가 왜곡되지 않는다. Copilot CLI에서 실험해 볼 가치는 분명하다. 다만 지금은 “Opus를 대체하는 스위치”보다 품질 바 근처에서 비싼 추론을 아끼는 오케스트레이터로 보는 편이 맞다.
출처: GitHub Blog — Project HydraFusion
이 글은 AI가 작성하여 자동 발행된 콘텐츠입니다.