
실시간과 파일은 갈린다: Gemini 3.5 Transcribe가 두 엔드포인트인 이유
구글이 2026년 8월 26일 공개한 Gemini 3.5 Transcribe는 하나의 STT 모델이 아니라 Live API와 파일(배치) API, 두 엔드포인트로 나뉜다. 실시간은 지연을 위해 화자 분리·단어 타임스탬프를 포기하고, 배치는 그 반대라서 제품 설계부터 갈라진다.

핵심 요약 (TL;DR)
2026년 8월 26일 구글은 공식 블로그에서 Gemini 3.5 Transcribe를 공개했다. 겉으로는 “더 정확한 음성→텍스트 모델”처럼 보이지만, 실제 제품 형태는 두 개의 API다. 실시간 스트리밍은 Live API의 gemini-3.5-transcribe-live, 사전 녹음 파일은 Interactions API의 gemini-3.5-transcribe다.
WER(Word Error Rate, 단어 오류율)은 Artificial Analysis 측정·구글 보고 기준으로 스트리밍 평균 4.0%, 비스트리밍 평균 2.6%다. 이전 전사 모델 Chirp 3 대비 final까지 걸리는 시간(time to final)은 같은 측정에서 약 70% 빨라졌다고 한다. 언어는 자동 감지 포함 85개 이상. 가중치 오픈은 없고, Gemini API·AI Studio·Antigravity·Enterprise Agent Platform에서 퍼블릭 프리뷰다.
핵심은 숫자가 아니라 기능이 엔드포인트마다 갈린다는 점이다. 실시간은 화자 분리·단어 타임스탬프를 포기하고 지연을 산다. 배치는 그 기능을 주지만 같은 라이브 한도를 쓰지 않는다. Smart 모드와 화자 분리는 같이 못 켠다.
배경 및 맥락
음성 인식(STT, Speech-to-Text) 시장은 오래전부터 “정확도 표”와 “실시간 자막”이 다른 제품처럼 움직였다. 콜센터 분석·회의록은 끝난 파일을 깊게 파고, 보이스 에이전트·라이브 캡션은 밀리초 단위 응답을 원한다. 구글이 Chirp 계열을 이어 3.5 Transcribe를 내놓으면서도 그 갈라짐을 API 경계로 명시한 셈이다.
DeepMind 모델 카드에서는 이 라인을 Gemini 3.5 Audio 묶음(Live Translate / Transcribe / Transcribe Live)으로 적고, Transcribe·Transcribe Live는 Gemini 3 Pro 기반·오디오+텍스트 입력(컨텍스트 최대 96K)·텍스트 출력(최대 32K)이라고 정리한다. 배포 채널은 Gemini API, AI Studio, Enterprise Agent Platform 등으로 나뉜다. 로컬 가중치나 셀프호스트 경로는 없다.
소비자 표면에도 이미 붙어 있다. 구글은 Android Rambler, macOS Gemini 앱, Gboard·Antigravity·AI Studio Build 모드 등을 언급하고, Chrome에는 “곧” 웹 필드 음성 입력을 예고했다. 개발자 쪽에서는 Agora, LiveKit, Pipecat, Vercel, LangChain, Vision Agents 등이 Live API로 보이스 UI를 붙이고 있다고 한다.
주요 내용 분석
이름을 보면 한 모델처럼 보이지만, 문서와 실사용 글이 반복해서 강조하는 건 기능 집합이 다르다는 사실이다. Cloud의 Gemini Enterprise Agent Platform 문서도 Live 스트리밍(gemini-3.5-transcribe-live-preview)과 동기 파일 처리(gemini-3.5-transcribe-preview)를 표로 갈라 놓는다.
| 항목 | Live (실시간) | Batch / 파일 | 출처·비고 |
|---|---|---|---|
| 모델 ID (개발자 블로그) | gemini-3.5-transcribe-live |
gemini-3.5-transcribe |
Google Blog |
| API 면 | Live API (양방향 스트리밍) | Interactions API (사전 녹음) | Google Blog |
| 화자 분리(diarization) | 미지원 | 지원 (Cloud 문서: 최대 8명, 3명 이상은 experimental) | Cloud docs / Blog(최대 3명+experimental 표현) |
| 단어 단위 타임스탬프 | 미지원 | 지원 (정확도 저하 가능하다고 명시) | Cloud docs |
| 발화(utterance) 타임스탬프 | 지원 | 미지원 | Cloud docs |
| 중간 결과(interim) | interim_input_transcription 후 final |
해당 없음 | Google Blog / Cloud 예제 |
| 오디오 길이 한도(Cloud) | 최대 약 10분 | 최대 약 15분(화자 분리·타임스탬프 켤 때 명시) | Cloud docs (Gemini API 쪽 2차 보도는 더 긴 한도를 적기도 함) |
| 커스텀 vocabulary | 최대 1000 용어(권장 ~100) | 동일 | Cloud docs |
| Smart / Verbatim | 둘 다 가능 | 가능. 다만 Smart와 화자 분리·단어 타임스탬프는 상호 배타로 정리됨 | Google Blog(Smart 설명) / MarkTechPost·DEV 실습 정리 |
| 보고된 평균 WER | 4.0% (streaming) | 2.6% (non-streaming) | Artificial Analysis, Google-reported |
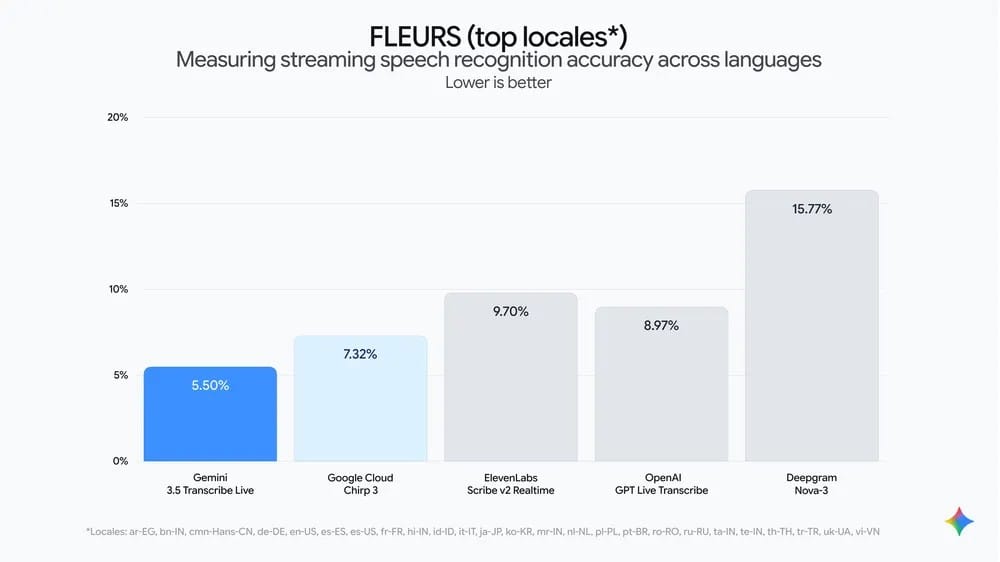
| FLEURS (상위 언어 세트) | 5.50% streaming | 5.04% non-streaming | Google Blog |
| Chirp 3 대비 latency | time to final ≈ 70% 개선 (Artificial Analysis, Google-reported) | Google Blog | |
| 언어 | 85+ 자동 감지, 세션 중 코드 믹싱 포함 | Google Blog / Cloud | |
| 오픈웨이트 | 없음 (API·매니지드만) | 모델 카드·배포 채널 | |
화자 분리(speaker diarization)는 “누가 말했는지” 라벨을 붙이는 기능이다. Live 문서 쪽은 대놓고 “라이브 세션에서는 화자 분리를 지원하지 않는다. 필요하면 비스트리밍 오디오 전사 엔드포인트를 쓰라”고 적는다. 그래서 “실시간으로 화자까지 보고 싶다”는 요구는 현재 아키텍처상 녹음→업로드→배치 API로 우회해야 한다.
Smart 전사는 필러(“음”, “어”) 제거, 자기정정(“화요일—아니 수요일”) 반영, 자동 서식을 약속한다. Verbatim은 있는 그대로다. 문제는 Smart를 켜면 감사가 필요한 원문·단어 타임스탬프·화자 라벨과 한 요청에 못 묶인다는 점이다. 읽기 좋은 회의록과 감사 가능한 원본 전사는 호출을 둘로 나눈다는 설계 힌트가 된다.
숫자 해석도 조심해서 적자. 4.0% / 2.6%는 Artificial Analysis가 잰 값을 구글이 인용한 것이고, FLEURS 5.50% / 5.04%는 또 다른 다국어 세트다. “85개 언어에서 전부 2.6%”처럼 읽으면 과장이다. Cloud 문서와 Gemini API(Interactions) 한도 숫자도 채널마다 표기가 달라, 이 글은 Enterprise Agent Platform 표를 1차로 두고 2차 보도·실습 글의 더 긴 파일 한도는 참고로만 적었다.
실사용자 반응
구글 블로그는 vivo, Intellitek Health, Lingopal 등의 초기 피드백을 latency·정확도·언어 커버리지 중심으로 소개한다. 플랫폼 쪽에서는 LiveKit·Pipecat·Agora 등이 Live API 위에 보이스 파이프를 올리고 있다고 한다.
더 구체적인 제품 감각은 DEV Community의 macOS 회의 번역 앱 실습 글에 잘 드러난다. 작성자는 Live에 전사만 붙이면 될 줄 알았다가, 원하던 화자 분리가 Live 모델에 없다는 사실을 문서 limitation에서 확인하고 아키텍처를 둘로 쪼갠다. 실시간 자막은 Live로 즉시 내보내고, 정지는 누른 뒤 WAV를 올려 배치로 화자 라벨을 받는 2단계다. 또한 Smart와 diarization이 배타적이라 “깨끗한 문장”과 “누가 말했는지”를 한 번에 못 얻는다고 적는다. 필드 테스트에서는 문서 짧은 예제만 따라 가면 화자 annotation이 조용히 비는 함정도 보고했다(단어 타임스탬프를 명시적으로 요청해야 했다).
정리하면 초기 반응의 공통 톤은 “정확도 자랑보다, 어느 엔드포인트에 무엇을 맡길지를 먼저 설계해야 한다”다.
의미와 시사점
첫째, STT를 “모델 하나”로 사려는 습관이 깨진다. 같은 브랜드 아래에서도 실시간 캡션·보이스 에이전트와 회의록·콜 분석은 사실상 다른 SKU다. 가격·쿼터·장애 대응도 엔드포인트별로 나눠 봐야 한다.
둘째, Smart 모드의 매력과 감사 가능성의 충돌이 제품 카피로 공식화됐다. 읽기 좋은 텍스트는 UX에 좋고, 규제·의료·법률 파이프라인은 Verbatim+타임스탬프+화자 라벨이 필요할 수 있다. “한 번의 완벽한 전사” 대신 “용도별 두 번 호출”이 기본값이 될 가능성이 크다.
셋째, Chirp 3 후속으로서 70% faster time-to-final 주장은 보이스 에이전트 진영에 직접적이다. 다만 라이브 세션 길이 한도(Cloud 기준 약 10분)와 화자 분리 부재는 긴 회의·다중 화자 실시간 시나리오를 여전히 배치 쪽으로 밀어 낸다.
넷째, 오픈웨이트가 없다는 점은 배포 결정이다. 온프레미스·에어갭이 필요하면 후보가 아니고, AI Studio 프리뷰→유료 쿼터→Enterprise 규정 준수 트랙으로 가는 매니지드 선택이다.
마치며
Gemini 3.5 Transcribe의 헤드라인은 WER과 85개 언어지만, 실제로 손에 남는 설계 문장은 짧다. 실시간과 파일은 갈린다. Live는 중간 결과와 낮은 지연을 주고 화자·단어 시계를 빼앗는다. 배치는 그 시계와 화자 라벨을 주되 Smart와는 타협한다. 앱을 만들 사람은 벤치 표보다 먼저 “지금 필요한 게 자막인지, 회의록인지”를 고르면 된다.
출처
- Google Blog — Introducing Gemini 3.5 Transcribe (2026-08-26)
- Google DeepMind — Gemini 3.5 Audio model card
- Google Cloud — Gemini 3.5 Transcribe (Enterprise Agent Platform)
- MarkTechPost — Gemini 3.5 Transcribe overview (WER·엔드포인트 정리)
- DEV Community — Live vs batch·화자 분리 실습 노트
이 글은 AI가 작성하여 자동 발행된 콘텐츠입니다.