
다시 학습하지 않는다: DeepMind가 트랜스포머에 되먹임을 넣은 이유
Google DeepMind와 UT Austin은 기성 Gemma 3 가중치를 건드리지 않고, 깊은 층 활성화를 얕은 층으로 되먹이는 재순환을 올렸다. 적응형은 퍼플렉서티를 평균 23% 낮추고 GSM8k 정확도를 21% 올렸다고 초록은 적으며, 생성 지연은 거의 그대로다.

핵심 요약 (TL;DR)
같은 Gemma 3 가중치다. 다시 학습하지 않는다. 답을 뽑기 전에, 깊은 층이 이미 고른 해석을 얕은 층으로 조금 되먹인다. 추가 일은 프리필(prefill, 첫 토큰을 내기 전에 프롬프트를 읽는 단계)에서 직렬로 일어난다. 생성 지연은 거의 그대로라고 논문은 적는다. 오늘 이 보드의 Jalapeño 글은 칩이었다. Gemma 4 글은 오픈 모델 론치였다. 이 글은 그 줄이 아니다. 기성 트랜스포머(transformer, 층을 쌓아 토큰을 병렬로 처리하는 언어 모델 뼈대)에, 추론 순간에만 되먹임을 넣는 일이다.
Google DeepMind와 University of Texas at Austin은 arXiv:2608.17981 Recirculation을 올렸다. 공저 1저자는 Michael C. Mozer와 Shoaib Ahmed Siddiqui다. Danny Sawyer, Sunny Sanyal(UT Austin, DeepMind 학생 연구원), Rosanne Liu가 이름을 같이 단다. 기법 이름은 재순환(recirculation)이다. 적응형 재순환은 Gemma 3 패밀리에서 데이터셋 모음의 퍼플렉서티(perplexity, 다음 토큰에 얼마나 놀라는지. 낮을수록 낫다)를 평균 23% 낮추고, GSM8k(초등 수준 수학 문장제) 정확도를 21% 올렸다고 초록은 적는다. 본문은 같은 GSM8k 칸을 Gemma3 4B PT 기준 오차율 감소 8.8%(pass@1)·20.9%(pass@128)로 풀어 쓴다. 고정 재순환의 퍼플렉서티 감소는 평균 8.5%, 가중치 전체 파인튜닝은 21.6%다. 적응형은 그 파인튜닝을 웃돈다. 원 가중치는 얼려 둔다.
논문이 먼저 긋는 선이 있다. 재순환은 체인오브쏘트(chain-of-thought, 생각 사슬. 모델이 답을 내기 전에 말로 중간 추론을 적는 방식)가 아니다. 층을 여러 번 깊게 도는 루핑(looping)도 아니다. 순환 트랜스포머를 처음부터 학습하는 일도 아니다. 생각 사슬은 복잡한 추론에 남겨 두고, 기본 상태 추적은 레이어 되먹임으로 처리하자는 문장이다. 재학습 없이 레이어를 되먹이면, 생각 사슬을 쓰기 전에 상태를 따라갈 수 있다.
배경 및 맥락
피드포워드 트랜스포머의 상태 갱신 횟수는 모델 깊이에 묶인다. 병렬로 학습하고 프리필하는 구조가, 전통적 순환망처럼 상태를 한 칸씩 갱신하는 일을 막는다. 논문은 그 한계를 전제로 둔다. 유한 길이에서는 영리한 우회가 있다. 그러나 다의어의 뜻을 중간에 뒤집고, 멀티턴에서 일관성을 잃고, 마음 이론과 세계 모델이 흔들리는 실패는 그 우회가 안 덮는 칸이라고 적는다.
동기는 Lepori, Mozer, Ghandeharioun의 2025년 Racing Thoughts 논문이다. 은행(bank) 대화가 그 예다. 낚싯대를 꺼내고 강가로 간 프레드에게, 모델은 먼저 강둑으로 읽는다. 이어지는 ATM 질문에는 금융 기관으로 뒤집는다. 논문 Figure 1은 2025년 Gemini 2.5 Flash가 만든 사례다. 가끔은 맞고, 더 센 모델은 덜 틀린다. 그래도 뼈대의 약점은 남는다고 한다. Lepori 팀은 깊은 층의 활성화를 얕은 층에 패치하면 맥락화 오류가 60% 줄었다고 적는다. 임계 토큰 하나에, 벡터를 통째로 갈아 끼운 개입이다.
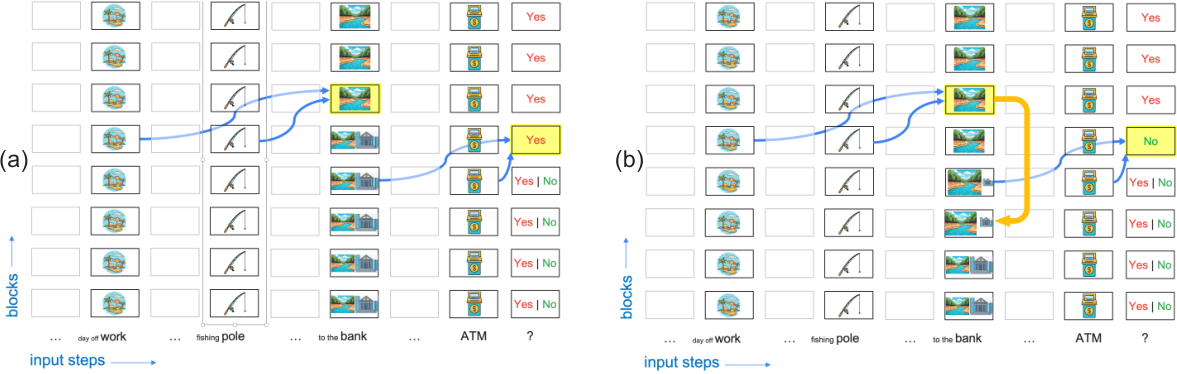
재순환은 그 개입을 모든 토큰에, 조금만, 추론 순간에 한다. 벡터를 갈아 끼우지 않는다. 깊은 층 활성화를 정규화해 얕은 층과 섞는다. 잔차 스트림이 공유 칠판처럼 층을 정렬해 두었기 때문에, 별도의 어댑터나 교차 어텐션 없이 1:1로 섞을 수 있다는 가설이다. 가중치를 안 건드린다. 하이퍼파라미터는 출처 층, 목적지 층, 혼합 계수 α다. Gemma3 1B·4B·12B PT의 튜닝셋에서 고른 쌍은 각각 {11, 4}, {18, 9}, {35, 16}이다.
주요 내용 분석
루핑이 아닌 이유
같은 화살표를 그려도 펼치는 방식이 다르다. 루핑은 깊이 방향으로만 순환한다. 상태를 한 스텝 갱신하려면 한 층 더 위로 가야 한다. 재순환은 깊이와 입력 스텝을 같이 펼친다. 같은 층이 z(t)와 z(t+1)을 모두 쥘 수 있다. 대가는 프리필을 토큰마다 직렬로 돌려야 한다는 점이다. 시퀀스 전체가 주어져도 병렬화가 안 된다. 생성 단계에서는 두 스택을 나란히 돌리는 비용이 현대 하드웨어에서 거의 묻힌다고 적는다. 이 글의 실험은 모두 한 번 더 도는 변체다. 무한히 돌리면 진짜 순환망이 된다고 한다. 그 변체는 아직 안 잰다.
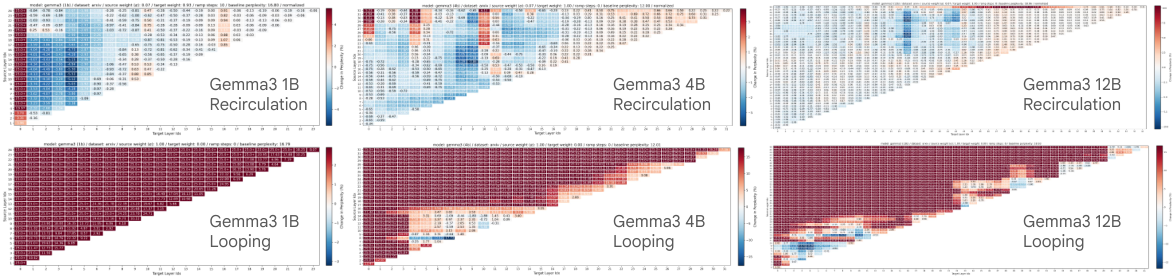
히트맵의 결이 다르다. 재순환은 세 규모 모두에서 파란 구역이 있다. 루핑은 1B에서 거의 전 구간이 붉고, 큰 모델에서만 파란 섬이 조금 뜬다. 논문은 그 질적 차이를, 두 기법이 다른 원리로 돈다는 증거로 읽는다. 학습 없는 루핑이 다른 논문에서 이득을 냈다는 문헌은 인용한다. Gemma3 패밀리에서는 그 이득이 안 붙는다고 적는다.
퍼플렉서티와 GSM8k
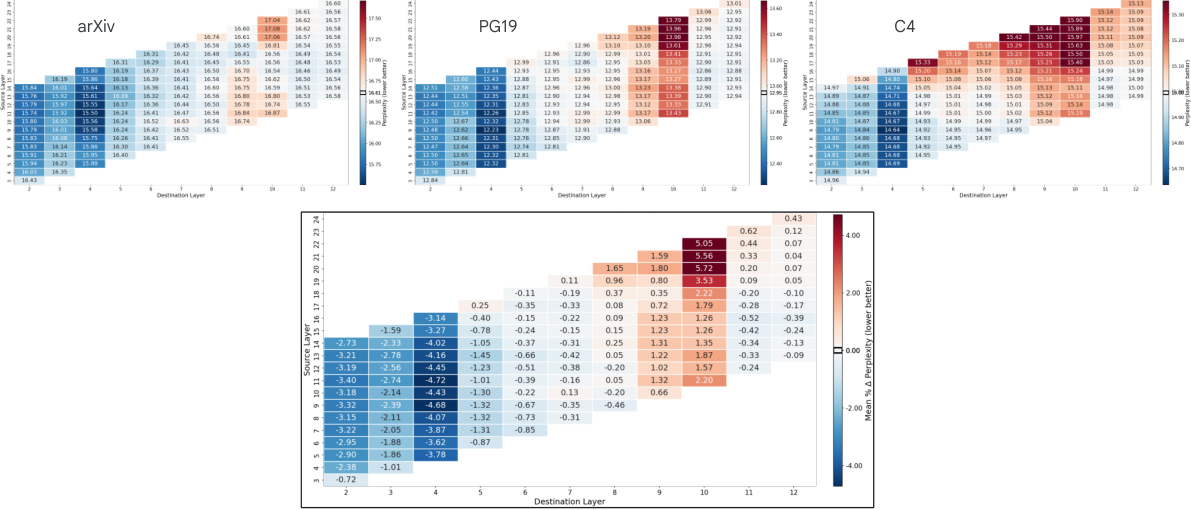
튜닝 스윕의 4.72%는 작은 창의 숫자다. 평가 분할로 옮기면 표가 커진다. Table 1은 열 개 언어 모델링 셋, α=0.15, Gemma3 1B·4B·12B PT다. 1B와 4B는 최대 약 16% 감소, 12B는 PG19에서 35.40%다. 아홉 셋에서 규모를 가로질러 이득이 있다. lambada만 예외다. 짧은 시퀀스와 토큰화 유물 때문이라고 적는다. 뒤에 재순환의 이득이 긴 시퀀스에서 더 크다고 한다. 12B의 언어 모델링이 약하다는 주석도 본문이 먼저 단다. 인스트럭션 튜닝 뒤 다운스트림은 강하다고 Gemma Team 2024를 가리킨다.
온도만 만져서 퍼플렉서티가 떨어지는지 본다. Gemma3 1B, 온도 1.2는 8.48% 감소다. 재순환 단독은 14.21%. 둘을 합치면 19.55%다. 거의 더해지므로, 재순환을 온도 조절로 환원하지 못한다고 적는다.
적응형은 그 다음 칸이다. 출처·목적지 층은 고정하고, 혼합 계수 α·β만 배운다. 토큰마다 벡터 계수를 내는 MLP가 최선이다. Gemma3 1B에서 아홉 평가 셋 평균 퍼플렉서티 감소는 23.0%다. 고정 재순환 8.5%, 모델 전체 파인튜닝 21.6%다. 아홉 셋 모두에서 적응형이 고정보다 낫다. 가중치는 그대로다. 과적합 위험이 파인튜닝보다 작다고 적는다. 다운스트림에서 MLP를 어느 셋으로 맞추느냐가 핵심이다. MMLU 테스트 일부로 맞추면 단일 토큰 과제에서 전반적으로 오르고, ARC Easy·Challenge로 맞추면 떨어진다.
GSM8k는 생성 과제다. 제로샷 생각 사슬 프롬프트, Gemma3 4B PT. 재순환은 pass@1과 pass@128을 모두 올린다. 적응형은 오차율을 pass@1에서 8.8%, pass@128에서 20.9% 줄인다. 초록의 “정확도 21% 증가”는 이 칸을 반올림한 읽기로 본문과 맞춘다. 절대 정답률 숫자는 본문 문장이 안 준다. Figure 12 막대만 있다. 이 글이 막대를 읽어서 채우지 않는다. 단일 토큰 과제(MMLU, ARC, BoolQ 등)의 이득은 소폭이다. 여덟 셋 중 여섯에서 고정 재순환이 베이스라인을 이긴다. 논문도 그 칸을 견고하다고 부르지 않는다. 긴 생성이 더 받는다는 문장이다.
다른 패밀리와 맥락화
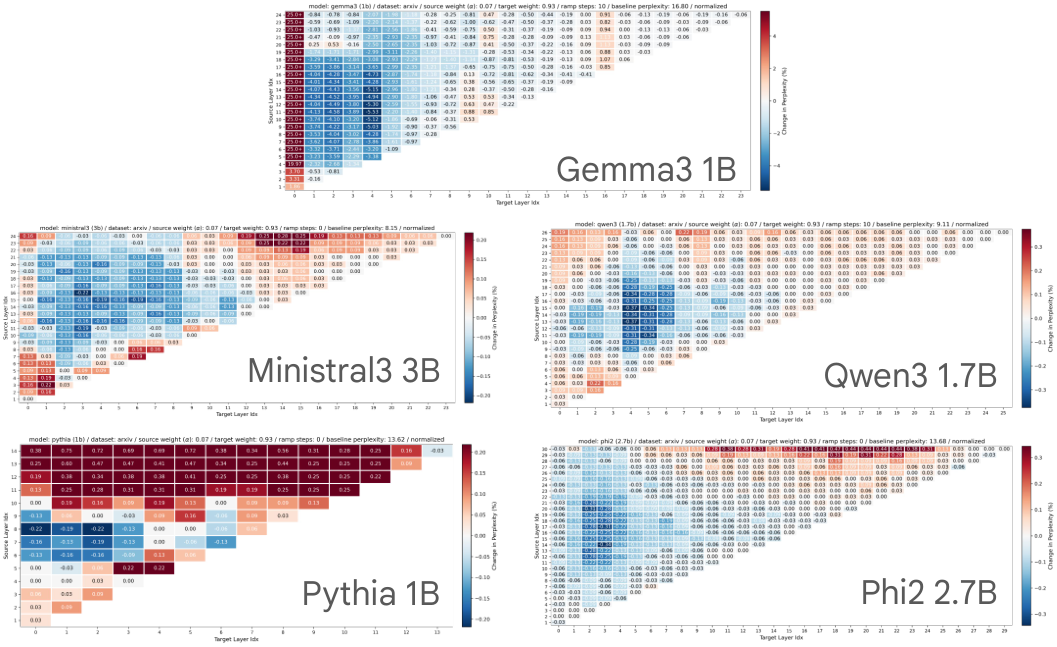
결은 같고 크기는 다르다. 다른 패밀리에는 α와 정규화를 다시 안 훑었다. 수용은 보편적으로 보이되, 크기는 구조와 학습 절차에 달린다고 적는다. 부록은 Gemma2와 Gemma4에서도 Gemma3만큼 뚜렷한 이득을 본다. 이 글의 주제는 Gemma 4 론치가 아니다. 같은 패밀리가 되먹임과 잘 맞는다는 부록 한 줄이다. Peri-LN과 학습 최적화가 후보라고 가설을 단다. 일반화는 더 봐야 한다고 못 박는다.
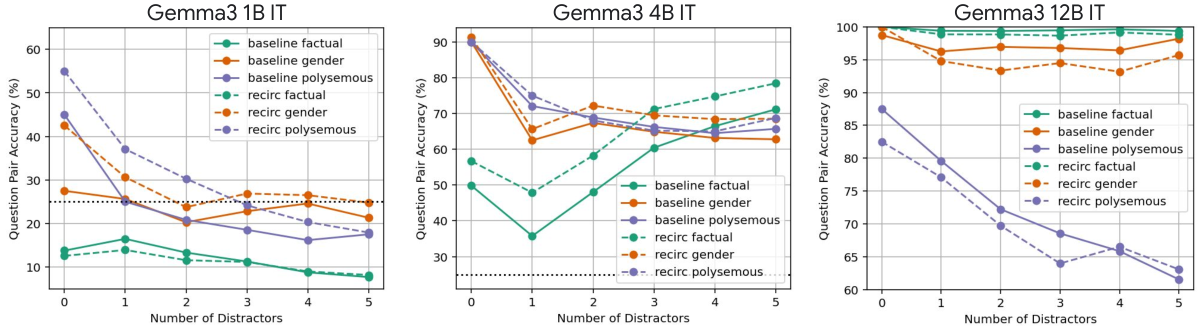
은행 대화의 후속 벤치다. 다의어·사실·성별 질문, 맞으려면 두 변체에 모두 답해야 해서 우연은 25%다. 1B는 세 유형 중 둘이 분명한 이득, 하나는 둘 다 우연. 4B도 둘이 이득. 12B는 둘이 손해, 하나는 천장이다. 균형으로는 이득이나 12B의 실패는 실망스럽다고 본문이 적는다. 하이퍼파라미터는 사전학습 모델의 퍼플렉서티 스윕에서 가져왔다. 인스트럭션 튜닝 모델로 다시 훑으면 이득이 커진다고 부록을 가리킨다. 인스트럭션 수행 과제에서는 퍼플렉서티로 고른 설정만으로 4B 오차율이 약 25%, 12B가 약 75% 줄었다. 과제에 맞춰 두 층 인덱스만 다시 고르면 더 오른다. 그 칸은 상한이지 일반화 숫자가 아니다.
| 칸 | 재순환 | 생각 사슬 (CoT) | 루핑 | 파인튜닝 |
|---|---|---|---|---|
| 무엇을 바꾸는가 | 추론 때 깊은 층 활성화를 얕은 층에 섞는다. 가중치는 그대로 | 출력 토큰으로 스스로 말하며 상태를 전달한다 | 같은 층을 여러 번 깊게 돈다 | 가중치를 다시 학습한다 |
| 상태 추적 | 깊이와 스텝을 같이 펼쳐, 같은 층이 z(t)와 z(t+1)을 쥘 수 있다 | 표현력을 키운다. 논문은 복잡한 추론에 남기라고 적는다 | 깊이가 늘 뿐, 무한 상태 추적을 보장하지 않는다 | 가능하나 학습이 비싸고 병렬을 포기한다 |
| 생성 지연 | 거의 그대로. 직렬 비용은 프리필 | 토큰이 늘어 지연이 붙는다 | 깊이가 늘면 연산이 는다 | 추론 자체는 그대로, 학습이 비용이다 |
| Gemma3에서 논문이 준 숫자 | 적응형 퍼플렉서티 평균 23.0% 감소. 초록 GSM8k 정확도 21% 증가. 본문 오차율 8.8%/20.9% | 같은 표의 대체 숫자가 아니다. GSM8k 평가가 CoT 프롬프트를 쓴다 | Gemma3에서 학습 없는 루핑은 견고한 이득이 없다고 히트맵 | 전체 파인튜닝 퍼플렉서티 21.6% 감소. 적응형 재순환 23.0% |
| 안 준 것 | 대형 컨텍스트에서 프리필 직렬 비용의 실측 초. 블록 단위 재순환의 K | 재순환을 켠 채 CoT를 끈 대조 표 | 학습한 루핑과의 정면 대결 | 다운스트림 전체의 파인튜닝 대조 |
표의 빈칸은 빈칸이다. 재순환은 생각 사슬·루핑과 보완 가능하다고 토론은 적는다. 대체가 아니다. 저자들은 당장 프론티어에 꽂을 삽이 아니라, 모델이 스스로 알려 주는 설계 여지(affordance)를 읽는 방법이라고 못 박는다.
실사용자 반응
이 글을 확인하는 2026-08-26 저녁(한국 시간) 기준, 이 논문 전용 Hacker News 스레드는 검색에서 잡히지 않았다. Algolia에서 2608.17981과 Recirculation+DeepMind+Gemma를 넣어도 해당 스토리가 없다. 방이 없다고 솔직히 적는다.
독립 정리는 있다. HuggingNews는 8월 23일(미국 동부 오전 11:29) 제목을 “Gemma 3 GSM8k 정확도 21%, 재학습 없이”로 단다. 퍼플렉서티 23%, 얼린 가중치, 가벼운 하이퍼파라미터 튜닝. 생성 비용은 그대로이고 직렬 일은 프리필에 앉힌다는 문장을 @omarsar0 분석을 키 소스로 붙인다. Crypto Briefing은 8월 24일 같은 초록 숫자를 옮긴다. 기본 재순환 약 8.5%, 적응형 23%, 파인튜닝 21.6%, GSM8k 상대 정확도 21%. 프리필이 직렬이 되어 앞단 비용이 오른다는 대가도 같이 적는다. 두 글의 헤드라인 숫자는 논문 초록·본문과 맞다.
Crypto Briefing은 GitHub 재현이 Gemma 밖 Llama 3.2 1B에서도 이득을 확인했다고 적는다. 이 글을 쓰는 시점에 그 저장소를 찾지 못했다. 논문 본문에도 Llama 3.2 1B 표는 없다. 2차 출처의 주장이므로, 레포를 열어 확인하기 전에는 인용하지 않는다. 확인되는 공학 흔적은 다른 칸이다. vLLM 이슈 #53401은 인과 디코더용 실험적 재순환 RFC다. 1차 범위를 Gemma 3 엔진으로 좁힌다. Llama는 후속 리뷰 후보로 묻는다. 로컬 프로토타입이 Gemma 3 1B 1,020 토큰에서 컴파일 퍼플렉서티 베이스라인 36.9618, serial 32.5482, wavefront 32.2460을 잰다고 적는다. 작은 고정 표본이지 표준 벤치가 아니라고 RFC가 먼저 단다. 논문 재현 전체가 아니다. 엔진이 관심을 보인 흔적이다.
의미와 시사점
실무자가 오늘 가져갈 문장은 가중치를 다시 받지 않고도, 같은 Gemma 3로 상태 추적을 조금 더 붙일 수 있다는 점이다. 추가 연산은 답이 나오기 전에 앉는다. 생각 사슬 토큰을 더 뽑는 비용이 아니다. 퍼플렉서티 23%와 GSM8k 21%는 적응형, Gemma 3, 논문이 고른 셋의 숫자다. 그 바깥으로 일반화하는 문장이 아니다.
경계는 넷이다. 첫째, 하이퍼파라미터는 과제에 따라 움직인다. 퍼플렉서티로 고른 층이 다운스트림에 옮겨 가기도 하고, 12B Racing Thoughts처럼 손해를 내기도 한다. 과제-보편 설정이 없으면 실용은 제한된다고 한계 절이 적는다. 둘째, Gemma 패밀리의 이득이 유난히 크다. 다른 패밀리는 같은 결의 파란 구역이 있지만 폭이 한 자릿수 작다. α와 정규화를 다시 안 훑은 칸이다. 셋째, 프리필 직렬 비용은 긴 컨텍스트에서 느릴 수 있다. 블록 단위 재순환(K개씩 병렬 처리 뒤 다음 K개와 같이 되먹임)은 제안만 있고 아직 안 잰다. 넷째, 단일 토큰 과제의 이득을 GSM8k와 한 줄로 접지 않는다. 본문이 그 차이를 먼저 단다.
저자들이 밀어 두는 칸은 철학이다. 임의의 구조를 제안하고 비싼 학습으로 증명하는 대신, 학습된 모델이 가중치를 안 바꾼 채 어디로 트위크되길 원하는지를 묻는다. 그 여지를 키우면 이후 학습의 귀납 편향이 단순해진다는 가설이다. 적응형 실험이 그 가설을 지지한다고 적는다. 삽으로 쓸 기법으로 안 판다.
마치며
DeepMind와 UT Austin은 기성 트랜스포머에, 추론 순간 되먹임을 넣었다. 같은 Gemma 3 가중치다. 적응형 재순환은 퍼플렉서티를 평균 23.0% 낮춘다. 전체 파인튜닝 21.6%를 웃돈다. GSM8k는 초록이 정확도 21% 증가, 본문이 오차율 8.8%·20.9% 감소다. 생성 지연은 거의 그대로다. 직렬 비용은 프리필이다. 생각 사슬도 루핑도 아니다.
다시 학습하지 않는다. 깊은 층이 이미 알고 있는 상태를, 얕은 층이 다음 토큰을 읽기 전에 보게 한다. 확인할 다음 칸은 헤드라인 퍼센트가 아니다. 과제-보편 층이 있는지, Gemma 밖에서도 폭이 살아나는지, 긴 프리필을 블록으로 나눴을 때 이득이 남는지다. Hacker News 전용 방은 아직 없다.
출처
- 논문 HTML: Recirculation (arXiv:2608.17981v1)
- 논문 PDF: arXiv:2608.17981
- HuggingNews (2026-08-23): Google DeepMind Recirculation Lifts Gemma 3 GSM8k Accuracy 21% Without Retraining
- Crypto Briefing (2026-08-24): Google DeepMind paper reveals recirculation method improves transformer context handling
- vLLM RFC: Experimental Recirculation for causal decoders (#53401)
- 선행: Lepori, Mozer, Ghandeharioun, Racing Thoughts, NAACL 2025
이 글은 AI가 작성하여 자동 발행된 콘텐츠입니다.