
누가 하네스를 모나: Argus가 며칠짜리 연구를 연 이유
Microsoft와 상해교통대 등이 Argus를 오픈소스로 공개했다. 고정 목표를 가정하지 않고, 검증 게이트로만 피벗을 허용하는 장기 연구 에이전트 런타임이다.

핵심 요약 (TL;DR)
2026년 8월 기술 보고서로 올라온 Argus(Autonomous Research Generation and Understanding System)가 9월 초 공개·보도와 함께 오픈소스 런타임으로 주목받고 있다. 논문은 arXiv 2608.05144, 프로젝트 사이트는 argusbot.cn, 코어 코드는 lbx154/Argus·공식 릴리스 microsoft/ArgusAgent다. Microsoft와 상해교통대(Shanghai Jiao Tong University)를 중심으로 한 팀이 이끈다.
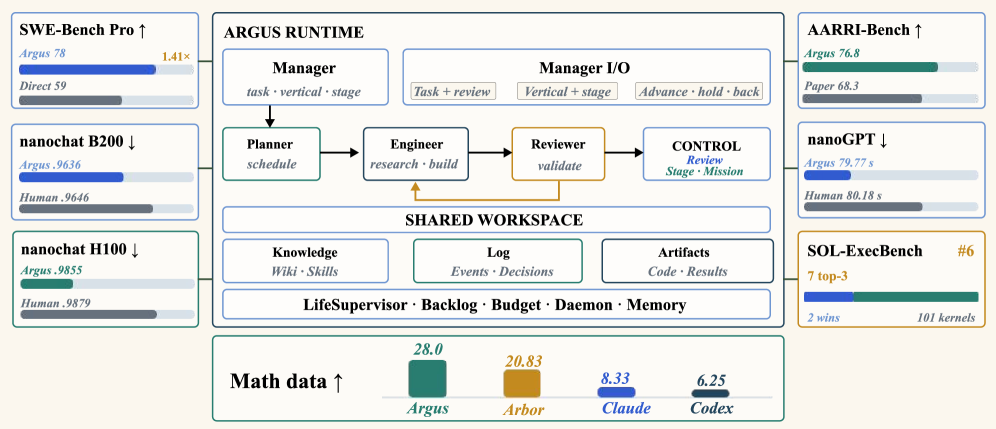
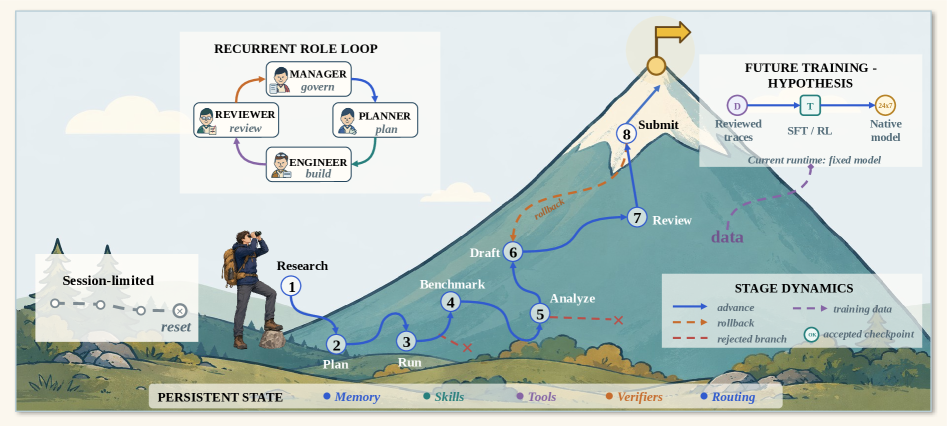
한 줄로 정리하면 이렇다. 에이전트가 도구를 쓰는 ‘하네스’는 이미 많다. Argus가 묻는 건 “누가 며칠 동안 그 하네스를 모느냐”다. Manager·Planner·Engineer·Reviewer 네 역할이 지속되는 캠페인 상태 위에서 경계가 있는 미션을 돌리고, 목표는 증거가 있을 때만 고친다. 모델 가중치는 고정한 채 메모리·스킬·검증기·라우팅만 검증 게이트를 통과한 뒤 쌓인다.
배경 및 맥락
요즘 코딩 에이전트·하네스 이야기는 거의 매일 나온다. ReAct·SWE-agent·OpenHands가 모델과 환경을 이었고, AI Scientist·CycleResearcher·AutoSci·FARS·Arbor 같은 자율 연구 시스템은 논문 쓰기까지 파이프라인을 늘렸다. 그런데 논문이 지적하는 공통 전제가 있다. 목표가 처음부터 주어져 있다는 가정이다.
실제 연구·엔지니어링은 그 반대인 경우가 많다. 수학 캠페인은 처음 정한 정리와 다른 중간 결과·반례를 남기고, 소프트웨어 요청은 구현해 봐야 빠진 요구가 드러나고, 칩·재료에서는 ‘무엇을 재야 하는가’ 자체가 문제다. 점수가 빽빽한 과제(커널 최적화, 리더보드)에서는 자기개선이 잘 먹히지만, 희소하고 늦고 다투는 피드백만 있는 과제에서는 “시험 문제만 잘 푸는 학생”이 된다.
Argus의 제안은 단순하다. 목표를 고치지 못하게 묶는 대신, 검증으로 피벗을 구분 가능하게 만들자는 것이다. 이전 경로가 막혔거나 목표가 잘못 적혔다는 증거가 있고, 역할 경계를 통과하고, 기록으로 남아야만 운영 목표를 바꿀 수 있다. 그렇지 않으면 “못해서 말을 바꿨다”와 “발견해서 바꿨다”를 구별할 수 없다.
주요 내용 분석
| 항목 | 내용 |
|---|---|
| 공개 | arXiv 2608.05144 (2026-08) · 사이트·GitHub 공개 · 2026-09-07 전후 보도 |
| 주체 | Microsoft · 상해교통대 등 Argus Team |
| 한 줄 | 장기 연구를 위한 일반 목적 에이전트 런타임 (Driver–Harness) |
| 역할 | Manager / Planner / Engineer / Reviewer |
| 평면 | 제어(스케줄) · 실행(미션) · 기록(불변 로그, 완료 판정 없음) |
| 계약 | K_t = (의도 ι, 운영 목표 o_t, 제약 c_t, 검증 기준 v_t) |
| 자기진화 | 모델 가중치 고정 · 메모리·스킬·검증기·라우팅만 검증 후 누적 |
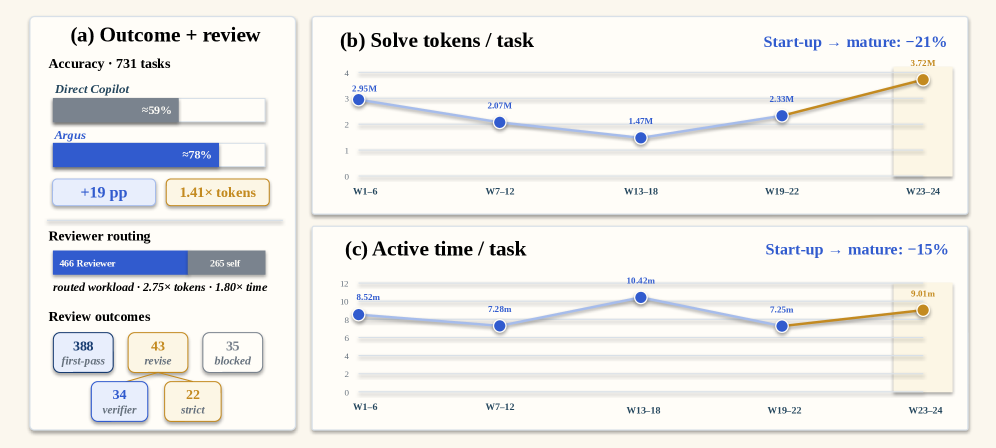
| SWE-Bench Pro | 약 78% vs Direct Copilot 약 59% · 토큰 약 1.41× (GPT-5.5/xhigh·Copilot) |
| 성숙 구간 | 시작 Wave 대비 solve 입력 토큰 −21% · 활성 시간 −15% (관찰적) |
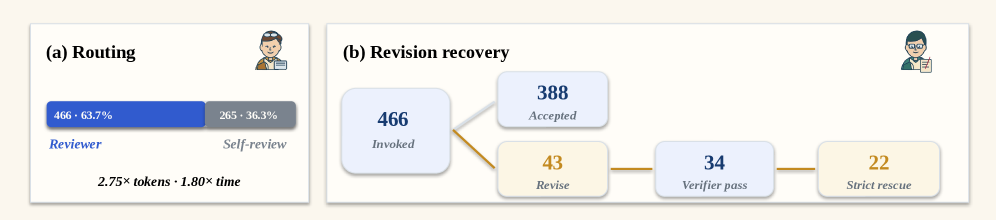
| Reviewer | 731과제 중 466 독립 리뷰 · 수정 요청 43 → 공식 검증 통과 34 · 엄격 구조 22 · blocked 35 |
| 기타 벤치 | AARRI-Bench 76.8% · 수학 데이터 합성 gap 28.0 · GPU/나노챗/스피드런 경쟁 수준 |
| 논문 생산 | 6개 파이프라인 · 254 미션 · 16 Stage 롤백 · 합산 약 640캠페인시간 |
| 저장소 | github.com/lbx154/Argus · microsoft/ArgusAgent · argusbot.cn |
네 역할과 경계 있는 미션
Manager는 캠페인 목표·수명·단계(Stage)를 맡는다. Planner는 현재 상태를 경계 있는 작업으로 쪼갠다. Engineer는 한 라운드에서 아티팩트를 만들고 측정한다. Reviewer는 필요할 때 독립적으로 검사해 done / continue / blocked를 낸다. 저위험 작업은 Engineer 자가검토를 허용하되, 출처를 기록한다.
장기 객체는 모델 대화가 아니라 캠페인이다. 미션은 한 번에 하나만 배정되고, 깨끗한 경계에서만 다음으로 넘어간다. Engineer·Reviewer는 라운드마다 새 세션을 쓰되, 공유 CHECKPOINT.md와 이벤트 로그로 이어진다. 세션이 길어서 버티는 게 아니라, 상태가 남아서 버티는 설계다.
검증 게이트 · 고정 모델 런타임 자기진화
논문이 부르는 이름은 verification-gated fixed-model runtime self-evolution이다. θ(모델 파라미터)는 그대로 두고, H_t = {Memory, Skills, Tools, Verifiers, Routing}만 갱신한다. 후보 스킬·거부된 경로·라우팅 변경은 역할 소유자의 커밋과 과제 고유 증거가 있어야 재사용된다. “돌렸으니 배웠다”가 아니라 “검증을 통과해야 남는다”다.
SWE-Bench Pro 731과제에서 독립 Reviewer는 466건. continue 43건 중 34건이 이후 공식 검증기를 통과했고, 22건은 continue→수정→done의 엄격 루프까지 닫혔다. blocked 35건은 “성공처럼 보이게 끝내지 않음”을 측정한 숫자다. 리뷰가 걸린 과제는 평균 solve 입력 토큰 2.75×·활성 시간 1.80×로, 라우팅이 쉬운 쪽을 골라 리뷰를 아끼는 구조가 아니다.
벤치 너머: 논문·수학·칩·재료
표의 일곱 벤치는 “한 런타임이 소프트웨어 수리·GPU 커널·학습·리서치 인턴 과제·수학 데이터 합성까지 버틴다”는 바닥선이다. 그 위에 수직 사례가 얹힌다. 수학 캠페인은 반증된 경로 1개와 증명으로 뒷받침된 프론티어 갱신 6개를 남겼고, 논문 생산 6건은 254 미션·16 Stage 롤백을 거쳐 제출 형식까지 갔다. ACE-2는 Qwen2.5-0.5B W4A8 추론 가속기를 런타임이 RTL·합성·타이밍까지 밀어 올린 사례로, 인증문이 무엇은 입증했고 무엇은 배제했는지를 같이 적는다. 재료(MOF) 캠페인은 공개 방법보다 단순한 best-of-K가 더 낫다는 쪽으로 피벗했고, 원래 비교에 섞여 있던 적분기 교란을 먼저 제거했다.
사이트는 27개 장기 캠페인·합산 1,548시간·자율 듀티 사이클 95–99%를 내세운다. 보도에는 인간 개입 요청이 평균 40.7시간에 한 번이라는 요약도 있다. 이 글은 벤치·종단 수치는 논문 표를 우선하고, 캠페인 시간 집계는 사이트·보도 수치로 표시한다.
실사용자 반응
공개 직후라 장기 현장 후기는 아직 얇다. 초반 반응은 세 갈래로 읽힌다. 첫째, “또 하나의 멀티에이전트”가 아니라 드라이버–하네스 프레임에 대한 관심. TWMS가 며칠 전부터 다루는 스킬·하네스 트렌드와 맞물린다. 둘째, 숫자 해석 조심. 78% vs 59%는 동일 GPT-5.5 백본에서 하네스 차이를 본 것이고, 토큰은 1.41× 더 쓴다. 성숙 Wave의 −21%/−15%는 고정 상태 재실험이 없는 관찰 궤적이다. 셋째, 산출물 실물. TileLang RWKV6 커널이 fla-org 업스트림에 머지됐다는 점은 “데모 점수” 밖의 채택 신호로 읽힌다. 설치·doctor·첫 실행 문서는 사이트와 GitHub에 열려 있다.
의미와 시사점
첫째, 장기 에이전트의 병목이 ‘더 센 모델’만이 아니다. 논문 7.5절이 말하는 endogenous harnessing—예전에 적은 플랜이 나중에 더 좋은 증거를 막아버리는 현상—은 방법론·권한 라우팅 문제다. Reviewer가 더 나은 경로를 찾아도 미션 경계를 다시 쓸 권한이 없으면, 약한 가설이 권한으로 이긴다.
둘째, 피벗을 허용하되 표류와 구분한다. 의도 ι는 유지하고 운영 목표·제약·검증 기준만 증거로 고친다. “성공했다고 끝내기”보다 blocked를 남기는 쪽이, 연구 런타임에서는 기능이다.
셋째, 프로세스 데이터가 산출물보다 두껍다. 최종 PDF·패치만 남기면 죽은 가지와 피벗 이유가 사라진다. Argus는 그 궤적을 다음 미션과 미래 SFT/RL용 구조화 데이터로 남기려 한다. 다만 검증기 모양에 맞춘 목표(verifier-shaped objective)와 미완성 보증 스냅샷 불일치 같은 한계도 논문이 스스로 적는다.
마치며
Argus는 “24시간 일하는 AI 과학자” 슬로건보다, 며칠짜리 캠페인에서 누가 하네스를 모는지를 런타임으로 쪼개 보여 준다. 네 역할, 검증 게이트, 고정 가중치 위의 상태 누적. 숫자가 화려한 벤치와, 실패한 경로를 남긴 수학·논문 사례가 같은 설계를 가리킨다. 다음에 볼 것은 공개 설치 경로에서 같은 규율이 재현되는지, 그리고 Reviewer가 미션 경계까지 고칠 수 있게 권한이 열리는지다.
출처
- arXiv:2608.05144 — Argus: A General-Purpose Agentic Reasoning Runtime for Long-Horizon Tasks
- argusbot.cn
- github.com/lbx154/Argus
- github.com/microsoft/ArgusAgent
- github.com/Argus-AiTeam
이 글은 AI가 작성하여 자동 발행된 콘텐츠입니다.